InfiniBand vs. Ethernet für AI-Fabrics
Für die meisten AI-Fabrics Ethernet. Für latenzkritisches HPC InfiniBand. Modernes Ethernet mit RoCEv2 betreibt heute Produktions-Fabrics mit 400G und 800G auf offener Multi-Vendor-Hardware, und OcNOS-DC liefert das bereits heute. Dieser Leitfaden zeigt, wo sich beide jeweils noch eignen.
Dieselben GPUs, zwei sehr unterschiedliche Netzwerke
Links eine Single-Vendor-InfiniBand-Fabric: ein Silizium-Anbieter, eine Switch-Linie, ein NIC-Ökosystem und ein Subnet-Manager, der vom Rest des Rechenzentrums getrennt ist. Rechts eine offene Multi-Vendor-Ethernet-Fabric: RoCEv2-NICs beliebiger Anbieter, Broadcom-Switch-Silizium, OcNOS-DC als NOS und dieselben Protokolle, die Sie bereits betreiben.
InfiniBand und Ethernet, Achse für Achse
InfiniBand wurde gezielt für latenzarmes, verlustfreies RDMA entwickelt, und zwei Jahrzehnte lang verschaffte ihm das einen echten Vorsprung bei eng gekoppeltem HPC. Modernes Ethernet, aufgebaut auf dem DCB-Stack, RoCEv2 sowie zunehmend DLB und UEC, hat diesen Abstand in den letzten Jahren geschlossen. Welche Lücken noch relevant sind, hängt vom Workload ab.
| Kriterium | InfiniBandSingle-Vendor | EthernetRoCEv2 / UEC, offen |
|---|---|---|
| Latenzuntergrenze | Sehr geringe End-to-End-Latenz von NIC zu NIC: typischerweise einige hundert Nanosekunden pro Switch-Hop. | Höhere Untergrenze als IB um mehrere hundert Nanosekunden, jedoch deutlich unterhalb der Schwelle, die die meisten verteilten Trainings-Collectives im großen Maßstab beeinträchtigt. |
| Verlusttoleranz | Lossless durch Architektur (Credit-based Flow Control). | Lossless über PFC + ECN + DCQCN. Schon heute produktionsreif; UEC reduziert die Abhängigkeit von PFC-Pause weiter. |
| Multipath / Lastverteilung | Adaptive Routing in der Spezifikation integriert. | Statisches ECMP, dazu DLB für überlastungsbewusstes Single-Hop-Balancing, GLB (OcNOS 7.1) für End-to-End und UEC-Packet-Spray für die nächste Generation. |
| Anbieter-Ökosystem | Effektiv Single-Vendor für NIC- und Switch-Silicon zugleich. | Multi-Vendor auf jeder Ebene: ASIC, Switch, NIC, NOS, Optik. UEC ist explizit für herstellerneutrale Interoperabilität konzipiert. |
| Betriebsmodell | Subnet Manager. Anders als der Rest des DC. Separate Skills, separates Tooling. | Dieselben BGP, EVPN, gNMI, die Sie bereits einsetzen. Dieselben Automatisierungstools (Ansible, NETCONF, OpenConfig) wie im übrigen DC. |
| Mandantenfähigkeit | Eingeschränkt; Partitionierung existiert, ist aber kein First-Class-Konzept. | Erstklassig über EVPN-VXLAN. GPU-as-a-Service, Multi-Team-Cluster, gemeinsam genutzte Infrastruktur, alles ganz natürlich. |
| Long-Haul-DCI | Nicht dafür ausgelegt; benötigt IB-over-WAN-Gateways. | Nativ über 400G ZR/ZR+ Coherent-Pluggables und EVPN Inter-DC. |
| Storage-Konvergenz | Storage läuft neben Compute; benötigt IB-angebundenen Storage. | NVMe-oF, NFS, S3 alle über dieselbe Ethernet-Fabric. |
| Roadmap-Geschwindigkeit | Bestimmt durch den Release-Takt eines einzigen Anbieters. | Das UEC-Konsortium, dessen Mitglieder aus den Bereichen Silicon, NIC, Switch und Cloud stammen, treibt eine offen veröffentlichte Weiterentwicklung der Spezifikation voran. |
Wo jeweils die Stärken liegen
Die richtige Antwort ist workload-spezifisch. Wählen Sie InfiniBand, wo eine absolute Latenzuntergrenze gefordert ist; wählen Sie Ethernet, wo Betriebsmodell, Kosten oder die Reichweite über Standorte hinweg den Ausschlag geben.
Die Latenzuntergrenze ist vertraglich festgelegt
HPC-Simulation, bei der die absolute Latenzuntergrenze wichtiger ist als die Total Cost of Ownership, sowie eng gekoppelte, dedizierte Single-Tenant-Cluster, bei denen ein Lock-in akzeptabel ist.
Das Betriebsmodell zählt
Mandantenfähiges GPU-as-a-Service und Cluster, die sich die Infrastruktur mit dem Rest des Rechenzentrums teilen, wo ein einziges Betriebsmodell, ein Tooling-Stack und eine Multi-Vendor-Lieferkette überzeugen.
Die Kosten pro GPU-Flop sind entscheidend
OcNOS-DC läuft auf offener Hardware mehrerer Hersteller, sodass die Switch-Hardware im Wettbewerb beschafft werden kann.
Die Fabric erstreckt sich über mehrere Rechenzentren
Wenn ein Trainingslauf jemals zwei Hallen oder zwei Regionen überspannt, erweitern kohärentes DCI, EVPN Inter-DC und standardisierte Multi-Vendor-Optik dieselbe Ethernet-Fabric über Standorte hinweg.
Was modernes Ethernet hinzugefügt hat
Drei Entwicklungen haben produktive AI-Fabrics auf Ethernet gebracht: echtes verlustfreies Verhalten, Load Balancing, das Flows von überlasteten Uplinks fernhält, und ein Spray-freundlicher Transport der nächsten Generation.
Verlustfreies Verhalten
RoCEv2 mit PFC, DCQCN und die PFC-Deadlock-Erkennung und -Wiederherstellung liefert den verlustfreien RDMA-Transport, den AI-Collectives benötigen, heute produktionsreif auf Standard-Ethernet.
Dynamisches Load Balancing
Statische ECMP-Kollisionen bei AI-Workloads sind real, aber DLB verteilt Flowlets bei lokaler Überlastung neu, und GLB in OcNOS 7.1 erweitert das um ein Ende-zu-Ende-Path-Scoring.
Spray-freundlicher Transport
Ultra Ethernet (UEC 1.0, Juni 2025) bringt Packet Spray, Multi-Path-RDMA und Out-of-Order-Zustellung auf Standard-Ethernet. Bauen Sie jetzt auf RoCEv2 auf und planen Sie UEC ein, sobald UEC-fähige NICs verfügbar sind.
Das Netzwerk ist ein kleiner Posten, daher lohnt der Vergleich vor allem dort, wo es Mittel freisetzt
- OcNOS-DC läuft auf offener Hardware mehrerer Hersteller, sodass die Switch-Hardware im Wettbewerb beschafft werden kann.
- Das eingesparte Kapital finanziert mehr GPUs, eine größere Storage-Ebene oder einen zweiten Standort für mehr Ausfallsicherheit.
- Wo die Fabric mandantenfähig ist oder mit dem Rest des Rechenzentrums geteilt wird, ist ein einheitliches Netzwerkmodell mehr wert als der Kostenunterschied im Einzelposten.
Beide haben ihren Platz, und die meisten AI-Fabrics gehören auf Ethernet
Ethernet gewinnt nicht jeden Workload, doch die betrieblichen und wirtschaftlichen Argumente sind für die meisten entscheidend, und sie werden stärker, je weiter sich der technische Abstand schließt.
Beide haben ihren Platz
Ethernet gewinnt nicht jeden Workload. Eng gekoppelte HPC-Cluster mit Anforderungen an eine absolute Latenzuntergrenze bevorzugen weiterhin InfiniBand.
Die meisten AI-Fabrics gehören auf Ethernet
Produktives AI-Training und Inferenz im Hyperscale-Bereich wandern zu Ethernet, da die betrieblichen und wirtschaftlichen Argumente wachsen und sich der technische Abstand weiter schließt.
OcNOS-DC ist der offene Weg
RoCEv2 und DLB heute, GLB in OcNOS 7.1. Ein NOS auf qualifizierter offener Hardware von Edgecore, UfiSpace und anderen.
InfiniBand vs. Ethernet, beantwortet
Ist Ethernet für das AI-Training im Vergleich zu InfiniBand schnell genug?
Wann sollte weiterhin InfiniBand gewählt werden?
Wann ist Ethernet für eine AI-Fabric die bessere Wahl?
Wie schließt OcNOS die Lücke zu InfiniBand?
Ersetzen Hyperscaler InfiniBand durch Ethernet für AI?
Was ist die beste Alternative zu InfiniBand für die Vernetzung von AI-Clustern?
Worin unterscheiden sich Ultra Ethernet und InfiniBand?
Wie viel kostet eine Ethernet-AI-Fabric im Vergleich zu InfiniBand?
Tiefer einsteigen. Zum Mitnehmen.
Das Produktdatenblatt und kurze, technische Downloads, die über diese Seite hinausgehen.
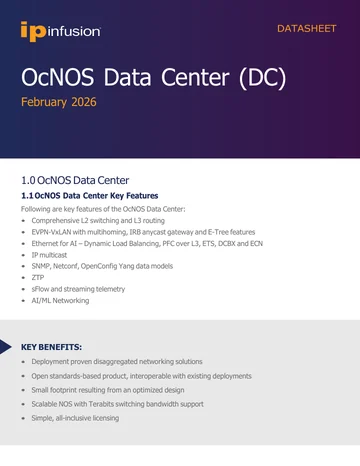
OcNOS-DC-Datenblatt
Vollständige OcNOS-DC-Spezifikation: Funktionsumfang für EVPN-VXLAN und Ethernet for AI, Software-SKUs, unterstützte Hardware-Plattformen und der Solution Ordering Guide.
Datenblatt abrufen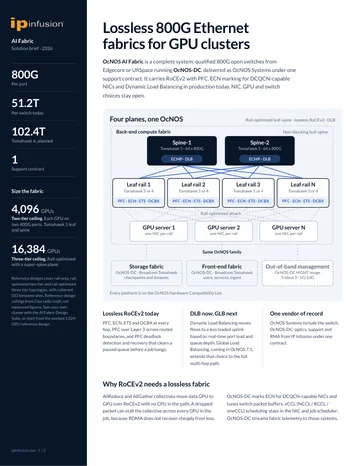
OcNOS: verlustfreie 800G-AI-Fabric
Verlustfreie RoCEv2-Fabric auf Tomahawk-5-Spines: SKU-Stufen, qualifizierte Plattformen und Deployment-Architektur.
Brief anfordern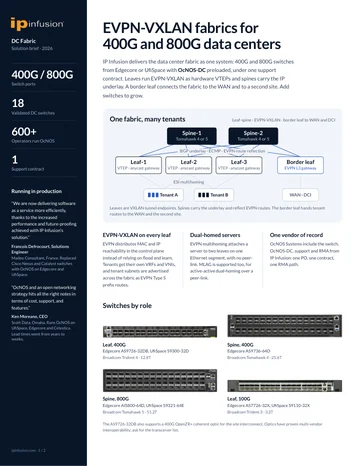
EVPN-VXLAN-Data-Center-Fabric
Leaf-Spine-Rechenzentrums-Fabric auf EVPN-VXLAN: eine VRF und VNIs pro Mandant, EVPN-Multihoming, BGP unnumbered und Route-Target-Filterung.
Brief anfordernOcNOS-DC-Datenblatt
Kurzes Formular. Ihr PDF öffnet sich unmittelbar nach dem Absenden in einem neuen Tab.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
OcNOS: verlustfreie 800G-AI-Fabric
Kurzes Formular. Ihr PDF öffnet sich unmittelbar nach dem Absenden in einem neuen Tab.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
EVPN-VXLAN-Data-Center-Fabric
Kurzes Formular. Ihr PDF öffnet sich unmittelbar nach dem Absenden in einem neuen Tab.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
Die gesamte AI-Fabric mit OcNOS entwerfen
Vom Business Case bis zur Portanzahl-Berechnung: Steigen Sie dort ein, wo Sie beim Aufbau gerade stehen.
Sie dimensionieren Ihren nächsten Cluster? Holen Sie sich eine workload-spezifische Bewertung
Nennen Sie uns den Workload und die GPU-Größenordnung, und ein IP Infusion-Ingenieur rechnet die Zahlen gemeinsam mit Ihnen durch, oder starten Sie mit einem ersten Leaf-Spine-Entwurf in der AI Fabric Design Suite.