So wählen Sie eine AI-Networking-Fabric
Ihre GPUs erreichen ihren Nenndurchsatz nur, wenn die Fabric darunter mithält. Dies ist ein herstellerneutrales Framework, um eine AI-Fabric vor der Unterschrift anhand der sechs Kriterien zu bewerten, die über sie entscheiden.
Betrachten Sie die Fabric als eine Entscheidung, die aus sechs besteht
Eine AI-Networking-Fabric wird einmal gekauft und über Jahre genutzt. Bewerten Sie sie daher danach, wie gut sechs Eigenschaften zu Ihrem Betrieb des Clusters passen, nicht nach einer einzelnen Schlagzeilenzahl. Drei Arten von Fabric stehen zur Wahl:
- Geschlossene Single-Vendor-Stacks bündeln NIC, Switch und Scheduler in einer SKU und legen die Kompromisse für Sie fest.
- Community- und Open-Source-NOS liefern Ihnen Code, überlassen Integration und Support aber Ihnen.
- Offene kommerzielle NOS erhalten die Wahlfreiheit bei der Hardware und bieten zugleich einen Supportvertrag.
Die folgenden Kriterien bewerten jede dieser Optionen zu denselben Bedingungen.
Performance und Verlustfreiheit
AI-Collectives nutzen RDMA, und RDMA braucht ein verlustfreies Substrat. RoCEv2 liefert dies auf Ethernet, aber nur mit dem vollständigen Congestion-Toolkit, nicht als Häkchen. Eine Fabric, die unter Last schlecht pausiert oder Pakete verwirft, ist die häufigste Ursache für ins Stocken geratenen Trainingsdurchsatz. Klären Sie dieses Kriterium daher zuerst.
Was Sie fragen sollten
- Liefern Sie die verlustfreie Ethernet-Fabric, die RoCEv2 erfordert, einschließlich PFC über L3 mit DCBX und LLDP?
- Ist ECN-Markierung vorhanden, und gibt es eine dynamische Variante, die Schwellenwerte unter Last anpasst?
- Gibt es PFC-Deadlock-Erkennung und -Wiederherstellung sowie WRED und Puffer-Tuning?
- Wie wird die Tail-Latency niedrig gehalten, wenn ein Link während eines Collectives heiß läuft?
So bewerten Sie
Fragen Sie nach den genauen Congestion-Funktionen und bestätigen Sie, dass sie auf dem Silicon laufen, das Sie kaufen. Eine glaubwürdige Antwort nennt PFC (auch über L3, mit DCBX und LLDP), ECN und Dynamic ECN, ETS, WRED, PFC-Deadlock-Erkennung und -Wiederherstellung sowie dynamisches Load Balancing, das Flows von heißen Links umverteilt. Ein statischer Hash kann große Flows auf einer Teilmenge der Links kollidieren lassen, während dynamisches Load Balancing auf Tomahawk 4 und Tomahawk 5 eine Fabric-Auslastung im Bereich von 90 % anstrebt. Behandeln Sie es daher als Durchsatzfunktion, nicht als nette Zugabe. Siehe den RoCE vs. InfiniBand Vergleich, wie sich das verlustfreie Modell von der Credit-basierten Flusskontrolle von InfiniBand unterscheidet.
Skalierung und Topologie-Eignung
Die richtige Topologie ist das kleinste nicht blockierende Design, das den Link jeder GPU während eines Collectives ausgelastet hält, mit einem sauberen Pfad zur nächsten Größe. Eine Topologie, die nicht wachsen kann, erzwingt später einen kompletten Austausch. Dimensionieren Sie daher für das Ziel des Clusters, nicht für seinen Ausgangspunkt.
Was Sie fragen sollten
- Ist die GPU-Plane 1:1 nicht blockierend, und wo beginnt die Oversubscription?
- Welches ist der größte Cluster, den dieses Design erreicht, bevor eine Ebene hinzugefügt werden muss?
- Unterstützt es Rail-optimierte Verkabelung und eine Super-Spine-Ebene für Multi-Pod-Skalierung?
So bewerten Sie
Ordnen Sie Kandidaten konkreten GPU-Anzahlen zu. Auf Tomahawk-5-Switches erreicht ein zweistufiges Leaf-Spine 4.096 GPUs bei 1:1 nicht blockierend mit 800G pro GPU, wobei jeder Switch als 128×400G betrieben wird und jede GPU an zwei 400G-Leaf-Ports angebunden ist. Darüber hinaus erweitert eine Super-Spine-Ebene über denselben Rail-optimierten Pods dies auf 16.000+ GPUs. Nutzen Sie Rail-optimierte Verkabelung für Single-Pod-Lokalität und ein Clos für Multi-Pod-Skalierung; die Referenztopologien zeigen die Port-Rechnung, und die AI Fabric Design Suite liefert eine erste Dimensionierung.
Offenheit und Lock-in
Eine geschlossene AI-Fabric bindet NIC, Switch und Scheduler an einen Lieferanten, der damit Ihre Preise und Ihre Roadmap festlegt. Ein offener Ansatz betreibt ein kommerzielles NOS auf Standard-Ethernet-Silicon von mehr als einem Hardwareanbieter, sodass Sie die Wahlfreiheit bei der Hardware behalten und eine Zweitquelle nutzen können. Hier entscheiden sich die Kosten über mehrere Jahre und Ihre Verhandlungsposition.
Was Sie fragen sollten
- Können Switch, NOS und Optiken jeweils unabhängig voneinander beschafft werden?
- Basiert die Fabric auf veröffentlichtem, standardbasiertem Ethernet oder auf einem proprietären Transport?
- Gibt es mehr als eine qualifizierte Hardwareplattform für dieselbe Software?
So bewerten Sie
Achten Sie auf eine qualifizierte Hardwareliste mit mehr als einem Anbieter dahinter. Offene kommerzielle NOS betreiben dieselbe Software auf Broadcom-Tomahawk-5-Plattformen verschiedener Hersteller, zum Beispiel Edgecore AIS800-64D und UfiSpace S9321-64E, sodass eine Zweitquelle real statt theoretisch bleibt. Im Gegensatz dazu stehen geschlossene Single-Vendor-SKUs aus NIC, Switch und Scheduler, deren Teile nur miteinander funktionieren. Die nützliche Frage lautet nicht Produkt gegen Produkt, sondern wie viele Lieferanten Sie für dieselbe Fabric in die Verantwortung nehmen können.
Betrieb, Automatisierung und Telemetrie
Eine Fabric, die sich schwer in Betrieb nehmen lässt oder im Produktivbetrieb blind ist, kostet mehr als ihr Preisschild. Das Betriebsmodell, also wie Sie provisionieren, beobachten und optimieren, ist ein erstrangiges Kaufkriterium, kein nachträglicher Gedanke, sobald die Hardware eintrifft.
Was Sie fragen sollten
- Gibt es Streaming-Telemetrie über gNMI mit OpenConfig-Modellen?
- Wird Zero-Touch Provisioning (ZTP) für die Inbetriebnahme der Fabric im großen Maßstab unterstützt?
- Lässt es sich mit Standardwerkzeugen wie Ansible automatisieren, und signalisiert es QoS mit DCBX?
So bewerten Sie
Lassen Sie sich Telemetrie und Automatisierung in der eigenen Dokumentation des Kandidaten zeigen, nicht auf einer Folie. Eine starke Antwort umfasst gNMI- und OpenConfig-Streaming-Telemetrie in Ihren Observability-Stack, ZTP für das Provisioning, DCBX und LLDP für die verlustfreie Signalisierung sowie Ansible-basierte Konfiguration. Es geht um Closed-Loop-Tuning während der Inbetriebnahme: Zähler pro Queue und Pufferzustand, die Sie beobachten können, während Sie PFC- und ECN-Schwellenwerte einregeln, keine Blackbox, die Sie einmal einstellen und auf das Beste hoffen.
Support und Verantwortlichkeit
Wenn ein Trainingslauf um 3 Uhr morgens hängen bleibt, lautet die Frage, wem die Behebung obliegt. Ein Multi-Vendor-Aufbau ohne einen einzigen verantwortlichen Vertrag führt zu gegenseitigen Schuldzuweisungen zwischen den Anbietern von NIC, Switch, Optiken und Software. Die Abhilfe ist ein Vertrag, nicht ein geschlossener Stack.
Was Sie fragen sollten
- Gibt es einen einzigen Supportvertrag, der Software und die qualifizierte Hardware abdeckt?
- Gibt es ein TAC und ein SLA oder mehrere, die koordiniert werden müssen?
- Wer hat die konkrete Hardware- und Softwarekombination validiert, die Sie kaufen?
So bewerten Sie
Trennen Sie Verantwortlichkeit von Lock-in: Sie wollen Single-Vendor-Verantwortlichkeit ohne Single-Vendor-Hardware. Das starke Muster ist offene Hardwarewahl kombiniert mit einer Supportvereinbarung, ein Vertrag für die Software plus die qualifizierte Hardware, ein TAC, ein SLA, sodass ein Fehler durchgängig in einer Hand liegt, obwohl Sie die Teile offen beschafft haben.
Standards und Roadmap
Der AI-Fabric-Transport entwickelt sich schnell. Das Ultra Ethernet Consortium (UEC) veröffentlicht einen offenen Multipath-Ethernet-Transport für AI und HPC, dessen Endpunktverhalten auf UEC-fähigen NICs läuft. Unterscheiden Sie daher, was jeder Anbieter heute produktiv betreibt, von dem, was er plant.
Was Sie fragen sollten
- Ist der Anbieter Mitglied des Ultra Ethernet Consortium?
- Was betreibt die Fabric heute produktiv, und auf welchem Silicon?
- Was steht auf der kurzfristigen Roadmap für Load Balancing und Congestion Control?
So bewerten Sie
Trennen Sie, was ausgeliefert wird, von dem, was geplant ist. IP Infusion ist Mitglied des Ultra Ethernet Consortium, und OcNOS-DC betreibt heute verlustfreies RoCEv2 mit PFC, ECN-Markierung und DLB im Produktivbetrieb auf Broadcom-Tomahawk-4- und Tomahawk-5-Switches. DCQCN läuft auf den NICs und reagiert auf diese ECN-Markierungen. Global Load Balancing (GLB) kommt mit OcNOS 7.1. Fragen Sie bei der Roadmap nach konkret benannten Punkten: latenzbasiertes ECN (7.1.0), Link-Level Retry, Credit-basierte Flusskontrolle und Packet Trimming. Siehe InfiniBand vs. Ethernet für einen Vergleich mit dem offenen Weg.
Die Checkliste für Käufer
Prüfen Sie jede Kandidaten-Fabric, ob geschlossener Single-Vendor-Stack, Community-NOS oder offenes kommerzielles NOS, anhand derselben Liste. Wenn sich ein Punkt nicht abhaken lässt, fragen Sie nach dem Grund, bevor Sie entscheiden, dass er keine Rolle spielt.
- Verlustfreies Substrat. RoCEv2 mit PFC (auch über L3, DCBX, LLDP), ECN und Dynamic ECN, ETS, WRED sowie PFC-Deadlock-Erkennung und -Wiederherstellung.
- Dynamisches Load Balancing. Flows werden von heißen Links umverteilt, nicht nur per statischem ECMP-Hashing.
- 1:1 nicht blockierende GPU-Plane. Keine Oversubscription in der GPU-Fabric, dimensioniert für Ihre Ziel-GPU-Anzahl mit Reserve bis zur nächsten Ebene.
- Topologie-Eignung. Rail-optimierte Single-Pod- und dreistufige Multi-Pod-Designs auf dem Silicon, das Sie kaufen.
- Hardwareauswahl. Mehr als ein qualifizierter Hardwareanbieter für dasselbe NOS, sodass eine Zweitquelle real ist.
- Offener Transport. Standardbasiertes Ethernet, kein proprietäres Bündel aus NIC, Switch und Scheduler.
- Telemetrie und Automatisierung. gNMI- und OpenConfig-Streaming-Telemetrie, ZTP, DCBX und Ansible.
- Ein verantwortlicher Vertrag. Eine einzige Supportvereinbarung für Software und Hardware, die als ein System gekauft werden, ein TAC, ein SLA.
- Standards-Roadmap. Der Anbieter ist Mitglied des Ultra Ethernet Consortium und benennt seine Roadmap-Punkte für Load Balancing und Congestion Control.
Wo offenes Ethernet mit OcNOS-DC passt
Lesen Sie die obigen Kriterien und wählen Sie, was für Ihren Cluster am besten abschneidet. Für Käufer, die offene Hardwarewahl mit einem einzigen verantwortlichen Vertrag wollen, zeigt dies, wie IP Infusion bei derselben Checkliste abschneidet, klar dargestellt, damit Sie es mit den Alternativen vergleichen können.
Produktive RoCEv2-Fabric
OcNOS-DC liefert die verlustfreie Ethernet-Fabric, die RoCEv2 erfordert, auf Broadcom Tomahawk 5: PFC über L3 mit DCBX und LLDP, ECN und Dynamic ECN, ETS, WRED, PFC-Deadlock-Erkennung und -Wiederherstellung sowie DLB mit reaktivem Path-Rebalancing.
4.096 bis 16.000+ GPUs
Ein zweistufiger TH5-Pod erreicht 4.096 GPUs bei 1:1 nicht blockierend mit 800G pro GPU; darüber hinaus erweitert eine Super-Spine-Ebene dies auf 16.000+ GPUs.
Multi-Vendor-Hardware
Ein NOS für Tomahawk-5-Plattformen von mehr als einem Hersteller, darunter Edgecore AIS800-64D sowie UfiSpace S9321-64E und S9321-64EO mit 400G ZR+, sodass eine Zweitquelle real bleibt.
Offene Telemetrie und Automatisierung
gNMI- und OpenConfig-Streaming-Telemetrie, ZTP, DCBX und Ansible, mit RTAG7-Hashing und Puffer-Tuning für eine Closed-Loop-Inbetriebnahme.
OcNOS Systems: ein Vertrag, ein TAC, ein SLA
Mit OcNOS Systems deckt eine einzige Vereinbarung mit IP Infusion die OcNOS-Software und die qualifizierte Hardware ab, sodass Sie Single-Vendor-Verantwortung ohne Single-Vendor-Lock-in erhalten.
UEC-Mitglied, benannte Roadmap
IP Infusion ist Mitglied des Ultra Ethernet Consortium. GLB kommt mit OcNOS 7.1, und latenzbasiertes ECN ist auf dem OcNOS-7.1-Train für OcNOS-DC.
FAQ zum Einkaufsleitfaden für AI-Fabrics
Was sollte ich bei der Wahl einer AI-Fabric zuerst bewerten?
Ist Ethernet oder InfiniBand besser für AI?
Für wie viele GPUs muss ich planen?
Wie vermeide ich Vendor Lock-in?
Was bedeutet UEC für meinen Kauf?
Brauche ich einen Anbieter für Hardware und Software?
Die gesamte AI-Fabric mit OcNOS entwerfen
Vom Business Case bis zur Portanzahl-Berechnung: Steigen Sie dort ein, wo Sie beim Aufbau gerade stehen.
Tiefer einsteigen. Zum Mitnehmen.
Zwei kurze, technische Downloads, die weiter gehen als diese Seite: das vollständige OcNOS-DC-Datenblatt und die verlustfreie 800G-AI-Fabric-Architektur.
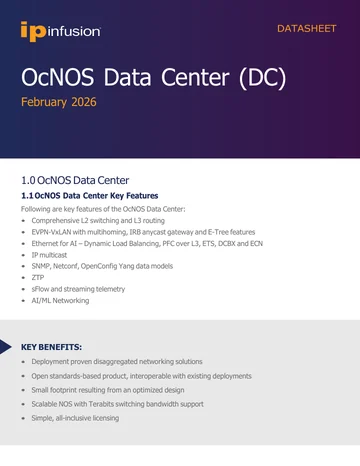
OcNOS-DC-Datenblatt
Vollständige OcNOS-DC-Spezifikation: Funktionsumfang für EVPN-VXLAN und Ethernet for AI, Software-SKUs, unterstützte Hardware-Plattformen und der Solution Ordering Guide.
Datenblatt abrufen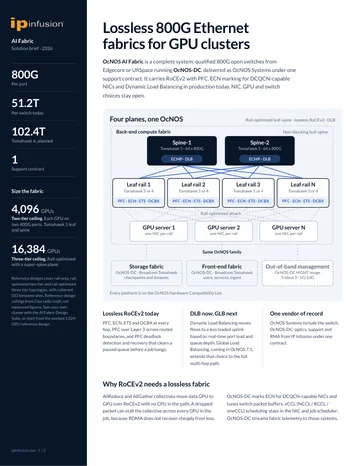
OcNOS: verlustfreie 800G-AI-Fabric
Verlustfreie RoCEv2-Fabric auf Tomahawk-5-Spines: SKU-Stufen, qualifizierte Plattformen und Deployment-Architektur.
Brief anfordernOcNOS-DC-Datenblatt
Kurzes Formular. Ihr PDF öffnet sich unmittelbar nach dem Absenden in einem neuen Tab.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
OcNOS: verlustfreie 800G-AI-Fabric
Kurzes Formular. Ihr PDF öffnet sich unmittelbar nach dem Absenden in einem neuen Tab.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.