Rail-optimierte Netzwerktopologie für AI-Fabrics
Ein rail-optimiertes Netzwerk platziert eine NIC jedes GPU-Servers mit 8 NICs auf jedem von 8 Rails und macht jedes Rail zu einem eigenen dedizierten Leaf, sodass das dominierende Intra-Rail-AllReduce auf einem Leaf bleibt und nie die Spine erreicht. Es ist eine Disziplin der Verkabelung und Verkehrslokalität, kein Mittel zur Reduzierung der Spine-Anzahl: Die Spine bleibt 1:1 blockierungsfrei und trägt nur den Cross-Rail-Rest. Aufgebaut auf OcNOS-DC über verlustfreiem RoCEv2 auf Broadcom Tomahawk 5.
Was rail-optimiert bedeutet und wie es sich von Rail-only unterscheidet
Moderne GPU-Server werden mit 8 NICs ausgeliefert. Ein Rail ist eine NIC-Position, die von jedem Server übernommen wird: NIC-1 jedes Servers bildet Rail-1, und so weiter bis Rail-8. Rail-optimiert weist jedes Rail seinem eigenen dedizierten Leaf zu, sodass jeder Server eine Verbindung zu jedem der 8 Rail-Leaves hat.
Der Gewinn ist Lokalität: xCCL-Bibliotheken planen das dominierende AllReduce innerhalb eines einzelnen Rails, und da dieses Rail ein Leaf ist, verlässt der Traffic das Leaf nie. Nur der kleinere Cross-Rail-Rest erreicht die Spine. Rail-optimiert ist eine Disziplin der Verkabelung und Verkehrslokalität, kein Mittel zum Verkleinern der Spine, die 1:1 blockierungsfrei bleibt.
- Rail-only behält die rail-ausgerichteten Leaves bei, verzichtet aber auf die Spine-Ebene, sodass Cross-Rail-Traffic auf die serverinterne GPU-Scale-up-Domäne statt auf einen Netzwerkpfad angewiesen ist. Günstiger für eine Handvoll Racks, aber ohne Fabric-Route für Cross-Rail-Flows, sobald der Cluster über eine Scale-up-Domäne hinauswächst.
- Rail-optimiert fügt oberhalb der Rail-Leaves eine 1:1 blockierungsfreie Spine hinzu und gibt Cross-Rail-Flows einen echten Netzwerkpfad. Es ist die standardmäßige skalierbare Einheit für einen einzelnen Pod; Rail-only ist der Einstiegspunkt darunter.
Rail-Ausrichtung hält das heiße Kollektiv lokal
Verteiltes Training wird von Kollektiven wie AllReduce zur Gradientensynchronisierung dominiert, die über xCCL-Bibliotheken (NCCL, RCCL, oneCCL) ausgeführt werden. Rail-Ausrichtung platziert GPUs desselben Rangs auf einem gemeinsamen Leaf, sodass diese Kollektive im Regelfall mit der geringsten Hop-Anzahl und ohne Spine-Transit abgeschlossen werden. Das hält die Tail-Latenz niedrig, und die Tail-Latenz bestimmt das Tempo eines synchronen Schritts: Er endet erst, wenn die langsamste GPU ihren Austausch beendet.
Kollektiv-Lokalität
xCCL plant das dominierende AllReduce innerhalb eines Rails. Da ein Rail einem Leaf entspricht, bleibt dieser Verkehr auf dem Leaf und konkurriert nie um Spine-Kapazität.
Geringste Hop-Anzahl
GPUs desselben Rangs teilen sich ein Leaf, sodass Gradienten-Sync-Austausche in den wenigsten Hops abgeschlossen werden. Die Spine trägt nur den Cross-Rail-Rest.
Geringere Tail-Latenz
Ein synchroner Schritt endet, wenn der langsamste Austausch endet. Das heiße Kollektiv von der Spine fernzuhalten, kappt den langen Tail, der den gesamten Job blockiert.
Gleichmäßige Pfadnutzung
Für den Cross-Rail-Traffic, der die Spine erreicht, Dynamische Lastverteilung verteilt Elephant-Flows, sodass kein einzelner Uplink zum Hotspot wird.
Die rail-optimierte Fabric im Überblick
Jeder GPU-Server trägt 8 NICs, eine pro Rail, und jedes Rail ist ein eigenes dediziertes Leaf, sodass alle 8 NICs eines Servers auf unterschiedlichen Leaves landen. AllReduce über Rail-N bleibt innerhalb von Leaf-N und berührt die Spine nie; eine 1:1 blockierungsfreie Spine trägt nur den Cross-Rail-Rest. Das Diagramm ist schematisch: Es stellt eine reduzierte Server- und Spine-Anzahl dar, um die Rail-Ausrichtung lesbar zu halten.
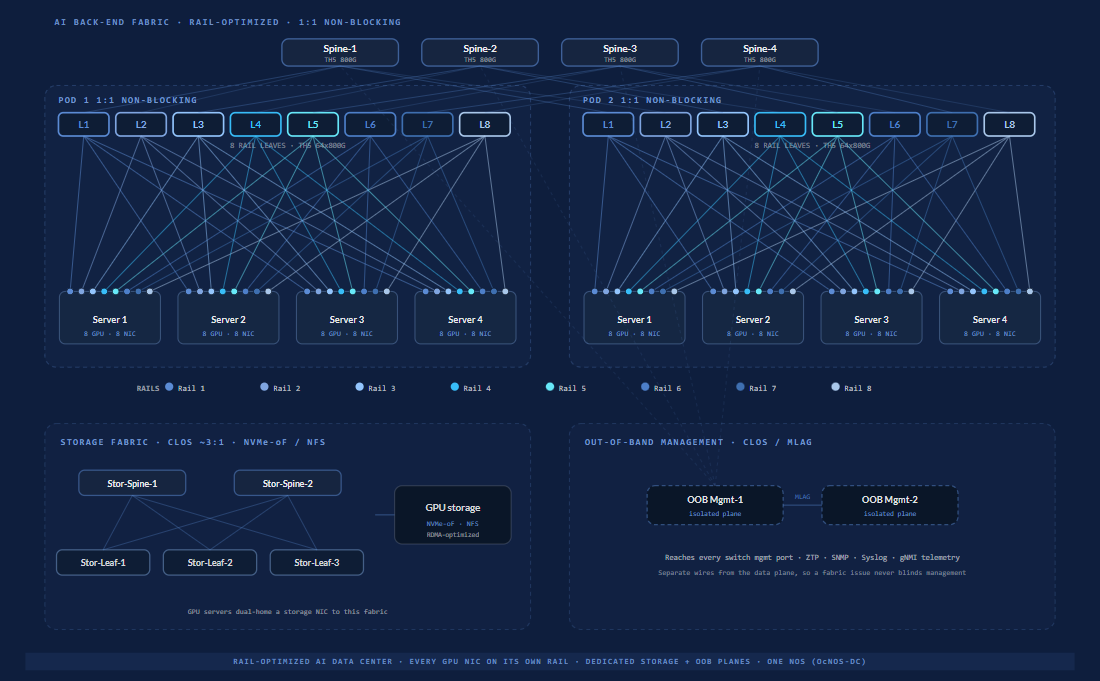
OcNOS-Komponenten: BGP-unnumbered L3-Underlay, RoCEv2 verlustfrei (PFC + ECN) auf jedem Rail-Leaf, DLB auf der Spine-Ebene, gNMI/OpenConfig-Telemetrie durchgängig. Aufgebaut auf HCL-gelisteter Tomahawk 5-Hardware: der Edgecore AIS800-64D und UfiSpace S9321-64E (64×800G).
Rail-optimiert, Rail-only und ToR im Vergleich
Bei der Wahl geht es darum, worauf sich die Fabric ausrichtet. Ein Rail-Layout richtet jeden GPU-Rang an einer Netzwerkebene aus, sodass GPUs desselben Rangs im gesamten Cluster ein Leaf teilen und das Kollektiv mit der geringsten Hop-Anzahl abgeschlossen wird. Ein ToR-Layout richtet sich am Server aus: Jede NIC eines Servers landet auf ihrem Rack-Switch, einfacher zu verkabeln, zwingt aber GPUs desselben Rangs in unterschiedlichen Racks hinauf zur Spine und zurück. Für GPU-Trainings-Fabrics, in denen AllReduce dominiert, ist die Rail-Ausrichtung der Standard; ToR bleibt eine gute Wahl für Storage- und Allzweck-Racks, in denen der Traffic nicht rangsynchron ist.
| Eigenschaft | Rail-optimiertStandard für einen einzelnen Pod | Rail-onlyEinstieg für kleine Cluster | Top-of-Rack (ToR)serverbezogen |
|---|---|---|---|
| Ausrichtung | Jeder GPU-Rang ist an einer Netzwerkebene ausgerichtet; NIC-N jedes Servers wird Leaf-N zugewiesen. | Gleiche Rail-Ausrichtung: NIC-N wird Rail-Leaf-N zugewiesen, jedoch nur eine einzige Reihe von Leaves. | Netzwerk am Server ausgerichtet; jede NIC eines Servers wird ihrem eigenen Rack-Switch zugewiesen. |
| Spine-Ebene | 1:1 blockierungsfreie Spine oberhalb der Rail-Leaves. | Keine Spine-Ebene; die Rail-Leaves stehen für sich. | Standard-Spine oberhalb der Rack-Switches. |
| Cross-Rail-Pfad | Ein echter Netzwerkpfad durch die blockierungsfreie Spine. | Angewiesen auf die serverinterne GPU-Scale-up-Domäne; keine Fabric-Route, sobald sie über eine Domäne hinauswächst. | Rangsynchroner Traffic wird hinauf zur Spine geleitet. |
| Kollektiv-Hop-Anzahl | Am geringsten: Peers desselben Rangs teilen sich ein Leaf, sodass Intra-Rail-AllReduce auf einem Leaf bleibt. | Ebenfalls gering intra-rail, da das Rail weiterhin ein Leaf ist. | Höher: Peers desselben Rangs in unterschiedlichen Racks sitzen auf unterschiedlichen Switches, sodass Kollektive die Spine überqueren. |
| Beste Passung | Die standardmäßige skalierbare Einheit für einen einzelnen Pod, für GPU-Trainings- und Inferenz-Fabrics. | Eine Handvoll Racks unterhalb einer Scale-up-Domäne; der Einstiegspunkt. | Storage-, CPU- und Allzweck-Racks, in denen der Traffic nicht rangsynchron ist. |
Wie weit eine rail-optimierte Fabric skaliert
Die Skalierung wird durch die Switch-Radix bestimmt und dadurch, wie jeder 800G-Port auf GPUs abgebildet wird. Auf Broadcom Tomahawk 5 (51.2 Tbps, 64×800G oder 128×400G) reichen die Designs von einem zweistufigen Leaf-Spine bis zu drei Ebenen mit einem Super-Spine. Da der Großteil des Collective-Traffics rail-lokal bleibt, wird die Super-Spine-Plane nur auf das tatsächlich benötigte Cross-Pod-Verhältnis dimensioniert. Zur Einordnung: Meta hat öffentlich einen Ethernet-basierten AI-Trainingscluster mit 24.576 GPUs beschrieben, der zeigt, dass Ethernet-Fabrics weit über einen einzelnen Pod hinaus arbeiten.
Zweistufig, 1:1 blockierungsfrei
Rail-optimiertes Leaf-Spine mit 800G pro GPU, jede GPU an zwei 400G-Leaf-Ports: 128 Leaves, 64 Spines. Der größte zweistufige Pod auf diesem Silicon.
Zweistufig mit 400G pro GPU
Dasselbe zweistufige Design für GPUs mit je einer 400G-NIC.
Dreistufig, Super-Spine
Oberhalb von 4.096 GPUs fügen Sie eine Super-Spine-Ebene über den Rail-optimierten Pods hinzu. Jeder Pod bleibt 1:1 nicht blockierend; das Super-Spine legt das Cross-Pod-Verhältnis fest.
Dimensionieren Sie Ihr eigenes Cluster? Die AI Fabric Design Suite dimensioniert einen nicht blockierenden zweistufigen Leaf-Spine-Pod und weist darauf hin, wenn Sie in den dreistufigen Maßstab übergehen. Das vollständige Topologiebild finden Sie auf der AI-Fabric-Topologien Referenz.
Wie OcNOS-DC eine rail-optimierte Fabric aufbaut
OcNOS-DC verwandelt HCL-gelistete Tomahawk 5-Switches in eine rail-optimierte Fabric mit einem gerouteten Underlay, einem verlustfreien RoCEv2-Substrat, dynamischer Lastverteilung und Streaming-Telemetrie. Es ist ein System: validierte Hardware, das OcNOS-DC-Netzwerkbetriebssystem und ein einziger Supportvertrag mit einem TAC und einem SLA.
BGP-unnumbered L3
Ein geroutetes Underlay mit BGP unnumbered beseitigt die Adressplanung pro Link und verteilt den Traffic mit ECMP über jeden Rail-zu-Spine-Pfad.
RoCEv2 mit PFC + ECN
OcNOS-DC stellt das verlustfreie Ethernet-Substrat bereit, das RoCEv2 erfordert: PFC hält die Priorität verlustfrei und ECN markiert Überlastung. RoCEv2 selbst ist der NIC-Transport, der auf diesem Substrat aufsetzt.
Dynamische Lastverteilung
DLB verteilt Elephant-Flows anhand der Echtzeit-Pfadqualität statt eines statischen Hashes, sodass sich Cross-Rail-Traffic nicht auf einem Uplink staut und eine gut betriebene Fabric auf Tomahawk 4/5 eine Auslastung von über 90 Prozent anstreben kann.
gNMI / OpenConfig
Telemetrie wird über gNMI mit OpenConfig-Modellen gestreamt, sodass Sie die Fabric während der Cluster-Inbetriebnahme mit Closed-Loop-Daten optimieren.
HCL-gelistete Tomahawk 5
Läuft auf validierten 64×800G-Switches: Edgecore AIS800-64D und UfiSpace S9321-64E. Jedes Leaf und jede Spine hier steht auf der OcNOS Hardware Compatibility List.
Mitglied des Ultra Ethernet Consortium
IP Infusion ist Mitglied des Ultra Ethernet Consortium (UEC). UEC 1.0 definiert einen Multipath-Ethernet-Transport, der einen Flow über viele Pfade verteilt und auf UEC-fähigen NICs läuft.
Das AI-Fabric-Referenzdesign anfordern
Das vollständige PDF: rail-optimierte Topologie, Anzahl der Switches und Transceiver, validierte Plattformen und ein verlustfreies RoCEv2-Startprofil auf OcNOS-DC.
Das AI-Fabric-Referenzdesign anfordern
Kurzes Formular: Ihr PDF wird unmittelbar nach dem Absenden heruntergeladen.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
FAQ zum rail-optimierten Netzwerk
Was ist ein rail-optimiertes Netzwerk?
Was ist der Unterschied zwischen rail-optimiert und Rail-only?
Rail vs ToR: Welches Layout sollte eine AI-Fabric verwenden?
Auf wie viele GPUs skaliert eine rail-optimierte Fabric?
Benötigt ein rail-optimiertes Netzwerk InfiniBand?
Wie implementiert OcNOS-DC eine rail-optimierte Fabric?
Tiefer einsteigen. Zum Mitnehmen.
Das Produktdatenblatt und kurze, technische Downloads, die über diese Seite hinausgehen.
OcNOS-DC-Datenblatt
Vollständige OcNOS-DC-Spezifikation: Funktionsumfang für EVPN-VXLAN und Ethernet for AI, Software-SKUs, unterstützte Hardware-Plattformen und der Solution Ordering Guide.
Datenblatt abrufenOcNOS: verlustfreie 800G-AI-Fabric
Non-Blocking-RoCEv2-Fabric auf Broadcom-Tomahawk-4/5-Spines: SKU-Stufen, validierte Plattformen und Deployment-Architektur.
Brief anfordernEVPN-VXLAN-Data-Center-Fabric
Carrier-Grade-Leaf-Spine-Data-Center-Fabric: symmetrisches IRB, Type-2/Type-5-Routen und verteiltes Anycast-Gateway.
Brief anfordernOcNOS-DC-Datenblatt
Kurzes Formular. Ihr PDF öffnet sich unmittelbar nach dem Absenden in einem neuen Tab.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
OcNOS: verlustfreie 800G-AI-Fabric
Kurzes Formular. Ihr PDF öffnet sich unmittelbar nach dem Absenden in einem neuen Tab.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
EVPN-VXLAN-Data-Center-Fabric
Kurzes Formular. Ihr PDF öffnet sich unmittelbar nach dem Absenden in einem neuen Tab.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
Sie planen eine rail-optimierte GPU-Fabric? Wir rechnen die Port-Anzahl gemeinsam mit Ihnen durch.
Nennen Sie uns die GPU-Größenordnung und die Rail-Anzahl, und ein IP Infusion Engineer dimensioniert gemeinsam mit Ihnen den Leaf-Spine-Pod, oder beginnen Sie mit einem ersten Entwurf in der AI Fabric Design Suite.
Die gesamte AI-Fabric mit OcNOS entwerfen
Vom Business Case bis zur Portanzahl-Berechnung: Steigen Sie dort ein, wo Sie beim Aufbau gerade stehen.