BCM78900 · TSMC 5 nm · Auslieferung seit März 2023

Broadcom Tomahawk 5 Tomahawk 5 Switches Drei offene 800G-Plattformen, validiert auf OcNOS-DC.

Edgecore AIS800-64D, UfiSpace S9321-64E und S9321-64EO: dasselbe Silizium, dasselbe OcNOS-DC-Image, drei Beschaffungswege. Spezifikationen, Entscheidungsregeln und die OcNOS-DC-Feature-Oberfläche für Ingenieure, die einen Tomahawk-5-Switch auswählen.

51.2Tbps
Switch-Kapazität
64×800G
Nativer Port-Radix
3SKUs
OcNOS-validiert
2ODMs
Edgecore · UfiSpace
5nm
TSMC-N5-Prozess
01
Die Switches
Open Hardware mit Tomahawk 5

Drei 800G-Plattformen. Zwei ODMs. Ein OcNOS-DC-Image.

Zwei Hardwaredesigns, drei SKUs. Alle drei werden mit vorinstalliertem ONIE ausgeliefert und laufen mit demselben OcNOS-DC-Image. Die Unterschiede liegen im Formfaktor (QSFP-DD vs. OSFP), in der Positionierung (AI-Fabric-SKU vs. allgemeiner DC-SKU) und im Optik-Ökosystem, auf dem der Einsatz aufbaut. Jede Karte verlinkt auf das vollständige Datenblatt des Herstellers (PDF, lokal gehostet).

Edgecore· DCS560 Plattformfamilie
AI-Fabric-Spine

AIS800-64D

Validiert auf OcNOS-DC · ONIE vorinstalliert
Ports
64 × QSFP-DD800Breakout: 2×400 / 4×200 / 8×100 (320 logische Ports)
Formfaktor
2RU
Stromversorgung
2× 3000 W AC/DC redundant30 W pro QSFP-DD-Cage
CPU
Intel Xeon D1713NTE
▌ Wählen Sie dies, wenn

AI-Fabric für GPU-Cluster. Edgecore-DCS560-Chassis mit dem AI-Fabric-SKU-Framing.
UfiSpace· Plattformfamilie S9321
AI-Fabric-Spine

S9321-64E

Validiert auf OcNOS-DC · ONIE vorinstalliert
Ports
64 × QSFP-DD (200/400/800G)Breakout: 2×400 / 4×200 / 8×100
Formfaktor
2RU · 23.72 kg
Stromversorgung
913 W typisch (ohne Transceiver)30 W pro QSFP-DD-Cage
CPU
Intel Icelake-D mit 4 Kernen · 32 GB DDR4
▌ Wählen Sie dies, wenn

Große, entropiearme AI-Flows. UfiSpace positioniert den 64E für AllReduce-dominierten Verkehr, bei dem das adaptive Routing des TH5 im Zentrum des Designs steht.

UfiSpace· Plattformfamilie S9321
800G DCI · kohärente Optik

S9321-64EO

Validiert auf OcNOS-DC · ONIE vorinstalliert
Ports
64 × OSFP (200/400/800G)Breakout: 2×400 / 4×200 / 8×100
Formfaktor
2RU · 23.74 kg
Stromversorgung
925 W typisch · 200-240 V ACOSFP-Cages für leistungsstärkere Optiken
CPU
Intel Icelake-D · 32 GB DDR4
▌ Wählen Sie dies, wenn

800G-ZR/ZR+-Coherent oder andere Modulklassen mit höherer Leistungsaufnahme. OSFP-Formfaktor des 64E: Wählen Sie ihn, wenn die Optik die Cage-Wahl bestimmt.

· So wählen Sie zwischen den dreien

AIS800 vs. S9321-64EDasselbe TH5-Silizium, zwei ODMs. Edgecore DCS560 (AIS800-64D) vs. UfiSpace S9321 – Dual-Source-BoM für Hyperscale- und NeoCloud-Beschaffung.
QSFP-DD vs OSFPQSFP-DD (S9321-64E und AIS800-64D) für das Optik-Ökosystem mit hohen Stückzahlen. OSFP (S9321-64EO) für Modulklassen mit höherer Leistung, einschließlich 800G ZR/ZR+ kohärent.
Edgecore vs. UfiSpaceBeide sind Open-Hardware-ODMs mit enger IP-Infusion-Co-Design-Zusammenarbeit. Wählen Sie nach Ihrer ODM-Beziehung, RMA-Logistik oder BoM-Wirtschaftlichkeit.
Single-Vendor-RisikoZwei Anbieter mit TH5-Plattformen bedeuten, dass eine Dual-Source-BoM realistisch ist, was für die Beschaffung im Hyperscale- und NeoCloud-Bereich wichtig ist.
02
Im Inneren des Silicon
Was Ihnen 51,2 Tbps in einem Die bringen

Tomahawk 5: Broadcoms Flaggschiff-Merchant-Switch-ASIC.

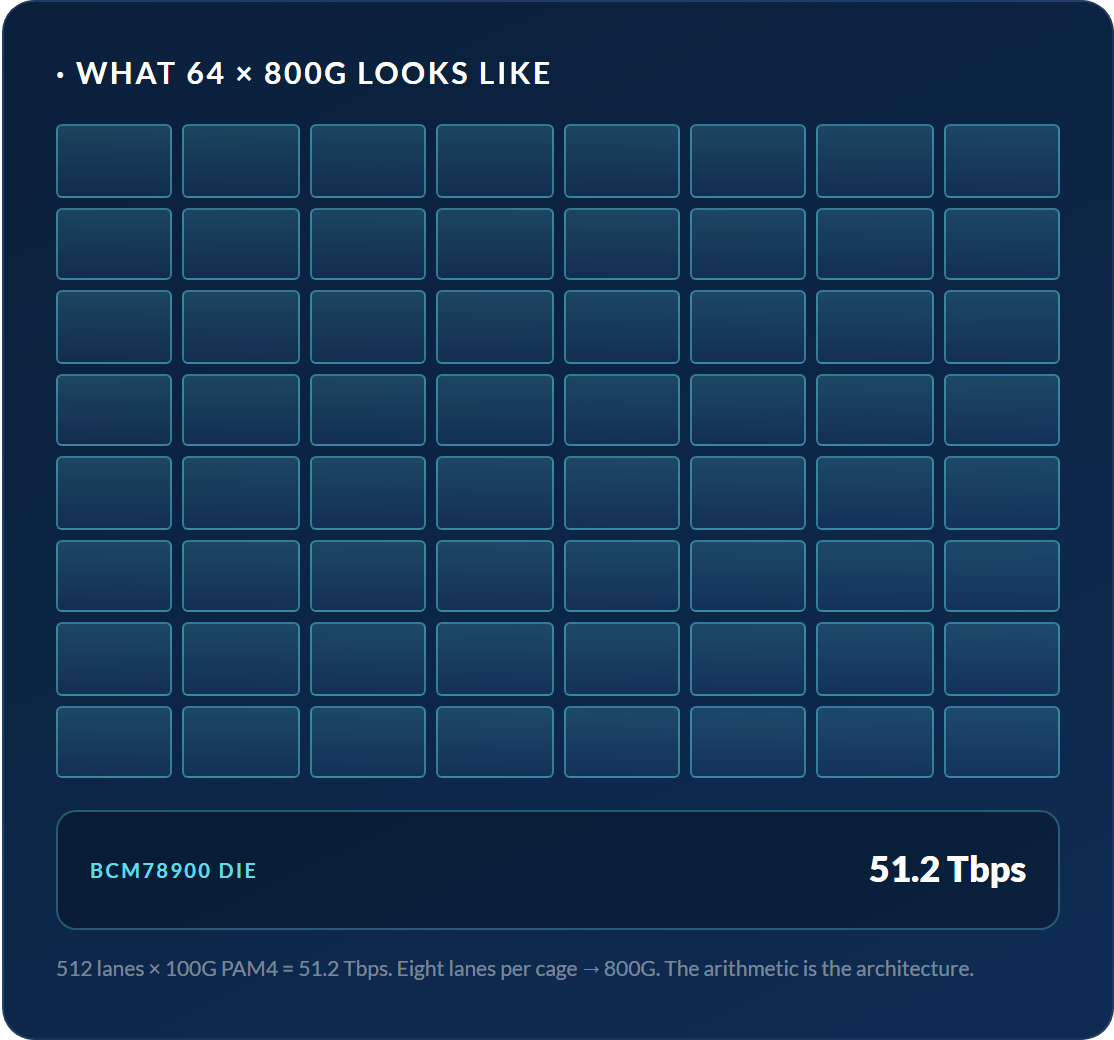
Der BCM78900 ist ein einzelner monolithischer 5-nm-Die, der 51,2 Tbps Switching-Kapazität liefert und nativ 64 Ports mit 800GbE, 128 mit 400G oder 256 mit 200G speist. Es war Broadcoms erstes 5-nm-Merchant-Switch-IC und das weltweit erste Produkt, das 800GbE am Cage unterstützte. 512 SerDes-Lanes mit 100G PAM4: dieselbe Lane-Anzahl wie Tomahawk 4, die doppelte Geschwindigkeit pro Lane.

Über die reine Kapazität hinaus machten drei architektonische Entscheidungen TH5 zum Silicon unter den meisten produktiven AI-Fabrics: ein Shared-Buffer-Architektur der xCCL-(NCCL / RCCL / oneCCL)-Kollektiv-Microbursts hardwareseitig abfängt Cognitive Routing (DLB), das Elephant Flows im ASIC neu bindet, sowie 5-nm-Thermal-Headroom, der 30-W-QSFP-DD800-Cages ohne aktive Kühlung pro Port betreiben lässt.

Spezifikationen verifizierbar anhand der öffentlichen Broadcom-Angaben BCM78900 Produktseite.

ProzessTSMC N5 SerieStrataXGS PufferShared, RDMA-optimiert RoutingKognitiv · DLB LieferbarSeit März 2023
Port-Radix des Broadcom Tomahawk 5 (BCM78900), dargestellt als Raster aus 64 Ports, jeder mit 800G QSFP-DD, mit insgesamt 51,2 Tbps Switching auf einem einzigen Die
So sehen 64 x 800G aus: 512 Lanes mit 100G PAM4, insgesamt 51,2 Tbps auf dem BCM78900 Die.
Vier entscheidende Designentscheidungen

Warum TH5 in nahezu jedem seit 2024 gebauten offenen AI-Fabric gelandet ist.

Die Schlagzahl bekommt die Presse. Diese vier technischen Entscheidungen sind das, was AI-Fabric-Architekten tatsächlich interessiert.

PRINZIP 01

Gleiche Lane-Anzahl, doppelte Geschwindigkeit.

TH5 führt dieselben 512 SerDes-Lanes wie TH4 und betreibt sie mit 100G PAM4 statt 50G. Die Verdopplung des Durchsatzes ergab sich durch das Beschleunigen vorhandener Infrastruktur, nicht durch deren Erweiterung.

100G PAM4 · 106 Gbps
PRINZIP 02

Shared-Buffer, nicht partitioniert.

Paket-Memory-Pools über alle 64 Ports hinweg, nicht pro Port aufgeteilt. xCCL-AllReduce-Micro-Bursts an einem Port werden vom fabric-weiten Pool absorbiert, statt Tail-Drop auszulösen. Der Einzeiler-Grund, warum TH5 bei RoCEv2 gewinnt.

Gemeinsamer Puffer · für RDMA optimiert
PRINZIP 03

Hardwarebasiertes adaptives Routing.

Broadcom Cognitive Routing erkennt überlastete Pfade und rebindet Elephant Flows im ASIC: kein Controller-Round-Trip, kein ECMP-Rehashing. OcNOS-DC aktiviert dies als DLB Reactive-Path Rebalance.

DLB · 64-µs-Flowlet
PRINZIP 04

5 nm thermische Reserve.

Der erste 5-nm-Merchant-Switch-IC. Erst der Prozess-Shrink machte 30 W pro QSFP-DD800-Cage ohne aktive Kühlung pro Port machbar, einschließlich Hochleistungs-800G-Optik und 8×100G-Breakout.

TSMC N5 · 30 W/Port
03
Generationssprung
Tomahawk 4 → Tomahawk 5

Geschwindigkeit pro Port verdoppelt. Kapazität verdoppelt. Dieselbe 64-Port-Radix.

TH4 (25.6 Tbps · 64×400G · 7 nm) ist für Cluster rund um 400G-NICs weiterhin hervorragend. TH5 rechtfertigt seinen Platz im Rack, wenn sowohl 800G pro Port als auch AI-Fabric-Primitive zählen.

Tomahawk 6: was sich bei 1.6T ändert →

Switching-Kapazität
25.6 Tbps → 51,2 Tbps

Verdoppelt bei gleichbleibendem Rack-Footprint. Gleiche 2RU, gleiche Leistungsklasse.

Geschwindigkeit pro Port
64 × 400G → 64 × 800G

Dieselbe 64-Port-Radix auf den tatsächlichen IPI-Plattformen (AS9736-64D → AIS800-64D / S9321). Die Bandbreite pro Port verdoppelt sich, sodass jede Clos-Stufe doppelt so viel Traffic transportiert.

Prozessknoten
7 nm → 5 nm

Erster 5-nm-Merchant-Switch-IC. Thermische Reserve für 30 W/Port ohne aktive Kühlung.

SerDes pro Lane
50G PAM4 → 100G PAM4

Dieselben 512 Lanes, doppelte Geschwindigkeit. Die Durchsatzverdopplung kam aus der bestehenden Infrastruktur.

Der Brownfield-Refresh bleibt sauber. Dasselbe OcNOS-DC-Image läuft auf TH3-, TH4- und TH5-Plattformen: Konfigurationen, Automatisierung und gNMI-Pipelines werden übernommen. Wählen Sie TH5 für das nächste Cluster und behalten Sie TH4 dort, wo es bereits funktioniert.
04
Was OcNOS-DC mitbringt
OcNOS-DC auf diesem Silicon

Carrier-Grade NOS. AI-optimierte Defaults.

Tomahawk 5 hat die Hardware. Die Aufgabe des NOS ist es, sie zugänglich zu machen: für Operatoren, für Telemetrie-Pipelines, für den Cluster-Scheduler, ohne sie zu CLI-Verrenkungen drumherum zu zwingen. OcNOS-DC liefert diese Primitive als erstklassige konfigurierbare Objekte mit YANG-modelliertem State.

Shared-Buffer-Architektur, Zero-Drop East-West.

OcNOS-DC liefert PFC + ETS + Dynamic ECN bereits auf xCCL-Kollektiv-Pattern abgestimmt aus. Die Tail-Latenz bleibt auch unter AllReduce-Micro-Bursts begrenzt, die Community-NOS-Fabrics in die Knie zwingen. Der Shared-Buffer-Pool des TH5 absorbiert synchronisierten Many-to-One-Traffic, der auf Chips mit partitionierten Buffern zu Tail-Drops führen würde.

DLB bindet Flowlets in 64 µs neu.

ECMP-Hash-Kollisionen unter Elephant Flows sind der AI-Fabric-Killer. OcNOS-DC aktiviert das Flowlet-Rebinding von TH5 Cognitive Routing, sodass sich AllReduce-Verkehr automatisch über jeden Spine-Pfad verteilt.

Pro Port, pro Priorität. Auto-Drain.

Erkennt Paused-Queue-Zyklen, bevor sie Training-Jobs zum Stillstand bringen. Automatische Wiederherstellung ohne Eingriff des Betreibers.

gNMI on-change, OpenConfig YANG.

Buffer-Tiefe, ECN-Marks, PFC-Pause-Zähler: jeder Schwellenwert ein Stellrad, jeder Counter ein Sensor-Pfad. Bindet sich in Prometheus, Grafana und OTel ein.

BGP · OSPF · IS-IS · EVPN-VXLAN.

Der TH5-Spine ist außerdem ein echter Router. Vollständiger Carrier-Grade-Layer-3-Stack auf demselben Silicon: Betreiben Sie das AI-Fabric wie den Rest Ihres Netzwerks, nicht wie eine Black Box.

215 Features in 8 Kategorien, entnommen aus der aktuellen OcNOS Feature Matrix.

Layer-3-Routing · L1/L2 · AI-Fabric-Grundfunktionen · Multicast · QoS · Sicherheit · Hardware · Management. Jeder Eintrag ist pro Plattform in der öffentlichen Matrix überprüfbar.

RoCEv2 / PFC DCQCN DLB EVPN-VXLAN SR-MPLS BGP / OSPF / IS-IS gNMI / NETCONF ZTP
Day-0 bis Day-2

ZTP. gNMI on-change. NETCONF + YANG. DCBX.

Bringen Sie einen TH5-Spine im Rack per Zero-Touch-Provisioning hoch. Streamen Sie jeden Counter in Ihren Observability-Stack. Justieren Sie jeden Schwellenwert über YANG-modellierte Config. Keine Glue-Skripte.

ZTP IPv4/IPv6 gNMI NETCONF OpenConfig YANG DCBX LLDP Ansible Terraform-Provider
Wer baut diesen Stack

Drei Betreiberprofile. Eine Silicon-+-NOS-Kombination.

Derselbe TH5-Die, dasselbe OcNOS-DC-Image, drei verschiedene Rahmungen derselben architektonischen Frage: Wie skalieren Sie Lossless-East-West, ohne den gesamten Stack an einen einzigen Anbieter zu binden?

Training-Fabric bis zur 16k-GPU-Obergrenze auf Open Silicon.

"Wir brauchen 800G zum Leaf, verlustfreies RoCEv2 und eine Tail-Latency, die unter AllReduce nicht explodiert. Single-Vendor-Lock-in kommt nicht infrage."

TH5-64×800G-Spines, RoCEv2 mit xCCL-getuntem DCQCN, DLB-Rebinding im Submillisekundenbereich, PFC-Deadlock-Watchdog. Gleiche 64-Port-Radix wie TH4, aber jeder Spine-Port trägt 800G, was die Spine-Leaf-Verkabelung bei gleicher aggregierter Fabric-Bandbreite halbiert.

DC · AI-Fabric-SKU

AI-Cluster-Operator

Mandantenfähige Fabric, BoM unter Kontrolle.

"Unsere Kunden wählen die GPU. Wir können unsere Fabric-BoM nicht an deren NIC-Wahl koppeln. Wir brauchen einen Switch, den wir von mindestens zwei Herstellern beziehen können."

Drei OcNOS-validierte TH5-SKUs von zwei Herstellern (Edgecore, UfiSpace). Tenant-Isolation mit VRF-Lite, gNMI-Telemetrie pro Tenant, EVPN-VXLAN-Segmentierung. Ein NOS-Image, Multi-Vendor-Hardware.

DC · Mandantenfähig

NeoCloud · GPU-as-a-Service

TH3/TH4-Fabric-Erneuerung ohne Forklift.

"Wir haben eine TH4-Fabric in Produktion. Der nächste Training-Cluster braucht 800G-NICs. Wir wollen nicht die gesamte NOS-Schicht neu entwerfen, um das Silicon aufzurüsten."

Dasselbe OcNOS-DC-Image läuft auf TH3-, TH4- und TH5-Plattformen. Ein Brownfield-Refresh hält Konfigurationen, Automatisierung und gNMI-Pipelines intakt.

DC · TH3 bis TH5

Hyperscaler · Brownfield-Refresh

Häufig gestellt

Fragen, die Architekten stellen

Drei Open-Hardware-Plattformen von zwei ODMs: Edgecore AIS800-64D (DCS560-Chassis) sowie UfiSpace S9321-64E (QSFP-DD) und S9321-64EO (OSFP). Alle drei werden mit vorinstalliertem ONIE ausgeliefert und führen dasselbe OcNOS-DC-Image aus: gleiche Konfiguration, gleicher Funktionsumfang, gleiche Automatisierungs-Hooks. Zwei Anbieter bedeuten, dass eine Dual-Source-BoM für die Beschaffung im Hyperscale- und NeoCloud-Umfeld realistisch ist.
QSFP-DD (AIS800-64D und S9321-64E) ist das volumenstarke Optics-Ökosystem, der richtige Standard für Short-Reach-800G innerhalb des Rechenzentrums. OSFP (S9321-64EO) bietet leistungsstärkere Cages für Modulklassen, die QSFP-DD nicht aufnehmen kann: 800G ZR/ZR+ Coherent für DCI, Longer-Reach DR4/DR8 und steckbare Verstärker. Wählen Sie OSFP, wenn die Optik die Cage-Wahl bestimmt: andernfalls gewinnt QSFP-DD bei Kosten und Ökosystem-Breite.
TH4 bietet 25,6 Tbps · 64×400G · 7 nm · 50G PAM4. TH5 verdoppelt bei gleichem 64-Port-Radix die Geschwindigkeit pro Port und die gesamte Switching-Kapazität (51,2 Tbps · 64×800G · 5 nm · 100G PAM4). Entscheidungsregel: Wenn der Cluster nativ 800G-Ports benötigt oder jeder Spine-Port die doppelte Bandbreite tragen soll (was die Verkabelung bei gleichem aggregiertem Fabric-Durchsatz halbiert), wählen Sie TH5. Ist das Design um 400G-NICs und einen Single-Pod-Footprint herum aufgebaut, ist TH4 nach wie vor hervorragend und pro Port günstiger. OcNOS-DC unterstützt beide mit demselben Funktionsumfang: Ein Brownfield-Refresh bleibt sauber.
Das Endpunktverhalten von Ultra Ethernet (Packet Spraying, Neuordnung, selektive Neuübertragung) läuft auf UEC-fähigen NICs, und die UEC-1.0-Spezifikation deckt auch Link- und Switch-Verhalten ab. Ob UEC passt, hängt daher von NIC, Switch-Silicon und NOS-Release ab. Auf Tomahawk 5 betreibt OcNOS-DC heute verlustfreies RoCEv2 mit PFC, ECN, DCQCN und DLB im Sub-Millisekunden-Bereich produktiv. IP Infusion ist Mitglied des Ultra Ethernet Consortium. Wie UEC zu einem konkreten Aufbau passt, klären Sie am besten mit einem Ingenieur von IP Infusion.
Auf TH5 wird OcNOS-DC vorab abgestimmt für AI-Fabrics ausgeliefert: PFC über L3, ETS, Dynamic ECN, DLB Reactive-Path Rebalance, DLB Random-Flow, PFC Deadlock Detection & Recovery, xCCL-konforme Buffer-Profile, DCBX LLDP. Auf demselben Silicon läuft zudem ein vollständiger Carrier-Grade Layer-3-Stack (BGP, OSPF, IS-IS, SR-MPLS, EVPN-VXLAN), den reine AI-Stacks in der Regel nicht abdecken. 215 Features über 8 Kategorien validiert, jeder Eintrag in der öffentlichen OcNOS Feature Matrix überprüfbar.
SP-Edge, Cell-Site-Gateway, Aggregation unter 1 Tbps. In diesen Rollen rechtfertigt die 64×800G-Radix ihren Platz im Rack nicht. Für SP-Routing validiert OcNOS Broadcom Qumran (Q2C, Q2C+) und Jericho (J2C+); für 100G/400G DC-Leaf in Single-Pod-Umgebungen bietet Trident (TD3-X7, TD4) die bessere Wirtschaftlichkeit. TH5 gewinnt, wenn sowohl 800G-Radix als auch AI-Fabric-Primitive zählen.

Eine Tomahawk-5-Fabric entwerfen? Lassen Sie uns sie gemeinsam dimensionieren.

30-minütige Architektursitzung mit einem OcNOS-Netzwerkarchitekten. Bringen Sie Ihre GPU-Anzahl, NIC-Geschwindigkeit und bevorzugte Ebenenstruktur mit und erhalten Sie eine dimensionierte Stückliste für alle drei TH5-SKUs.