Verlustfreie 800G-Ethernet-Fabrics für GPU-Cluster
OcNOS AI Fabric ist die vollständige AI-Fabric von IP Infusion: OcNOS-DC vorinstalliert auf qualifizierten 800G- und 400G-Switches mit Broadcom Tomahawk von Edgecore oder UfiSpace, mit verlustfreiem RoCEv2, dynamischem Load Balancing sowie Erkennung und Behebung von PFC-Deadlocks, unter einem Supportvertrag. NICs und GPUs wählen Sie weiterhin selbst.
- Am besten geeignet für
- Teams, die GPU-Cluster auf verlustfreiem 800G- oder 400G-Ethernet aufbauen, mit NICs und GPUs ihrer Wahl.
- Qualifiziert auf
- Edgecore AIS800-64DUfiSpace S9321-64EEdgecore AS9736-64D
Was eine GPU-Fabric leisten muss
Eine AI-Fabric ist das Ethernet-Netzwerk, das GPU-Server verbindet. Sie muss RoCEv2-Traffic verlustfrei transportieren und jeden Link auslasten, denn ein einziges verworfenes Paket hält eine Collective-Operation an, während die NIC es erneut sendet, und ein einziger überlasteter Link bremst den gesamten Trainingsjob.
Drei Traffic-Muster bremsen Trainingsjobs aus. OcNOS-DC hat für jedes eine Lösung.
Gleicher Traffic, dieselben vier Uplinks. Es ändert sich nur, wie die Flows verteilt werden.
Statisches ECMP legt jeden großen Flow per Hash auf einen Uplink fest, sodass zwei Uplinks überlastet sind, während zwei nahezu ungenutzt bleiben.
DLB bewertet jeden Uplink nach aktueller Port-Auslastung und Queue-Tiefe und verschiebt Flowlets auf weniger belastete Pfade, sodass sich die Last ausgleicht.
Schematische Darstellung.
→ DLB verschiebt Flowlets von überlasteten Uplinks auf weniger belastete Pfade.
→ ECN-Markierung signalisiert DCQCN-fähigen NICs, ihre Senderate zu drosseln, bevor die Puffer volllaufen.
→ PFC-Deadlock-Erkennung und -Behebung löst eine blockierte Queue selbstständig auf.
→ PFC und ECN halten RoCEv2-Traffic verlustfrei.
GLB, verfügbar ab OcNOS 7.1, wird die Last über die gesamte Fabric verteilen. Mehr zu GLB →
Jede GPU-NIC auf ihrer eigenen Rail
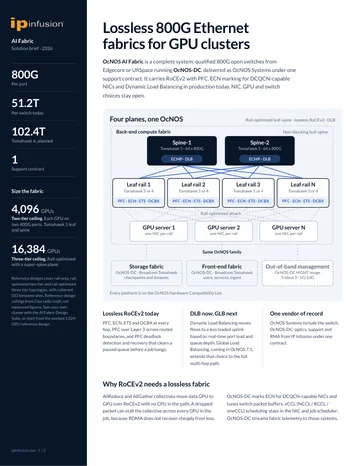
Jeder GPU-Server bindet je eine NIC an jedes der acht Rail-Leaves an. AllReduce innerhalb einer Rail bleibt auf ihrem Leaf; nur Traffic zwischen Rails erreicht die 800G-Tomahawk-5-Spines. Pods skalieren auf denselben Switches.
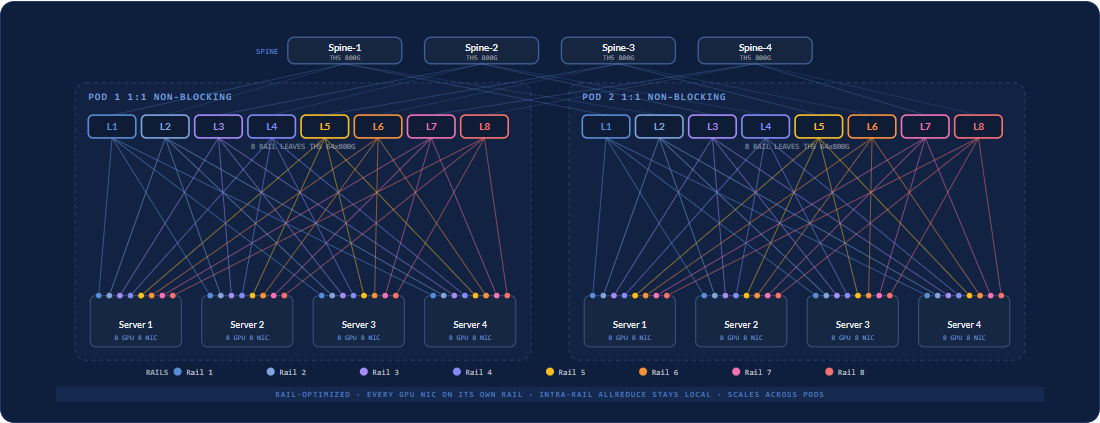
Eine rail-optimierte Fabric für 1.024 GPUs, Switch für Switch durchgerechnet: Port-Rechnung, Komponentenzahlen, Skalierung auf 4.096 GPUs und darüber hinaus, Plattformen und OcNOS-DC-Editionen sowie ein verlustfreies RoCEv2-Startprofil.
Technische Übersicht
Was OcNOS-DC in der Fabric ausführt. Folgen Sie einem Link für die Detailanalyse.
Stand OcNOS-DC 7.0. Quellen, geprüft im Oktober 2026: die OcNOS-Feature-Matrix (Rechenzentrumsplattformen), die Hardware-Kompatibilitätsliste und das AI-Fabric-Referenzdesign.
| Bereich | OcNOS-DC | Detailanalyse |
|---|---|---|
| Silizium | OcNOS AI Fabric unterstützt heute Broadcom Tomahawk 5 und Tomahawk 4 für AI-Leaves und -Spines. Die Unterstützung für Tomahawk 6 ist für OcNOS 7.2 geplant.Quellen: Hardware-Kompatibilitätsliste, Tomahawk-6-Seite | Silizium → |
| Verlustfreier Transport | RoCEv2 mit PFC pro Priorität, ECN-Markierung und ETS. PFC over L3 über geroutete Grenzen hinweg.Quelle: Feature-Matrix (PFC with QoS, PFC over L3, ECN, ETS) | RoCEv2 → |
| Überlastungssteuerung | ECN-Markierung für DCQCN-fähige NICs, mit Dynamic ECN auf Tomahawk 5. Tuning des Paketpuffers im Switch.Quelle: Feature-Matrix (ECN, Dynamic ECN, Switch-Paketpuffer-Tuning) | DCQCN → |
| Lastverteilung | Dynamisches Load Balancing (DLB) auf Tomahawk 4 und 5, mit RoCEv2-Hashing nach Ziel-QP, sowie Reactive Path Rebalance auf Tomahawk 5. GLB, verfügbar ab OcNOS 7.1, erweitert dies auf die gesamte Fabric.Quellen: Feature-Matrix (DLB, DLB Reactive Path Rebalance), OcNOS-DC System Management Guide, GLB-Seite | DLB → |
| Deadlock-Schutz | Erkennung und Behebung von PFC-Deadlocks.Quelle: Feature-Matrix (Erkennung und Behebung von PFC-Deadlocks) | PFC-Deadlock → |
| Server-Einstellungen | DCBX tauscht PFC- und ETS-Einstellungen über LLDP mit dem Link-Partner aus.Quelle: Feature-Matrix (DCBX, DCBX für PFC over L3) | |
| Telemetrie | gNMI-Streaming über OpenConfig-Modelle: On-Change, Dial-in und Dial-out.Quelle: Feature-Matrix (gNMI Dial-in, Dial-out und On-Change, OpenConfig-Modelle) | Telemetrie → |
| Automatisierung | ZTP über IPv4 und IPv6. Ansible-Playbooks von Day 0 bis Day 2. IP Maestro über NETCONF.Quelle: Feature-Matrix (ZTP über IPv4 und IPv6, Ansible, NETCONF) | Automatisierung → |
| AI-Agenten | gNMI-Telemetrie, NETCONF mit YANG-Modellen und commit confirmed mit automatischem Zurücksetzen, sodass AI-Agenten und AIOps-Tools die Fabric lesen, ändern und zurückrollen können.Quelle: Feature-Matrix (NETCONF Confirmed Commit, CLI Commit Confirmed) | AI-Agenten → |
| Topologien | Rail-only, Rail-optimiert zweistufig und Rail-optimiert dreistufig.Quelle: AI-Fabric-Referenzdesign, Oktober 2026 | Topologien → |
| Skalieren | Zwei Stufen bis 4.096 GPUs mit 800G pro GPU auf Tomahawk 5. Drei Stufen bis 16.384 GPUs. Reference-design ceilings from Clos radix math, not measured figures.Quelle: AI-Fabric-Referenzdesign, Oktober 2026 | Dimensionierung → |
| Ultra Ethernet | IP Infusion ist Mitglied des Ultra Ethernet Consortium.Quelle: Ultra-Ethernet-Seite | UEC → |
Scale-across: ein GPU-Cluster in mehreren Gebäuden
Große GPU-Cluster brauchen heute mehr Strom, als ein einzelnes Gebäude liefern kann. Betreiber verbinden deshalb die Fabrics mehrerer Gebäude und Standorte zu einem Cluster. OcNOS-DC betreibt die Spines an jedem Standort, OcNOS-SP die Deep-Buffer-Router zwischen den Regionen.
Coherent-Optiken im Spine-Port
Auf den qualifizierten Tomahawk-4- und Trident-4-Switches unterstützt OcNOS-DC 400G ZR/ZR+. Auf den Tomahawk-5-Modellen Edgecore AIS800-64D und UfiSpace S9321-64E unterstützt es 800G ZR/ZR+. Der Spine verbindet sich direkt mit dem OLS / ROADM, ohne Transponder- oder Muxponder-Shelves.
So funktioniert Coherent DCIÜberlastsignale auf gerouteten Links
ECN-Markierung läuft auf gerouteten Schnittstellen aller 18 qualifizierten OcNOS-DC-Switches, sodass DCQCN-fähige NICs Überlast auch auf gerouteten Links zwischen Gebäuden erkennen. BFD auf BGP-Sessions erkennt Pfadausfälle.
So funktioniert DCQCNDeep-Buffer-Router zwischen Regionen
Zwischen Regionen läuft OcNOS-SP auf Deep-Buffer-Routern mit Jericho 2C+ und Qumran 2C, mit SR-MPLS, EVPN und BGP. Sieben OcNOS-SP-Router unterstützen 400G ZR/ZR+.
ZR-Unterstützung nach Plattform ansehenWas OcNOS AI Fabric nicht abdeckt
Diese Grenzen helfen Ihnen, den Rest des Clusters zu planen.
- InfiniBand
- Es ist eine Ethernet-Fabric. InfiniBand wird nicht geswitcht.
- Kollektive Operationen
- Sie übernimmt die Switch-Seite. Die Collective Library (xCCL: NCCL, RCCL oder oneCCL) und der RDMA-Endpunkt laufen auf NIC und Host. Der Cluster-Scheduler platziert die Jobs.
- Scale-up
- Sie verbindet Server. GPU-zu-GPU-Links innerhalb eines Servers oder Racks (Scale-up-Links) liegen außerhalb der Fabric.
- Ultra Ethernet
- Sie läuft heute mit RoCEv2. Der Ultra-Ethernet-Transport läuft auf UEC-fähigen NICs. IP Infusion ist Mitglied des Ultra Ethernet Consortium.
- Tomahawk 6 und GLB
- Tomahawk 6 wird noch nicht unterstützt. Die Unterstützung in OcNOS-DC ist für OcNOS 7.2 geplant. GLB kommt mit OcNOS 7.1.
- Nur Tomahawk 5
- Dynamic ECN und Reactive Path Rebalance laufen nur auf Tomahawk-5-Switches.
- GPU-Anzahlen
- Die GPU-Anzahlen auf dieser Seite sind Obergrenzen der Referenzdesigns aus der Clos-Radix-Rechnung, keine Messwerte. Optiken und Kabel auf der GPU-Seite sind nicht mitgezählt.
Passend zu Ihrer GPU-Anzahl dimensionieren
Wählen Sie eine Cluster-Größe und sehen Sie, welche Fabric dafür nötig ist. Dimensionieren Sie anschließend Ihre eigene in der Design Suite, einschließlich der Anzahl von Links, Transceivern und Kabeln.
- 16 Spines mit je 64 × 800G.
- 32 Leaves mit je 32 × 800G nach unten, aufgeteilt in 2 × 400G pro GPU, und 32 × 800G nach oben.
- 128 Server mit je 8 GPUs und 8 NICs.
1.024 GPUs
- 32
- Leaves
- 16
- Spines
- 48
- Switches
Zwei Stufen
4.096 GPUs
- 128
- Leaves
- 64
- Spines
- 192
- Switches
Zwei Stufen, die Obergrenze auf Tomahawk 5
16.384 GPUs
- 1:1
- je Pod
- ~2:1
- Super-Spine
Drei Ebenen, die Obergrenze des Referenzdesigns. Switch-Anzahl je Design, mit einem Ingenieur von IP Infusion.
Rail-optimierte Referenzdesigns auf Tomahawk 5. Die GPU-Anzahlen sind Obergrenzen der Referenzdesigns aus der Clos-Radix-Rechnung, keine Messwerte.
Qualifizierte 800G- und 400G-Switches
Tomahawk-5-Leaf- und -Spine-Switches sowie ein Tomahawk-4-Leaf-Switch von Edgecore und UfiSpace.
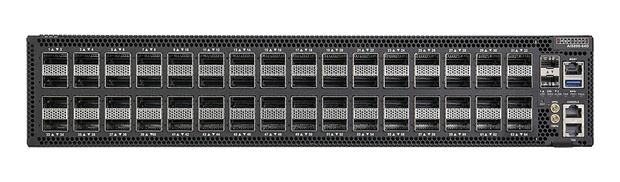
Edgecore AIS800-64D
64 x 800G · 51.2 Tbps
QSFP-DD800 · Breakout auf 2x400G / 4x200G / 8x100G
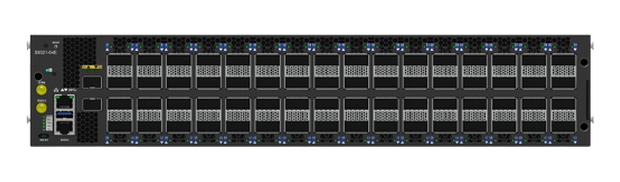
UfiSpace S9321-64E
64 x 800G · 51.2 Tbps
QSFP-DD800 · Breakout auf 2x400G / 4x200G / 8x100G
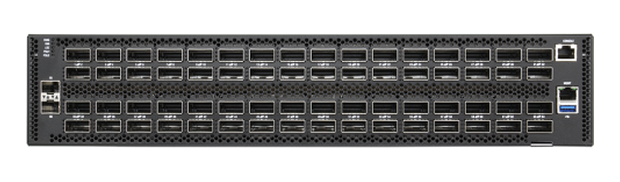
Edgecore AS9736-64D
64 x 400G · 25.6 Tbps
QSFP56-DD 400G · Breakout auf 4x100G
Alle 18 qualifizierten OcNOS-DC-Switches ansehen →
Ein System, ein Vertrag
Ein Supportweg
OcNOS-DC vorinstalliert und qualifiziert pro Switch-Modell und ASIC-Stepping. Eine Bestellung (PO), ein Supportvertrag, ein RMA-Weg. P1-Reaktionszeit von 8 Stunden (Standard) bis 30 Minuten (Enterprise).
Support-Details ansehenEine Konsole für die gesamte Flotte
IP Maestro verwaltet Topologie, Störungen, Konfiguration und Software-Images über NETCONF, unterhalb Ihres OSS.
IP Maestro erkundenOptiken mit erprobter Multi-Vendor-Interoperabilität
Optiken mehrerer Anbieter haben ihre Interoperabilität nachgewiesen. Fragen Sie uns nach der Transceiver-Liste für Ihren Aufbau.
Transceiver-Liste anfragenBringen Sie das Design zu Ihrem Team
Kurze PDFs. Ein kurzes Formular, dann startet der Download.
Häufig gestellte Fragen
Die gesamte AI-Fabric mit OcNOS entwerfen
Vom Business Case bis zur Portanzahl-Berechnung: Steigen Sie dort ein, wo Sie beim Aufbau gerade stehen.
Planen Sie Ihre GPU-Fabric mit unseren Ingenieuren
Stellen Sie Ihre Designfragen einem IP Infusion Ingenieur, oder nehmen Sie das Referenzdesign mit zu Ihrem Team.
AI-Fabric-Referenzdesign
Kurzes Formular. Ihr PDF öffnet sich direkt nach dem Absenden.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
Ethernet-basierte verlustfreie 800G-AI-Fabric mit OcNOS
Kurzes Formular. Ihr PDF wird unmittelbar nach dem Absenden heruntergeladen.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
EVPN-VXLAN-Data-Center-Fabric
Kurzes Formular. Ihr PDF wird unmittelbar nach dem Absenden heruntergeladen.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
DCI der nächsten Generation mit IPoDWDM
Kurzes Formular. Ihr PDF wird unmittelbar nach dem Absenden heruntergeladen.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
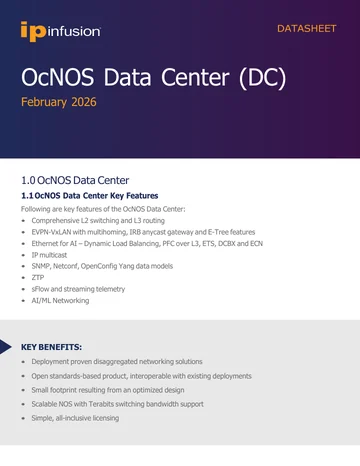
OcNOS-DC-Datenblatt
Kurzes Formular. Ihr PDF wird unmittelbar nach dem Absenden heruntergeladen.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
Möchten Sie, dass wir Sie kontaktieren?
Hinterlassen Sie Ihre Kontaktdaten, und ein Mitarbeiter des IP-Infusion-Teams unterstützt Sie gerne beim Design Ihrer AI-Fabric. Wir melden uns nur, wenn Sie es wünschen.