面向 GPU 集群的无损 800G 以太网 fabric
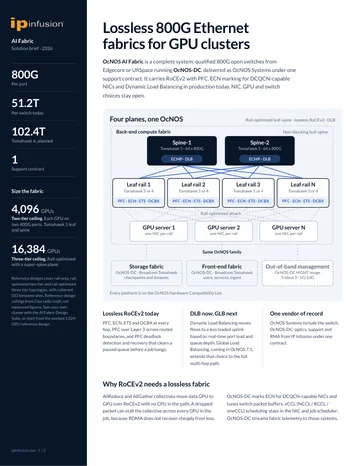
OcNOS AI Fabric 是 IP Infusion 提供的完整 AI fabric:在 Edgecore 或 UfiSpace 经过认证的 800G 和 400G Broadcom Tomahawk 交换机上预装 OcNOS-DC,提供无损 RoCEv2、动态负载均衡以及 PFC 死锁检测与恢复,并由一份支持合同覆盖。NIC 和 GPU 仍由您自行选择。
- 最适用于
- 基于无损 800G 或 400G 以太网构建 GPU 集群、可自由选择 NIC 与 GPU 的团队。
- 认证机型
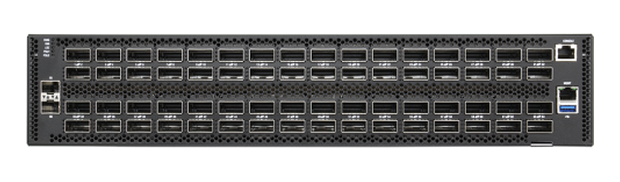
- Edgecore AIS800-64DUfiSpace S9321-64EEdgecore AS9736-64D
GPU fabric 必须做好的事
AI fabric 是连接 GPU 服务器的以太网。它必须无丢包地承载 RoCEv2 流量,并让每条链路保持繁忙,因为一个丢包就会让集合通信在 NIC 重发期间停滞,一条拥塞链路就会拖慢整个训练作业。
有三种流量模式会让训练作业停滞。OcNOS-DC 针对每一种都有对应方案。
相同的流量,相同的四条上行链路。区别在于流量如何分配。
静态 ECMP 按哈希将每条大流固定到一条上行链路,结果两条上行链路拥堵,另外两条几乎空闲。
DLB 根据实时端口负载和队列深度为每条上行链路评分,并将 flowlet 移到负载较低的路径,使负载趋于均衡。
示意图。
→ ECN 标记 在缓冲区填满之前通知支持 DCQCN 的 NIC 降速。
→ PFC 死锁检测与恢复 可自动清除卡住的队列。
GLB 将在 OcNOS 7.1 中推出,可在整个 fabric 范围内均衡负载。 了解 GLB →
每块 GPU NIC 独占一条 rail
每台 GPU 服务器分别向八台 rail leaf 各接入一块 NIC。同 rail 的 AllReduce 流量留在本 leaf 上;只有跨 rail 流量才会到达 800G Tomahawk 5 spine。pod 可在同一批交换机上扩展。
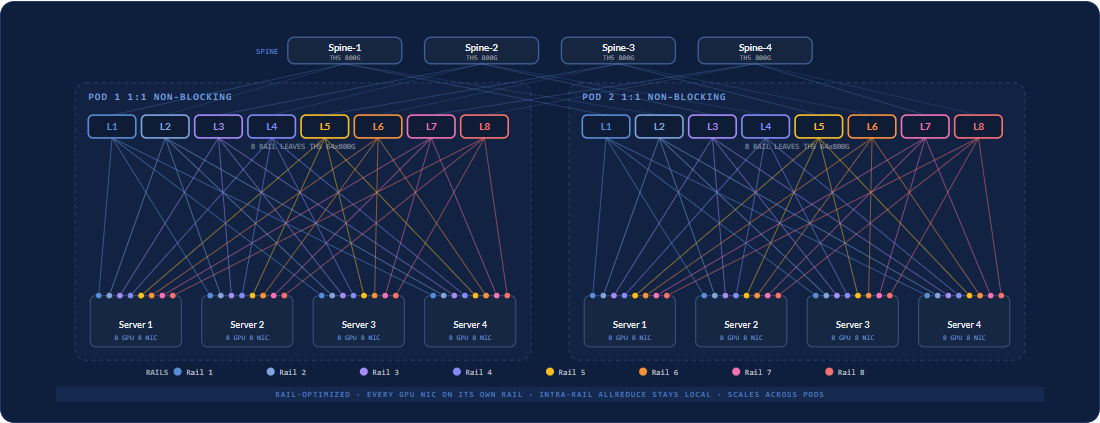
一个 1,024-GPU 的 rail-optimized 网络,逐台交换机详解:端口计算、组件数量、扩展至 4,096 GPU 及更大规模、平台与 OcNOS-DC 版本,以及 RoCEv2 无损起始配置。
技术概要
OcNOS-DC 在 fabric 中运行的功能。点击链接查看深入介绍。
截至 OcNOS-DC 7.0。来源(2026 年 10 月核对):OcNOS 功能矩阵(数据中心平台)、硬件兼容性列表和 AI Fabric 参考设计。
| 领域 | OcNOS-DC | 深入介绍 |
|---|---|---|
| 芯片 | OcNOS AI Fabric 目前支持 Broadcom Tomahawk 5 和 Tomahawk 4 作为 AI leaf 和 spine。Tomahawk 6 支持计划在 OcNOS 7.2 中提供。来源:硬件兼容性列表、Tomahawk 6 页面 | 芯片 → |
| 无损传输 | RoCEv2,支持按优先级的 PFC、ECN 标记和 ETS。支持跨路由边界的 PFC over L3。来源:功能矩阵(PFC with QoS、PFC over L3、ECN、ETS) | RoCEv2 → |
| 拥塞控制 | 为支持 DCQCN 的 NIC 提供 ECN 标记,Tomahawk 5 上支持 Dynamic ECN。交换机报文缓冲区调优。来源:功能矩阵(ECN、Dynamic ECN、交换机数据包缓冲区调优) | DCQCN → |
| 负载均衡 | Tomahawk 4 和 5 上的动态负载均衡(DLB),支持 RoCEv2 目的 QP 哈希;Tomahawk 5 上支持 Reactive Path Rebalance。GLB 将在 OcNOS 7.1 中推出,把负载均衡扩展到整个 fabric。来源:功能矩阵(DLB、DLB Reactive Path Rebalance)、OcNOS-DC 系统管理指南、GLB 页面 | DLB → |
| 死锁保护 | PFC 死锁检测与恢复。来源:功能矩阵(PFC 死锁检测与恢复) | PFC 死锁 → |
| 服务器设置 | DCBX 通过 LLDP 与链路对端交换 PFC 和 ETS 设置。来源:功能矩阵(DCBX、用于 PFC over L3 的 DCBX) | |
| 遥测 | 基于 OpenConfig 模型的 gNMI 流式遥测:on-change、dial-in 和 dial-out。来源:功能矩阵(gNMI dial-in、dial-out 和 on-change,OpenConfig 模型) | 遥测 → |
| 自动化 | 支持 IPv4 和 IPv6 的 ZTP。从 Day 0 到 Day 2 的 Ansible playbook。IP Maestro 通过 NETCONF 管理。来源:功能矩阵(基于 IPv4 和 IPv6 的 ZTP、Ansible、NETCONF) | 自动化 → |
| AI 智能体 | gNMI 遥测、基于 YANG 模型的 NETCONF 以及具备自动回退的 commit confirmed,使 AI 智能体和 AIOps 工具能够读取、变更和回滚网络架构。来源:功能矩阵(NETCONF confirmed commit、CLI commit confirmed) | AI 智能体 → |
| 拓扑 | Rail-only、rail 优化两层以及 rail 优化三层。来源:AI Fabric 参考设计(2026 年 10 月) | 拓扑 → |
| 规模 | 两层可达 4,096 块 GPU,基于 Tomahawk 5 每块 GPU 800G。三层可达 16,384 块 GPU。 Reference-design ceilings from Clos radix math, not measured figures.来源:AI Fabric 参考设计(2026 年 10 月) | 规模规划 → |
| Ultra Ethernet | IP Infusion 是 Ultra Ethernet Consortium 的成员。来源:Ultra Ethernet 页面 | UEC → |
跨域扩展:一个 GPU 集群,分布于多栋建筑
大型 GPU 集群所需电力已超出单栋建筑的供电能力,因此运营商将多栋建筑和多个站点中的网络连接为一个集群。OcNOS-DC 运行各站点的 spine,OcNOS-SP 运行区域之间的深缓冲路由器。
直接插入 spine 端口的相干光模块
在经认证的 Tomahawk 4 和 Trident 4 交换机上,OcNOS-DC 支持 400G ZR/ZR+。在 Tomahawk 5 的 Edgecore AIS800-64D 和 UfiSpace S9321-64E 上,支持 800G ZR/ZR+。spine 直接连接 OLS / ROADM,无需转发器或 muxponder 机架。
相干 DCI 的工作原理路由链路上的拥塞信号
ECN 标记在全部 18 款经认证的 OcNOS-DC 交换机的路由接口上运行,因此支持 DCQCN 的网卡可以检测建筑之间路由链路上的拥塞。BGP 会话上的 BFD 可检测路径故障。
DCQCN 的工作原理区域之间的深缓冲路由器
在区域之间,OcNOS-SP 运行于具备 SR-MPLS、EVPN 和 BGP 的深缓冲 Jericho 2C+ 与 Qumran 2C 路由器上。七款 OcNOS-SP 路由器支持 400G ZR/ZR+。
按平台查看 ZR 支持OcNOS AI Fabric 不涵盖的内容
了解这些边界,有助于您规划集群的其余部分。
- InfiniBand
- 这是一个 Ethernet fabric,不交换 InfiniBand 流量。
- 集合通信
- 它负责交换机侧。集合通信库(xCCL:NCCL、RCCL 或 oneCCL)和 RDMA 端点运行在 NIC 和主机上,作业由集群调度器安排。
- 纵向扩展(scale-up)
- 它连接服务器。服务器或机架内部的 GPU 间链路(纵向扩展链路)不在 fabric 范围内。
- Ultra Ethernet
- 目前运行 RoCEv2。Ultra Ethernet 传输运行在支持 UEC 的 NIC 上。IP Infusion 是 Ultra Ethernet Consortium 的成员。
- Tomahawk 6 和 GLB
- 目前尚不支持 Tomahawk 6。OcNOS-DC 对其的支持计划在 OcNOS 7.2 中提供。GLB 将在 OcNOS 7.1 中推出。
- 仅限 Tomahawk 5
- Dynamic ECN 和 Reactive Path Rebalance 仅在 Tomahawk 5 交换机上运行。
- GPU 数量
- 本页的 GPU 数量是根据 Clos 基数计算得出的参考设计上限,并非实测数据。GPU 侧的光模块和线缆不计入。
按 GPU 数量规划规模
选择集群规模,查看所需的网络。然后在 Design Suite 中规划您自己的网络,包括链路、光模块和线缆数量。
- 16 台 spine,每台 64 × 800G。
- 32 台 leaf,每台 32 × 800G 下行(每个 GPU 拆分为 2 × 400G)和 32 × 800G 上行。
- 128 台服务器,每台 8 个 GPU 和 8 个 NIC。
1,024 块 GPU
- 32
- 叶交换机
- 16
- 台 spine
- 48
- 台交换机
两层
4,096 块 GPU
- 128
- 叶交换机
- 64
- 台 spine
- 192
- 台交换机
两层,Tomahawk 5 上的上限
16,384 块 GPU
- 1:1
- 每个 pod
- ~2:1
- 超级脊
三层架构,参考设计上限。每种设计的交换机数量,可咨询 IP Infusion 工程师。
基于 Tomahawk 5 的 rail-optimized 参考设计。GPU 数量是根据 Clos 基数计算得出的参考设计上限,并非实测数据。
已认证的 800G 和 400G 交换机
来自 Edgecore 和 UfiSpace 的 Tomahawk 5 leaf 与 spine,以及一款 Tomahawk 4 leaf。
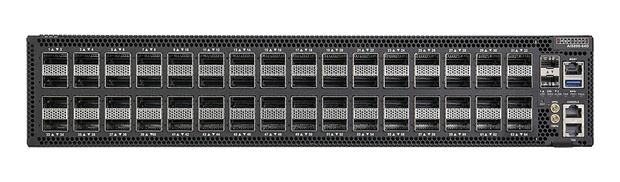
Edgecore AIS800-64D
64 x 800G · 51.2 Tbps
QSFP-DD800 · 拆分为 2x400G / 4x200G / 8x100G
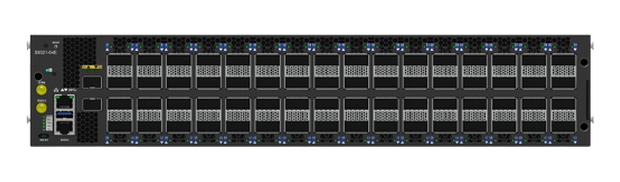
UfiSpace S9321-64E
64 x 800G · 51.2 Tbps
QSFP-DD800 · 拆分为 2x400G / 4x200G / 8x100G
一套系统,一份合同
统一的支持渠道
OcNOS-DC 按交换机型号和 ASIC 步进预装并完成认证。一份 PO、一份支持合同、一条 RMA 路径。P1 响应时间从 8 小时(Standard)到 30 分钟(Enterprise)。
查看支持详情将设计方案带给您的团队
简短的 PDF。填写简短表单后即开始下载。
常见问题
用 OcNOS 设计整张 AI fabric
从商业论证到端口数量测算,无论您进行到哪一步,都可从此接续。
AI Fabric参考设计
快速表单。提交后立即打开 PDF。
✓ 正在新标签页中打开您的 PDF……
如果未能自动打开,请使用下方链接。
OcNOS 800G 以太网无损 AI 网络
简短表单。提交后 PDF 将立即开始下载。
✓ 正在新标签页中打开您的 PDF……
如果未能自动打开,请使用下方链接。
EVPN-VXLAN 数据中心网络
简短表单。提交后 PDF 将立即开始下载。
✓ 正在新标签页中打开您的 PDF……
如果未能自动打开,请使用下方链接。
基于 IPoDWDM 的下一代 DCI
简短表单。提交后 PDF 将立即开始下载。
✓ 正在新标签页中打开您的 PDF……
如果未能自动打开,请使用下方链接。
OcNOS-DC 数据手册
简短表单。提交后 PDF 将立即开始下载。
✓ 正在新标签页中打开您的 PDF……
如果未能自动打开,请使用下方链接。
需要我们联系您吗?
请留下您的联系方式,IP Infusion 团队将很乐意帮助您设计 AI 网络架构。我们仅在您希望时才会与您联系。