Fabric Ethernet lossless a 800G per cluster GPU
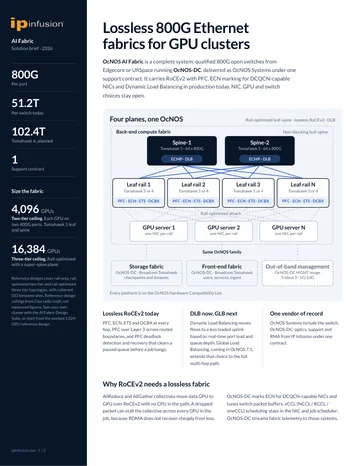
OcNOS AI Fabric è la fabric AI completa fornita da IP Infusion: OcNOS-DC preinstallato su switch Broadcom Tomahawk qualificati da 800G e 400G di Edgecore o UfiSpace, con RoCEv2 lossless, bilanciamento dinamico del carico e rilevamento e ripristino dei deadlock PFC, con un unico contratto di supporto. NIC e GPU restano una vostra scelta.
- Ideale per
- Team che realizzano cluster GPU su Ethernet 800G o 400G senza perdite, con le NIC e le GPU di loro scelta.
- Qualificato su
- Edgecore AIS800-64DUfiSpace S9321-64EEdgecore AS9736-64D
Che cosa deve garantire una fabric GPU
Una AI fabric è la rete Ethernet che collega i server GPU. Deve trasportare il traffico RoCEv2 senza perdite e mantenere attivo ogni collegamento, perché un solo pacchetto scartato blocca un'operazione collettiva mentre la NIC lo ritrasmette, e un solo collegamento congestionato rallenta l'intero job di training.
Tre schemi di traffico bloccano i job di training. OcNOS-DC ha una soluzione per ciascuno.
Stesso traffico, stessi quattro uplink. Cambia solo il modo in cui i flussi vengono distribuiti.
L'ECMP statico vincola ogni flusso di grandi dimensioni a un uplink tramite hash, così due uplink si saturano mentre due restano quasi inattivi.
DLB valuta ogni uplink in base al carico della porta e alla profondità della coda in tempo reale e sposta i flowlet sui percorsi meno carichi, così il carico si bilancia.
A scopo illustrativo.
→ DLB sposta i flowlet dagli uplink congestionati ai percorsi meno carichi.
→ Marcatura ECN segnala alle NIC compatibili con DCQCN di rallentare prima che i buffer si riempiano.
→ rilevamento e ripristino dei deadlock PFC sblocca autonomamente una coda bloccata.
→ PFC ed ECN mantengono il traffico RoCEv2 lossless.
GLB, in arrivo con OcNOS 7.1, bilancerà il carico sull'intera fabric. Informazioni su GLB →
Ogni NIC GPU sul proprio rail
Ogni server GPU collega una NIC a ciascuno degli otto rail leaf. L'AllReduce sullo stesso rail resta sul proprio leaf; solo il traffico tra rail diversi raggiunge gli spine Tomahawk 5 a 800G. I pod scalano sugli stessi switch.
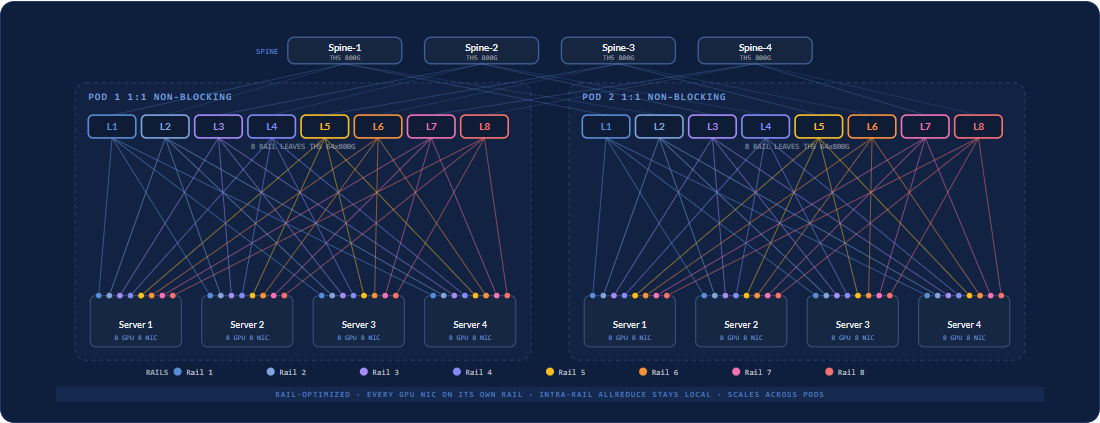
Un fabric rail-optimized da 1,024 GPU, spiegato switch per switch: calcolo delle porte, conteggio dei componenti, scalabilità a 4,096 GPU e oltre, piattaforme ed edizioni di OcNOS-DC e un profilo iniziale RoCEv2 lossless.
Riepilogo tecnico
Che cosa esegue OcNOS-DC nella fabric. Seguite un link per l'approfondimento.
Aggiornato a OcNOS-DC 7.0. Fonti, verificate a ottobre 2026: la matrice funzionalità OcNOS (piattaforme data center), l'elenco di compatibilità hardware e il design di riferimento per fabric AI.
| Ambito | OcNOS-DC | Approfondimento |
|---|---|---|
| Silicio | OcNOS AI Fabric supporta oggi Broadcom Tomahawk 5 e Tomahawk 4 per leaf e spine AI. Il supporto per Tomahawk 6 è previsto in OcNOS 7.2.Fonti: elenco di compatibilità hardware, pagina Tomahawk 6 | Silicio → |
| Trasporto lossless | RoCEv2 con PFC per priorità, marcatura ECN ed ETS. PFC su L3 attraverso i confini instradati.Fonte: matrice funzionalità (PFC with QoS, PFC over L3, ECN, ETS) | RoCEv2 → |
| Controllo della congestione | Marcatura ECN per NIC compatibili con DCQCN, con Dynamic ECN su Tomahawk 5. Ottimizzazione del buffer dei pacchetti dello switch.Fonte: matrice funzionalità (ECN, Dynamic ECN, ottimizzazione del buffer pacchetti dello switch) | DCQCN → |
| Bilanciamento del carico | Bilanciamento dinamico del carico (DLB) su Tomahawk 4 e 5, con hashing RoCEv2 per QP di destinazione, e Reactive Path Rebalance su Tomahawk 5. GLB, in arrivo con OcNOS 7.1, lo estende all'intera fabric.Fonti: matrice funzionalità (DLB, DLB Reactive Path Rebalance), guida alla gestione del sistema OcNOS-DC, pagina GLB | DLB → |
| Protezione dai deadlock | Rilevamento e ripristino dei deadlock PFC.Fonte: matrice funzionalità (rilevamento e ripristino dei deadlock PFC) | Deadlock PFC → |
| Impostazioni dei server | DCBX scambia le impostazioni PFC ed ETS con il peer del collegamento tramite LLDP.Fonte: matrice funzionalità (DCBX, DCBX per PFC over L3) | |
| Telemetria | Streaming gNMI su modelli OpenConfig: on-change, dial-in e dial-out.Fonte: matrice funzionalità (gNMI dial-in, dial-out e on-change, modelli OpenConfig) | Telemetria → |
| Automazione | ZTP su IPv4 e IPv6. Playbook Ansible dal Day 0 al Day 2. IP Maestro su NETCONF.Fonte: matrice funzionalità (ZTP su IPv4 e IPv6, Ansible, NETCONF) | Automazione → |
| Agenti AI | Telemetria gNMI, NETCONF con modelli YANG e commit confirmed con ripristino automatico, così gli agenti AI e gli strumenti AIOps possono leggere, modificare e ripristinare il fabric.Fonte: matrice funzionalità (NETCONF confirmed commit, CLI commit confirmed) | Agenti AI → |
| Topologie | Rail-only, rail-optimized a due livelli e rail-optimized a tre livelli.Fonte: design di riferimento per fabric AI, ottobre 2026 | Topologie → |
| Scalare | Due livelli fino a 4.096 GPU a 800G per GPU su Tomahawk 5. Tre livelli fino a 16.384 GPU. Reference-design ceilings from Clos radix math, not measured figures.Fonte: design di riferimento per fabric AI, ottobre 2026 | Dimensionamento → |
| Ultra Ethernet | IP Infusion è membro dell'Ultra Ethernet Consortium.Fonte: pagina Ultra Ethernet | UEC → |
Scale-across: un cluster GPU su più edifici
I grandi cluster GPU richiedono ormai più energia di quanta un singolo edificio possa fornire, quindi gli operatori uniscono i fabric di più edifici e siti in un unico cluster. OcNOS-DC gestisce le spine di ogni sito e OcNOS-SP i router a buffer profondo tra le regioni.
Ottiche coherent nella porta della spine
Sugli switch Tomahawk 4 e Trident 4 qualificati, OcNOS-DC supporta 400G ZR/ZR+. Sui Tomahawk 5 Edgecore AIS800-64D e UfiSpace S9321-64E supporta 800G ZR/ZR+. La spine si collega direttamente all'OLS / ROADM, senza shelf di transponder o muxponder.
Come funziona il DCI coherentSegnali di congestione sui link instradati
La marcatura ECN funziona sulle interfacce instradate di tutti i 18 switch OcNOS-DC qualificati, così le NIC compatibili con DCQCN rilevano la congestione sui link instradati tra edifici. BFD sulle sessioni BGP rileva i guasti di percorso.
Come funziona DCQCNRouter a buffer profondo tra le regioni
Tra le regioni, OcNOS-SP gira su router Jericho 2C+ e Qumran 2C a buffer profondo con SR-MPLS, EVPN e BGP. Sette router OcNOS-SP supportano 400G ZR/ZR+.
Vedi il supporto ZR per piattaformaCosa OcNOS AI Fabric non fa
Questi limiti aiutano a pianificare il resto del cluster.
- InfiniBand
- È una fabric Ethernet. Non commuta InfiniBand.
- Operazioni collettive
- Gestisce il lato switch. La libreria collettiva (xCCL: NCCL, RCCL o oneCCL) e l'endpoint RDMA girano sulla NIC e sull'host. Lo scheduler del cluster colloca i job.
- Scale-up
- Collega i server. I collegamenti GPU-GPU all'interno di un server o di un rack (collegamenti scale-up) sono esterni alla fabric.
- Ultra Ethernet
- Oggi funziona con RoCEv2. Il trasporto Ultra Ethernet funziona su NIC compatibili con UEC. IP Infusion è membro dell'Ultra Ethernet Consortium.
- Tomahawk 6 e GLB
- Tomahawk 6 non è ancora supportato. Il supporto in OcNOS-DC è previsto in OcNOS 7.2. GLB arriva con OcNOS 7.1.
- Solo Tomahawk 5
- Dynamic ECN e Reactive Path Rebalance funzionano solo sugli switch Tomahawk 5.
- Numero di GPU
- Il numero di GPU in questa pagina è il limite massimo dei progetti di riferimento, ricavato dal calcolo del radix Clos, non un valore misurato. Ottiche e cavi lato GPU non sono conteggiati.
Dimensionatela in base al numero di GPU
Scegli la dimensione del cluster e scopri il fabric necessario. Poi dimensiona il tuo nel Design Suite, inclusi i conteggi di link, transceiver e cavi.
- 16 spine, ciascuno con 64 × 800G.
- 32 leaf, ciascuno con 32 × 800G verso il basso, suddivisi in 2 × 400G per GPU, e 32 × 800G verso l'alto.
- 128 server, ciascuno con 8 GPU e 8 NIC.
1.024 GPU
- 32
- leaf
- 16
- spine
- 48
- switch
Due livelli
4.096 GPU
- 128
- leaf
- 64
- spine
- 192
- switch
Due livelli, il limite massimo su Tomahawk 5
16.384 GPU
- 1:1
- ogni pod
- ~2:1
- super-spine
Tre livelli, il limite massimo del progetto di riferimento. Numero di switch per progetto, con un ingegnere di IP Infusion.
Progetti di riferimento rail-optimized su Tomahawk 5. Il numero di GPU è il limite massimo dei progetti di riferimento, ricavato dal calcolo del radix di Clos, non un valore misurato.
Switch da 800G e 400G qualificati
Leaf e spine Tomahawk 5 e un leaf Tomahawk 4, di Edgecore e UfiSpace.
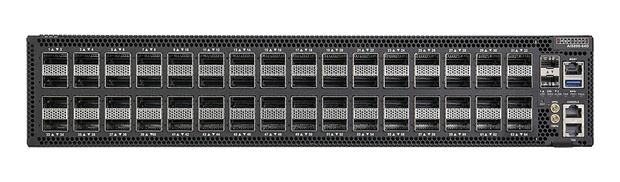
Edgecore AIS800-64D
64 x 800G · 51.2 Tbps
QSFP-DD800 · breakout a 2x400G / 4x200G / 8x100G
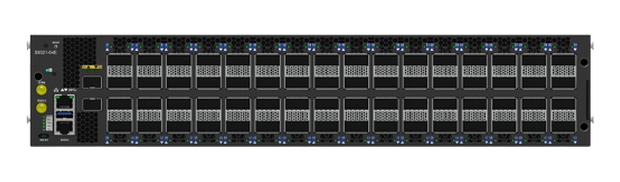
UfiSpace S9321-64E
64 x 800G · 51.2 Tbps
QSFP-DD800 · breakout a 2x400G / 4x200G / 8x100G
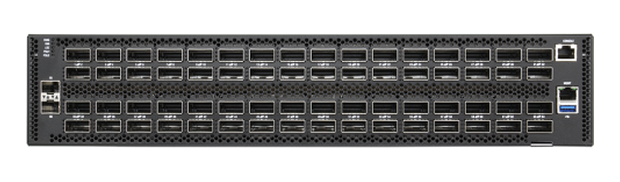
Edgecore AS9736-64D
64 x 400G · 25.6 Tbps
QSFP56-DD 400G · breakout a 4x100G
Vedi tutti i 18 switch OcNOS-DC qualificati →
Un sistema, un contratto
Un unico percorso di supporto
OcNOS-DC preinstallato e qualificato per ogni modello di switch e stepping dell'ASIC. Un solo PO, un solo contratto di supporto, un solo percorso RMA. Tempo di risposta P1 da 8 ore (Standard) a 30 minuti (Enterprise).
Vedi i dettagli del supportoUna sola console per l'intero parco
IP Maestro gestisce topologia, guasti, configurazione e immagini software tramite NETCONF, al di sotto del vostro OSS.
Esplora IP MaestroOttiche con interoperabilità multi-vendor comprovata
Le ottiche di più fornitori hanno un'interoperabilità comprovata. Richiedeteci l'elenco dei transceiver per il vostro progetto.
Richiedere l'elenco dei transceiverCondividete il design con il vostro team
PDF brevi. Un modulo rapido, poi il download si avvia.
Domande frequenti
Progettate l'intera fabric AI con OcNOS
Dal business case al calcolo del numero di porte, riprendete da qualunque punto della realizzazione.
Pianifica la tua fabric GPU con i nostri ingegneri
Porta le tue domande di progettazione a un ingegnere IP Infusion, oppure condividi il design di riferimento con il tuo team.
Design di riferimento per fabric AI
Modulo rapido. Il PDF si apre subito dopo l'invio.
✓ Apertura del vostro PDF in una nuova scheda…
Se non si è aperto, usate il link qui sotto.
Fabric AI lossless OcNOS a 800G basata su Ethernet
Modulo breve. Il PDF verrà scaricato subito dopo l'invio.
✓ Apertura del vostro PDF in una nuova scheda…
Se non si è aperto, usate il link qui sotto.
Fabric data center EVPN-VXLAN
Modulo breve. Il PDF verrà scaricato subito dopo l'invio.
✓ Apertura del vostro PDF in una nuova scheda…
Se non si è aperto, usate il link qui sotto.
DCI di nuova generazione con IPoDWDM
Modulo breve. Il PDF verrà scaricato subito dopo l'invio.
✓ Apertura del vostro PDF in una nuova scheda…
Se non si è aperto, usate il link qui sotto.
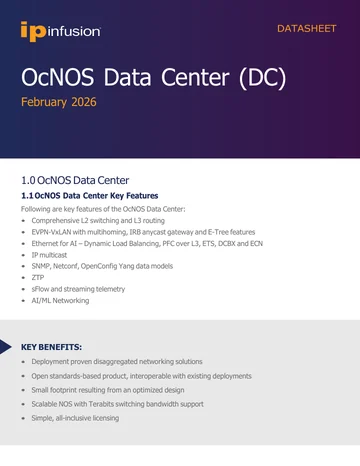
Datasheet OcNOS-DC
Modulo breve. Il PDF verrà scaricato subito dopo l'invio.
✓ Apertura del vostro PDF in una nuova scheda…
Se non si è aperto, usate il link qui sotto.
Desiderate essere ricontattati?
Lasciate i vostri dati e un membro del team di IP Infusion sarà lieto di aiutarvi a progettare la vostra fabric AI. Vi contatteremo solo se lo desiderate.