Topologie AI Fabric: design rail-optimized e scheduled
Abbinate la topologia al numero di GPU: un pod leaf-spine rail-optimized fino a circa 1,000 GPU, un Clos a 5 stadi fino a 16,000+ e DCI coerente per estendersi tra le sedi. Scegliete il design non bloccante più piccolo che mantiene saturo il link di ogni GPU durante le collettive. Tutti e tre girano su OcNOS-DC su un fabric L3 RoCEv2 lossless (PFC + ECN), dimensionati qui con conteggi di porte concreti su Broadcom Tomahawk 4 e Tomahawk 5.
Il design non bloccante più piccolo adatto al vostro numero di GPU
Una topologia di fabric AI ha un solo compito: mantenere saturo il link in uscita di ogni GPU durante una collettiva senza creare outlier di tail latency. La topologia giusta è la più piccola che lo fa per il vostro numero di GPU, con un percorso di ripiego per la taglia successiva. Quattro punti di riferimento, con calcoli concreti delle porte su silicio Broadcom Tomahawk.
Il tetto leaf-spine a due livelli è di circa 2,048 GPU con una porta di fabric 800G per GPU; oltre, aggiungete il livello super-spine. La stessa immagine OcNOS-DC gira su ogni livello, così il fabric scala con il cluster anziché essere riprogettato a ogni passo.
State dimensionando il vostro cluster? La Suite di progettazione per fabric AI offre una prima stima rapida: dimensiona un pod leaf-spine a due livelli non bloccante assumendo una NIC di fabric per GPU e segnala quando si supera la scala a tre livelli. I reference design qui sotto usano la stessa matematica leaf/spine non bloccante e la estendono a un Clos a 5 stadi su larga scala, così i conteggi degli switch coincidono con lo strumento. Rail-optimized qui è la disciplina di cablaggio di un server GPU a 8 NIC (un rail per leaf, così l'AllReduce intra-rail resta sul leaf) sovrapposta a quel fabric non bloccante: cambia la località del traffico, non il numero di switch. Usate lo strumento per una stima di massima; usate questi design per la realizzazione.
Rail-optimized, Clos scheduled e DCI coerente
OcNOS-DC viene fornito su tre topologie di riferimento che coprono fabric AI single-pod, multi-pod e multi-sede. Ognuna è una realizzazione concreta, dimensionata su hardware Broadcom presente nell'HCL, non uno schizzo su lavagna.
Pod singolo ottimizzato per rail
Di ogni server GPU, le 8 NIC si attestano su 8 leaf rail dedicati, così che l'AllReduce sullo stesso rail resta su un unico leaf e non attraversa mai lo spine. Uno spine non bloccante trasporta i flussi cross-rail. L'unità scalabile a pod singolo, fino a circa 1,000 GPU.
Clos a 5 stadi schedulato
Leaf, spine e super-spine i tier scalano da 4.096 a 16.384 GPU. Non bloccante all'interno di ogni pod, con il piano super-spine che imposta il rapporto cross-pod. DLB a ogni hop, GLB end-to-end in OcNOS 7.1.
DCI coerente multi-DC
Quando un'esecuzione di training si estende su più sale dati, estendi il fabric con ottiche coerenti 400G ZR / ZR+ sullo spine. DCI senza transponder tra i siti, con il Clos a 5 stadi interno al sito invariato.
Pod singolo ottimizzato per rail
Ogni server GPU dispone di 8 NIC, una per rail (un canale collettivo xCCL (NCCL / RCCL / oneCCL) dedicato). Ogni rail è un proprio leaf dedicato, quindi tutte le 8 NIC di ciascun server si attestano su un leaf diverso. L'AllReduce sul rail-N resta all'interno del leaf-N, per cui non c'è pressione est-ovest sullo spine per il pattern collettivo dominante.
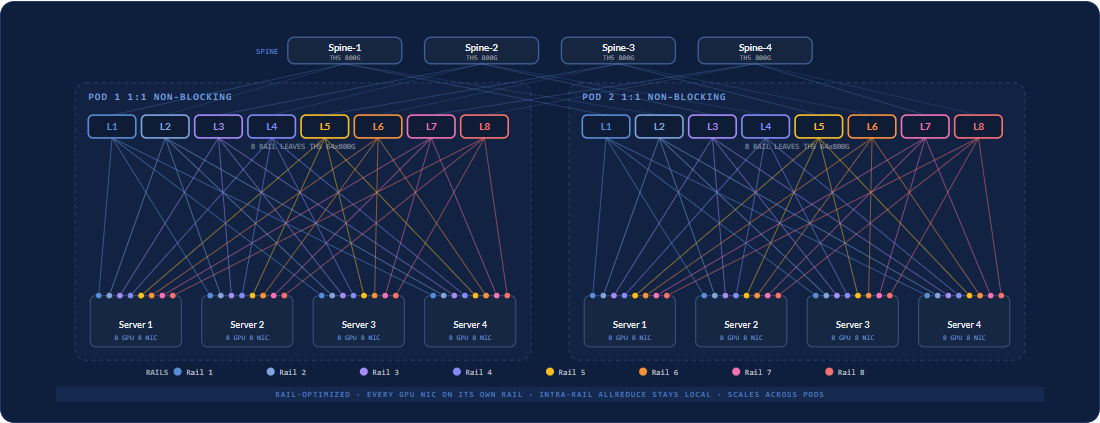
Componenti OcNOS: underlay L3 BGP-unnumbered, RoCEv2 lossless (PFC + ECN) su ogni leaf, DLB al tier spine. Realizzato su hardware elencato nella HCL: l'unità scalabile 800G usa leaf e spine TH5 64x800G (Edgecore AIS800-64D o UfiSpace S9321-64E); il pod entry-level da 256 GPU usa Edgecore AS9736-64D (TH4, 64x400G).
Fabric schedulato Clos a 5 stadi: da 4,096 a 16,384 GPU
L'approccio ottimizzato per rail smette di scalare da qualche parte tra 1k e 2k GPU: si esaurisce il radix dei leaf, oppure il tier spine diventa troppo in oversubscription. Oltre quel punto, la maggior parte dei fabric AI moderni passa a un Clos a 5 stadi: leaf, spine, super-spine. Due GPU qualsiasi distano al massimo quattro hop di switch; i peer sullo stesso leaf e sullo stesso pod sono più vicini.
La parte difficile in un Clos è distribuire i flussi in modo uniforme perché nessun link diventi un hot spot. Gli approcci vanno dall'ECMP per flusso, al bilanciamento del carico adattivo (dinamico), fino al packet spray per pacchetto, il modello che Ultra Ethernet usa con il riordino gestito dalla NIC. Una famiglia a parte, i fabric schedulati a celle come Broadcom DDC, segmenta il traffico in celle e lo schedula all'interno del fabric. OcNOS mantiene bilanciato il piano GPU con DLB e aggiunge il GLB a livello di fabric in OcNOS 7.1.
Il diagramma è schematico: rappresenta un numero ridotto di tier. La build da 4,096 GPU è composta da 128 leaf / 64 spine / 32 super-spine su TH5 800G.
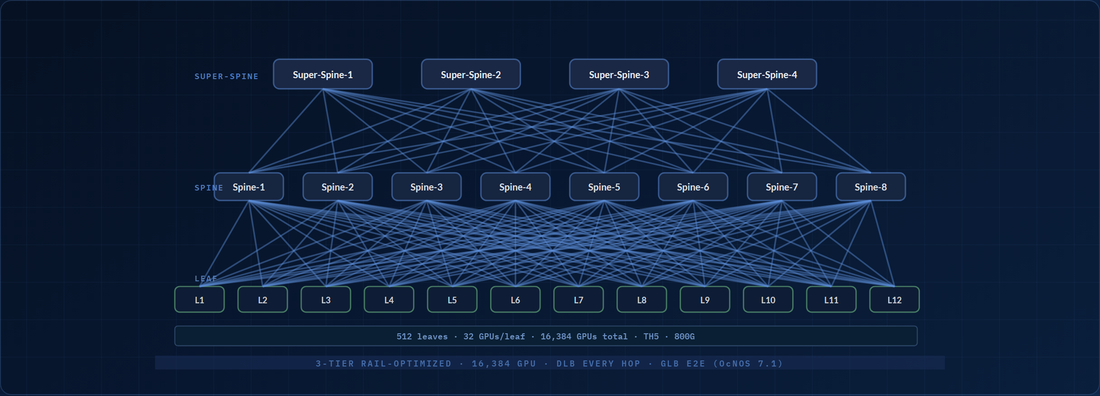
Componenti OcNOS: underlay L3 eBGP-unnumbered, RoCEv2 lossless (PFC + ECN), DLB a ogni tier, GLB end-to-end in OcNOS 7.1 e telemetria in streaming gNMI verso il vostro stack di observability. Realizzato interamente su chassis TH5 64x800G elencati nella HCL.
La subscription è una manopola, non una regola fissa. Questi valori rendono ogni pod da 1,024 GPU non bloccante 1:1 e usano un super-spine ~2:1 ottimizzato per i costi per il traffico cross-pod, l'approccio ottimizzato per rail su cui si basano i fabric Ethernet hyperscale (i progetti su larga scala pubblicati mettono in oversubscription il tier superiore molto di più, perché il traffico collettivo resta locale al pod). Volete invece il massimo margine any-to-any? Una build completamente non bloccante 1:1 è 128 / 128 / 64 con 4,096 GPU e 512 / 512 / 256 con 16,384; cambiano solo i conteggi di spine e super-spine. Modellatele entrambe nel Suite di progettazione per fabric AI.
Fabric AI multi-DC: DCI coerente
Quando una singola esecuzione di training si estende su più di una sala dati, sempre più comune per i modelli da migliaia di miliardi di parametri, il fabric si estende attraverso la WAN. OcNOS-DC supporta ottiche coerenti 400G ZR / ZR+ direttamente sullo spine per un DCI senza transponder tra i siti. Il Clos a 5 stadi sottostante in ciascun sito rimane invariato.
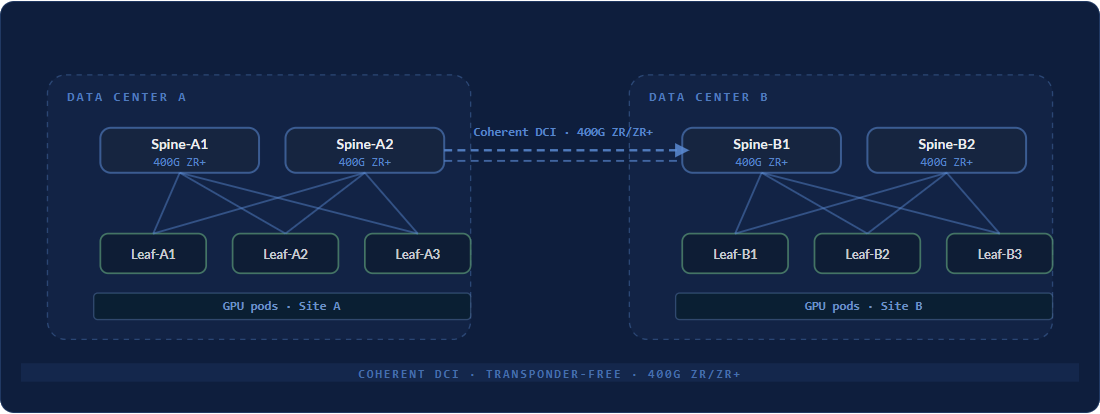
Componenti OcNOS: Ottiche coerenti pluggable 400G ZR/ZR+ su una porta spine o border-leaf con capacità DWDM, con telemetria gNMI tra i siti. Nessun transponder esterno richiesto. Portata: 400ZR fino a circa 120 km amplificati; OpenZR+ raggiunge distanze maggiori con oFEC.
Regole pratiche di progettazione
Poche regole mantengono un fabric AI dal lato giusto della curva di prestazioni e costi, qualunque sia il progetto di riferimento da cui parti.
- Adatti la topologia al numero di GPU. Pod più piccoli (sotto la radix NIC di un singolo leaf): solo rail è sufficiente. Scala a singolo pod: leaf-spine rail-optimized. Multi-pod: il Clos a 5 stadi è l'unico design che scala senza compromessi di oversubscription.
- Sempre subscription 1:1 sul piano AI. I rack di storage e CPU possono operare con rapporti di oversubscription più elevati. Il piano GPU non dovrebbe.
- Pianificate il numero di rail a partire da xCCL, non in base alla comodità del cablaggio. 8 rail è l'attuale standard de facto per i server GPU a 8 NIC. Non combinare i rail in un numero inferiore di leaf.
- Si scelga il silicio in base a potenza e densità, non al marchio. TH4 (25,6T) e TH5 (51,2T) sono i cavalli da lavoro; la scelta tra i due è una questione di potenza rack e costo dei cavi breakout.
- Pianificate GLB già in fase di progettazione. Costruite il telemetry plane fin dal primo giorno, anche su una fabric 7.0, così l'upgrade a OcNOS 7.1 GLB diventa un semplice passaggio software. Vedete GLB.
- Verificare rispetto all'HCL. Ogni riferimento qui è costruito su hardware elencato nel Elenco di compatibilità hardware OcNOS; partite da qui per un supporto di prima classe.
FAQ sulla topologia del fabric AI
Cos'è una topologia ottimizzata per rail e in cosa si differenzia da rail-only?
Fino a quante GPU può scalare un Clos a 5 stadi?
Dovrei usare Tomahawk 4 o Tomahawk 5?
Ho bisogno di InfiniBand o Ethernet è sufficiente?
Dove finisce lo scale-up e inizia lo scale-out?
Approfondite. Portatelo con voi.
Il datasheet di prodotto e download tecnici e sintetici che vanno oltre questa pagina.
Datasheet OcNOS-DC
Specifica completa di OcNOS-DC: il set di funzionalità EVPN-VXLAN e Ethernet for AI, gli SKU software, le piattaforme hardware supportate e la guida all'ordine della soluzione.
Ottieni il datasheetFabric AI senza perdite OcNOS 800G
Fabric RoCEv2 non bloccante su spine Broadcom Tomahawk 4/5: tier di SKU, piattaforme validate e architettura di deployment.
Scarica il briefFabric data center EVPN-VXLAN
Fabric leaf-spine carrier-grade per data center: IRB simmetrico, route Type-2/Type-5 e gateway anycast distribuito.
Scarica il briefDatasheet OcNOS-DC
Modulo rapido. Il vostro PDF si apre in una nuova scheda subito dopo l'invio.
✓ Apertura del vostro PDF in una nuova scheda…
Se non si è aperto, usate il link qui sotto.
Fabric AI senza perdite OcNOS 800G
Modulo rapido. Il vostro PDF si apre in una nuova scheda subito dopo l'invio.
✓ Apertura del vostro PDF in una nuova scheda…
Se non si è aperto, usate il link qui sotto.
Fabric data center EVPN-VXLAN
Modulo rapido. Il vostro PDF si apre in una nuova scheda subito dopo l'invio.
✓ Apertura del vostro PDF in una nuova scheda…
Se non si è aperto, usate il link qui sotto.
State progettando il vostro AI fabric? Calcoliamo insieme il numero di porte.
Comunicateci il workload e la scala di GPU e un ingegnere IP Infusion dimensionerà con voi i tier leaf, spine e super-spine, oppure partite da un primo layout con l'AI Fabric Design Suite.
Progettate l'intera fabric AI con OcNOS
Dal business case al calcolo del numero di porte, riprendete da qualunque punto della realizzazione.