Topologías de fabric de IA: diseños rail-optimized hasta 16K GPU
Ajuste la topología al número de GPU: un pod leaf-spine rail-optimized de dos niveles hasta 4.096 GPU, un tercer nivel super-spine por encima hasta 16.384, y DCI coherente para abarcar varios sitios. Elija el diseño sin bloqueo más pequeño que mantenga saturado el enlace de cada GPU durante los colectivos. Los tres corren sobre OcNOS-DC en una fabric L3 RoCEv2 sin pérdidas (PFC + ECN), dimensionados aquí en recuentos de puertos concretos sobre Broadcom Tomahawk 4 y Tomahawk 5.
El diseño sin bloqueo más pequeño que se ajusta a su recuento de GPU
Una topología de fabric de IA tiene una sola tarea: mantener saturado el enlace de salida de cada GPU durante una operación colectiva sin crear valores atípicos de latencia de cola. La topología correcta es la más pequeña que lo consigue para su número de GPU, con una ruta de respaldo para el siguiente tamaño. Tres puntos de referencia, con cálculos de puertos concretos sobre silicio Broadcom Tomahawk.
Un leaf-spine de dos niveles alcanza 4.096 GPU a 800G por GPU; un despliegue de 1.024 GPU son 32 leaves y 16 spines, 48 switches. Por encima de 4.096 GPU, añada el nivel super-spine. La misma imagen de OcNOS-DC se ejecuta en cada nivel, de modo que el fabric escala con el clúster en lugar de rediseñarse en cada paso.
¿Está dimensionando su propio cluster? La Suite de diseño de fabric de IA ofrece un primer dimensionamiento rápido: dimensiona un pod leaf-spine de dos niveles sin bloqueo e indica cuándo pasa a la escala de tres niveles. Los diseños de referencia siguientes usan el mismo cálculo leaf/spine sin bloqueo y añaden un nivel super-spine por encima de 4.096 GPU, de modo que el número de switches coincide con la herramienta. Aquí, rail-optimized es la disciplina de cableado de un servidor GPU con 8 NIC (un rail por leaf, de modo que el AllReduce intra-rail permanece en el leaf) superpuesta a ese fabric sin bloqueo: cambia la localidad del tráfico, no el número de switches. Use la herramienta para una estimación aproximada; use estos diseños para el despliegue.
Pod de dos niveles, fabric de tres niveles y DCI coherente
Tres topologías de referencia cubren fabrics de IA de un solo pod, multi-pod y multisitio, cada una dimensionada sobre hardware Broadcom incluido en la HCL.
Pod único rail-optimized
De cada servidor GPU, sus 8 NIC aterrizan en 8 rail leaves dedicados, de modo que el AllReduce del mismo rail permanece en un solo leaf y nunca atraviesa el spine. Un spine sin bloqueo transporta los flujos entre rails. La unidad escalable de un solo pod, hasta 4.096 GPU sobre Tomahawk 5.
Fabric rail-optimized de tres niveles
Los niveles de leaf, spine y super-spine llevan el fabric más allá de 4.096 GPU, hasta 16.384 en el diseño de referencia. Sin bloqueo dentro de cada pod, con el plano super-spine fijando la relación entre pods. DLB en cada salto, GLB de extremo a extremo en OcNOS 7.1.
DCI coherente multi-DC
Cuando un entrenamiento abarca salas de datos, extienda la fabric con óptica coherente 400G ZR / ZR+ en el spine. DCI sin transpondedores entre sitios, con el fabric interno del sitio sin cambios.
Pod único rail-optimized
Cada servidor GPU tiene 8 NIC, una por rail (un canal colectivo xCCL (NCCL / RCCL / oneCCL) dedicado). Cada rail es su propio leaf dedicado, de modo que las 8 NIC de cada servidor aterrizan en un leaf distinto. El AllReduce a través del rail-N se queda dentro del leaf-N, de modo que no hay presión este-oeste sobre el spine para el patrón colectivo dominante.
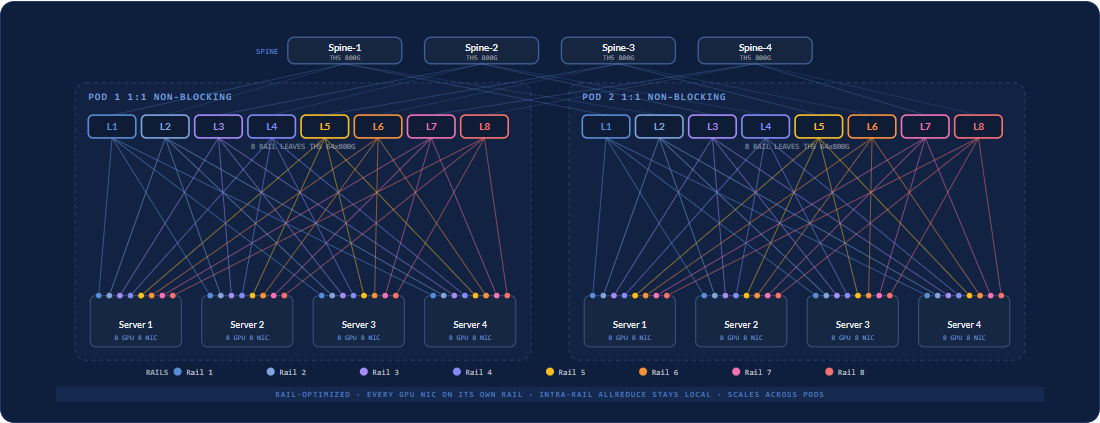
Componentes de OcNOS: Underlay L3 BGP-unnumbered, RoCEv2 sin pérdidas (PFC + ECN) en cada leaf, DLB en el nivel de spine. Construido sobre hardware listado en la HCL: la unidad escalable 800G usa leaves y spines TH5 64x800G (Edgecore AIS800-64D o UfiSpace S9321-64E); el pod de entrada de 256 GPU usa Edgecore AS9736-64D (TH4, 64x400G).
Fabric rail-optimized de tres niveles: por encima de 4.096 GPU
Un pod rail-optimized de dos niveles sobre Tomahawk 5 llega a su máximo en 4.096 GPU a 800G por GPU, cuando los spines se quedan sin puertos. Por encima de eso, el mismo diseño rail-optimized añade un tercer nivel: leaf, spine, super-spine. Dos GPU cualesquiera están como máximo a cuatro saltos de switch; los pares en el mismo leaf y en el mismo pod están más cerca.
La parte difícil en una red Clos es repartir los flujos de forma uniforme para que ningún enlace se convierta en un punto caliente. Los enfoques van desde ECMP por flujo, pasando por el balanceo de carga dinámico, hasta el packet spray por paquete, el modelo que usa Ultra Ethernet con el reordenamiento gestionado en la NIC. Una familia aparte, los fabrics programados basados en celdas como Broadcom DDC, segmenta el tráfico en celdas y lo programa dentro del fabric. OcNOS mantiene equilibrado el plano de GPU con DLB y añade GLB en todo el fabric en OcNOS 7.1.
El diagrama es esquemático: dibuja un número reducido de elementos por nivel. El despliegue de 16.384 GPU son 512 leaves / 256 spines / 128 super-spines sobre TH5 800G.
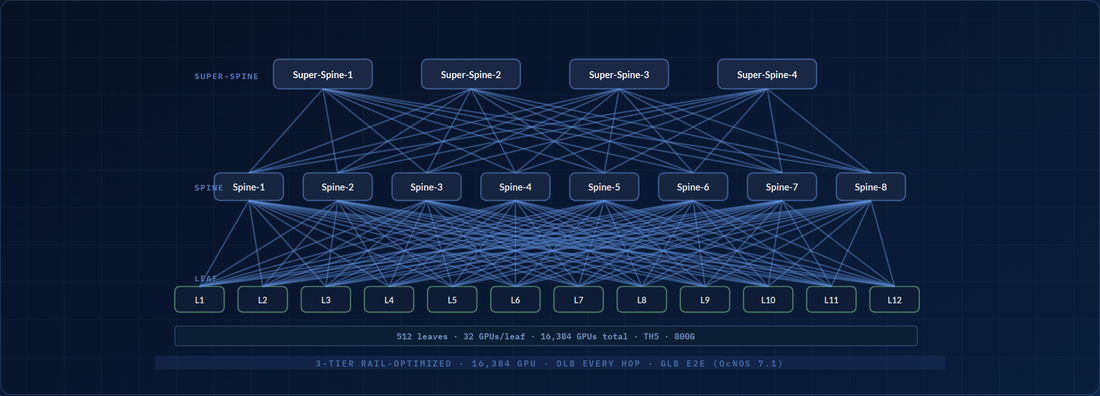
Componentes de OcNOS: Underlay L3 eBGP-unnumbered, RoCEv2 sin pérdidas (PFC + ECN), DLB en cada nivel, GLB extremo a extremo en OcNOS 7.1 y telemetría de streaming gNMI hacia su stack de observabilidad. Construido sobre chasis TH5 64x800G listados en la HCL en toda la fabric.
La suscripción es un dial, no una regla fija. Estas cifras hacen que cada pod de 1.024 GPU sea 1:1 sin bloqueo y usan un super-spine optimizado en coste de ~2:1 para el tráfico entre pods, el enfoque rail-optimized en el que se basan los fabrics Ethernet a hiperescala (los diseños publicados a gran escala sobresuscriben mucho más el nivel superior, porque el tráfico colectivo permanece local al pod). ¿Prefiere en su lugar el máximo margen any-to-any? Un despliegue 1:1 totalmente sin bloqueo son 512 / 512 / 256 con 16.384 GPU; solo cambian los números de spines y super-spines. Modele cualquiera de los dos en el Suite de diseño de fabric de IA.
Fabric de IA multi-DC: DCI coherente
Cuando una sola ejecución de entrenamiento abarca más de una sala de datos, algo cada vez más habitual en los modelos de un billón de parámetros, el fabric se extiende a través de la WAN. OcNOS-DC admite ópticas coherentes 400G ZR / ZR+ directamente en el spine para DCI sin transpondedores entre sitios. El fabric dentro de cada sitio no cambia.
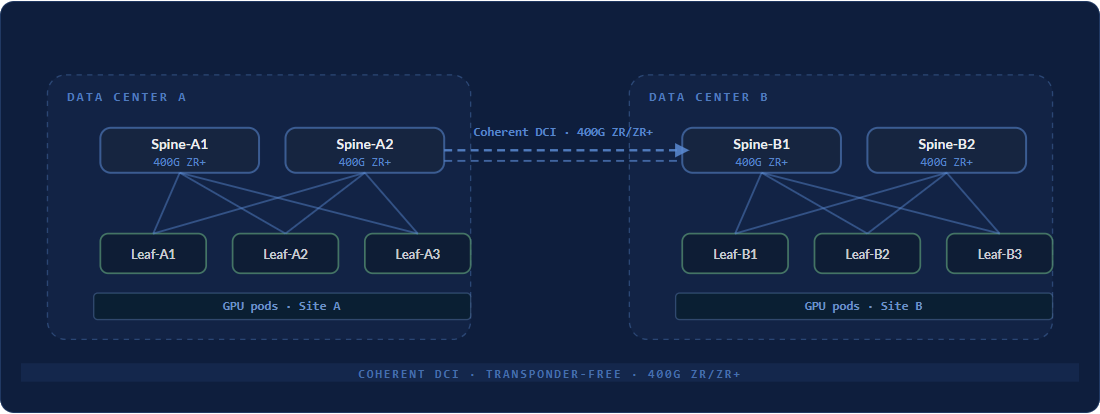
Componentes de OcNOS: Óptica coherente enchufable 400G ZR/ZR+ en un puerto de spine o border-leaf con capacidad DWDM, con telemetría gNMI entre sitios. No se requieren transpondedores externos. Alcance: 400ZR hasta unos 120 km amplificado; OpenZR+ llega más lejos con oFEC.
Reglas prácticas de diseño
Un puñado de reglas mantiene una fabric de IA del lado correcto de la curva de rendimiento y coste, sea cual sea el diseño de referencia del que parta.
- Ajuste la topología a la cantidad de GPU. Pods más pequeños (por debajo del radix de NIC de un solo leaf): rail-only es suficiente. Escala de un solo pod, hasta 4.096 GPU sobre Tomahawk 5: leaf-spine optimizado por rail. Por encima de eso: añada un nivel super-spine al mismo diseño rail-optimized, con el pod sin bloqueo y la relación entre pods ajustada a la carga de trabajo.
- Siempre suscripción 1:1 en el plano de IA. Los racks de almacenamiento y CPU pueden operar con mayores ratios de sobresuscripción. El plano de GPU no debería.
- Planifique el número de rails a partir de xCCL, no de la conveniencia del cableado. 8 rails es el estándar de facto actual para servidores GPU de 8 NIC. No combine rails en menos leaves.
- Elija el silicio por potencia y densidad, no por la marca. TH4 (25,6T) y TH5 (51,2T) son los caballos de batalla; la elección entre ellos depende del consumo del rack y del costo del cable de breakout.
- Valide contra la HCL. Cada referencia aquí está construida sobre hardware listado en el Lista de compatibilidad de hardware de OcNOS; elija a partir de ahí para obtener soporte de primer nivel.
Preguntas frecuentes sobre topología de fabric de IA
¿Qué es una topología rail-optimized y en qué se diferencia de rail-only?
¿Cuándo necesita un fabric de IA un tercer nivel?
¿Debo usar Tomahawk 4 o Tomahawk 5?
¿Necesito InfiniBand, o basta con Ethernet?
¿Dónde termina el escalado vertical y empieza el horizontal?
Profundice. Llévelo consigo.
El datasheet del producto y descargas técnicas y breves que profundizan más que esta página.
Datasheet de OcNOS-DC
Especificación completa de OcNOS-DC: el conjunto de funciones EVPN-VXLAN y Ethernet for AI, los SKU de software, las plataformas de hardware compatibles y la guía de pedido de la solución.
Obtener el datasheetAI Fabric sin pérdidas de 800G con OcNOS
Fabric RoCEv2 sin bloqueo sobre spines Broadcom Tomahawk 4/5: niveles de SKU, plataformas validadas y arquitectura de despliegue.
Obtener el briefFabric DC EVPN-VXLAN
Fabric de centro de datos leaf-spine de nivel operador: IRB simétrico, rutas Type-2/Type-5 y gateway anycast distribuido.
Obtener el briefDatasheet de OcNOS-DC
Formulario rápido. Su PDF se abre en una pestaña nueva inmediatamente después de enviarlo.
✓ Abriendo su PDF en una pestaña nueva…
Si no se ha abierto, utilice el enlace de abajo.
AI Fabric sin pérdidas de 800G con OcNOS
Formulario rápido. Su PDF se abre en una pestaña nueva inmediatamente después de enviarlo.
✓ Abriendo su PDF en una pestaña nueva…
Si no se ha abierto, utilice el enlace de abajo.
Fabric DC EVPN-VXLAN
Formulario rápido. Su PDF se abre en una pestaña nueva inmediatamente después de enviarlo.
✓ Abriendo su PDF en una pestaña nueva…
Si no se ha abierto, utilice el enlace de abajo.
¿Está diseñando su AI fabric? Haremos con usted los cálculos del conteo de puertos.
Díganos la carga de trabajo y la escala de GPU, y un ingeniero de IP Infusion dimensionará los niveles de leaf, spine y super-spine con usted, o empiece con un primer trazado en el AI Fabric Design Suite.
Diseñe toda la fabric de IA con OcNOS
Desde el caso de negocio hasta los cálculos de recuento de puertos, retome donde esté en la construcción.