Topología de red rail-optimized para fabrics de IA
Una red rail-optimized coloca una NIC de cada servidor GPU de 8 NIC en cada uno de 8 rails, y hace de cada rail su propio leaf dedicado, de modo que el AllReduce intra-rail dominante se queda en un leaf y nunca llega al spine. Es una disciplina de cableado y de localidad de tráfico, no un reductor de recuento de spines: el spine se mantiene sin bloqueo 1:1 y transporta solo el resto entre rails. Construido sobre OcNOS-DC sobre RoCEv2 sin pérdidas en Broadcom Tomahawk 5.
Qué significa rail-optimized, y en qué se diferencia de rail-only
Los servidores GPU modernos vienen con 8 NIC. Un rail es una posición de NIC tomada de cada servidor: la NIC-1 de cada servidor forma el rail-1, y así hasta el rail-8. Rail-optimized aterriza cada rail en su propio leaf dedicado, de modo que cada servidor tiene un enlace hacia cada uno de los 8 rail leaves.
La recompensa es la localidad: las bibliotecas xCCL programan el AllReduce dominante dentro de un solo rail, y como ese rail es un leaf, el tráfico nunca sale del leaf. Solo el menor resto entre rails llega al spine. Rail-optimized es una disciplina de cableado y de localidad de tráfico, no una forma de encoger el spine, que se mantiene sin bloqueo 1:1.
- Solo rail mantiene los leaves alineados por rail pero elimina el nivel de spine, de modo que el tráfico entre rails se apoya en el dominio de escalado vertical de GPU dentro del servidor en lugar de una ruta de red. Más barato para un puñado de racks, pero sin ruta de fabric para los flujos entre rails una vez que el clúster supera un dominio de escalado vertical.
- Optimizado por rail añade un spine sin bloqueo 1:1 por encima de los rail leaves, dando a los flujos entre rails una ruta de red real. Es la unidad escalable de pod único estándar; rail-only es el punto de entrada por debajo.
La alineación por rail mantiene local el colectivo caliente
El entrenamiento distribuido está dominado por colectivos como AllReduce para la sincronización de gradientes, ejecutados a través de bibliotecas xCCL (NCCL, RCCL, oneCCL). La alineación por rail coloca las GPU del mismo rango en un leaf compartido, de modo que esos colectivos se completan con el menor recuento de saltos y sin tránsito por el spine para el caso común. Eso contiene la latencia de cola, y la latencia de cola marca el ritmo de un paso síncrono: solo termina cuando la GPU más lenta termina su intercambio.
Localidad colectiva
xCCL programa el AllReduce dominante AllReduce dentro de un rail. Como un rail es un solo leaf, ese tráfico permanece en el leaf y nunca compite por la capacidad del spine.
Menor recuento de saltos
Las GPU del mismo rango comparten un leaf, de modo que los intercambios de sincronización de gradientes se completan en los menos saltos. El spine transporta solo el resto entre rails.
Menor latencia de cola
Un paso síncrono termina cuando termina el intercambio más lento. Mantener el colectivo caliente fuera del spine recorta la cola larga que estanca todo el trabajo.
Uso parejo de rutas
Para el tráfico entre rails que sí llega al spine, Balanceo de carga dinámico reparte los flujos elefante de modo que ningún enlace ascendente se convierte en el punto caliente.
La fabric rail-optimized, trazada
Cada servidor GPU lleva 8 NIC, una por rail, y cada rail es su propio leaf dedicado, de modo que las 8 NIC de un servidor aterrizan en leaves distintos. El AllReduce a través del rail-N se queda dentro del leaf-N y nunca toca el spine; un spine sin bloqueo 1:1 transporta solo el resto entre rails. El diagrama es esquemático: dibuja un recuento reducido de servidores y spines para mantener legible la alineación por rail.
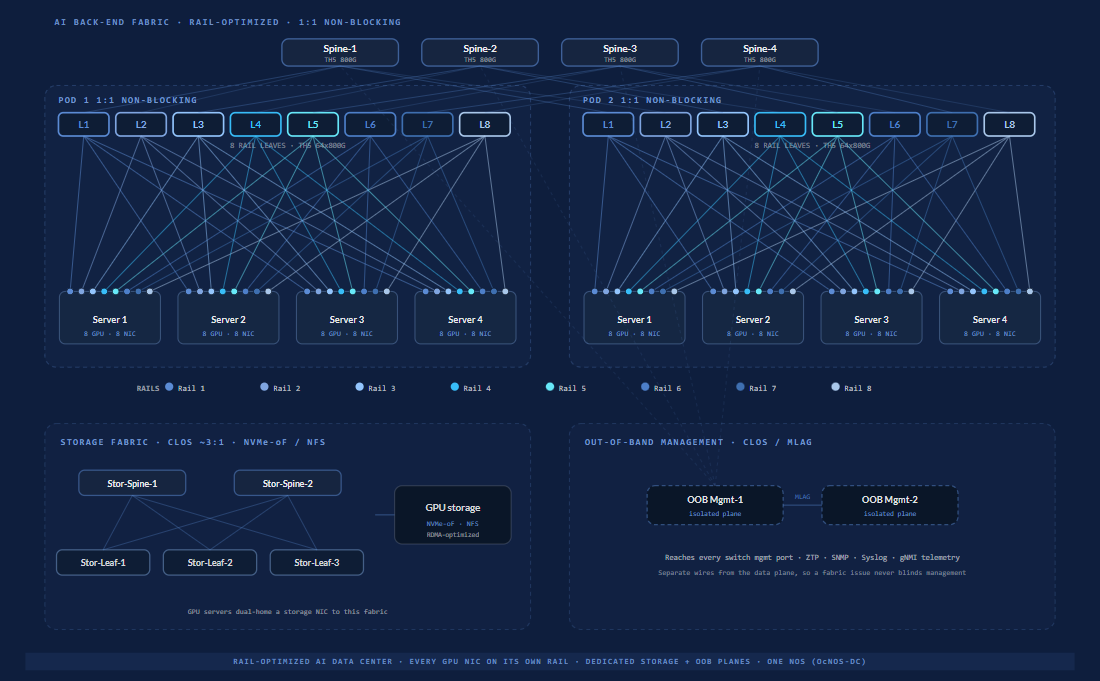
Componentes de OcNOS: Underlay L3 BGP-unnumbered, RoCEv2 sin pérdidas (PFC + ECN) en cada rail leaf, DLB en el nivel de spine, telemetría gNMI/OpenConfig en toda la fabric. Construido sobre hardware Tomahawk 5 listado en la HCL: el Edgecore AIS800-64D y el UfiSpace S9321-64E (64×800G).
Rail-optimized, rail-only y ToR, lado a lado
La elección está en a qué se alinea la fabric. Un trazado por rail alinea cada rango de GPU a un plano de red, de modo que las GPU del mismo rango en todo el clúster comparten un leaf y el colectivo se completa con el menor recuento de saltos. Un trazado ToR se alinea al servidor: cada NIC de un servidor aterriza en su switch de rack, más sencillo de cablear pero forzando a las GPU del mismo rango en racks distintos a subir al spine y volver. Para fabrics de entrenamiento de GPU donde domina AllReduce, la alineación por rail es el estándar; ToR sigue siendo una buena opción para almacenamiento y racks de propósito general donde el tráfico no es síncrono por rango.
| Propiedad | Optimizado por railestándar de pod único | Solo railentrada de clúster pequeño | Top-of-rack (ToR)alineado con el servidor |
|---|---|---|---|
| Alineación | Cada rango de GPU alineado a un plano de red; la NIC-N de cada servidor aterriza en el leaf-N. | La misma alineación por rail: la NIC-N aterriza en el rail leaf-N, pero solo una única fila de leaves. | Red alineada al servidor; cada NIC de un servidor aterriza en su propio switch de rack. |
| Nivel spine | Spine sin bloqueo 1:1 por encima de los rail leaves. | Sin nivel de spine; los rail leaves se sostienen solos. | Spine estándar por encima de los switches de rack. |
| Ruta entre rails | Una ruta de red real a través del spine sin bloqueo. | Se apoya en el dominio de escalado vertical de GPU dentro del servidor; sin ruta de fabric una vez que supera un dominio. | El tráfico síncrono por rango se empuja hacia el spine. |
| Recuento de saltos del colectivo | El menor: los pares del mismo rango comparten un leaf, de modo que el AllReduce intra-rail se queda en un leaf. | También bajo intra-rail, ya que el rail sigue siendo un leaf. | Mayor: los pares del mismo rango en racks distintos se sitúan en switches distintos, de modo que los colectivos cruzan el spine. |
| Mejor opción | La unidad escalable de pod único estándar para fabrics de entrenamiento e inferencia de GPU. | Un puñado de racks bajo un dominio de escalado vertical; el punto de entrada. | Racks de almacenamiento, CPU y de propósito general donde el tráfico no es síncrono por rango. |
Hasta dónde escala una fabric rail-optimized
La escala la determinan el radix del switch y la forma en que cada puerto de 800G se asigna a las GPU. En Broadcom Tomahawk 5 (51.2 Tbps, 64×800G o 128×400G), los diseños van desde un leaf-spine de 2 niveles hasta tres niveles con un super-spine. Como la mayor parte del tráfico colectivo permanece local al rail, el plano super-spine se dimensiona solo según la relación entre pods que realmente necesita. Como contexto, Meta ha descrito públicamente un clúster de entrenamiento de IA basado en Ethernet de 24.576 GPU, lo que muestra fabrics Ethernet operando mucho más allá de un solo pod.
2 niveles, sin bloqueo 1:1
Leaf-spine rail-optimized a 800G por GPU, cada GPU en dos puertos leaf de 400G: 128 leaves, 64 spines. El mayor pod de dos niveles sobre este silicio.
2 niveles a 400G por GPU
El mismo diseño de 2 niveles para GPU con una NIC de 400G cada una.
3 niveles, super-spine
Por encima de 4.096 GPU, añada un nivel super-spine sobre los pods rail-optimized. Cada pod se mantiene 1:1 sin bloqueo; el super-spine fija la relación entre pods.
¿Está dimensionando su propio cluster? La Suite de diseño de fabric de IA dimensiona un pod leaf-spine de dos niveles sin bloqueo e indica cuándo pasa a la escala de tres niveles. Para el panorama completo de topologías, consulte la Topologías de AI fabric referencia.
Cómo construye OcNOS-DC una fabric rail-optimized
OcNOS-DC convierte los switches Tomahawk 5 listados en la HCL en una fabric rail-optimized con un underlay enrutado, un sustrato RoCEv2 sin pérdidas, balanceo de carga dinámico y telemetría de streaming. Es un solo sistema: hardware validado, el sistema operativo de red OcNOS-DC y un solo contrato de soporte con un solo TAC y un solo SLA.
BGP-unnumbered L3
Un underlay enrutado con BGP unnumbered elimina la planificación de direcciones por enlace y reparte el tráfico por cada ruta de rail a spine con ECMP.
RoCEv2 con PFC + ECN
OcNOS-DC aporta el sustrato Ethernet sin pérdidas que RoCEv2 requiere: PFC mantiene la prioridad sin pérdidas y ECN marca la congestión. RoCEv2 en sí es el transporte de la NIC que circula sobre ese sustrato.
Balanceo de carga dinámico
DLB reparte los flujos elefante por la calidad de ruta en tiempo real en lugar de un hash estático, de modo que el tráfico entre rails no se amontona en un enlace ascendente y una fabric bien gestionada puede apuntar a una utilización superior al 90 por ciento en Tomahawk 4/5.
gNMI / OpenConfig
La telemetría se transmite mediante gNMI con modelos OpenConfig, de modo que ajusta el fabric con datos en bucle cerrado durante la puesta en marcha del clúster.
Tomahawk 5 listado en la HCL
Corre sobre switches 64×800G validados: Edgecore AIS800-64D y UfiSpace S9321-64E. Cada leaf y spine aquí está en la Hardware Compatibility List de OcNOS.
Miembro del Ultra Ethernet Consortium
IP Infusion es miembro del Ultra Ethernet Consortium (UEC). UEC 1.0 define un transporte Ethernet multitrayecto que reparte un flujo entre muchas rutas y se ejecuta en NIC compatibles con UEC.
Obtenga el AI Fabric Reference Design
El PDF completo: topología optimizada por rail, número de switches y transceptores, plataformas validadas y un perfil inicial RoCEv2 sin pérdidas sobre OcNOS-DC.
Obtenga el AI Fabric Reference Design
Formulario breve: su PDF se descargará de inmediato tras el envío.
✓ Abriendo su PDF en una pestaña nueva…
Si no se ha abierto, utilice el enlace de abajo.
Preguntas frecuentes sobre red rail-optimized
¿Qué es una red rail-optimized?
¿Cuál es la diferencia entre rail-optimized y rail-only?
Rail frente a ToR: ¿qué trazado debe usar una fabric de IA?
¿A cuántas GPU escala una fabric rail-optimized?
¿Necesita InfiniBand una red rail-optimized?
¿Cómo implementa OcNOS-DC una fabric rail-optimized?
Profundice. Llévelo consigo.
El datasheet del producto y descargas técnicas y breves que profundizan más que esta página.
Datasheet de OcNOS-DC
Especificación completa de OcNOS-DC: el conjunto de funciones EVPN-VXLAN y Ethernet for AI, los SKU de software, las plataformas de hardware compatibles y la guía de pedido de la solución.
Obtener el datasheetAI Fabric sin pérdidas de 800G con OcNOS
Fabric RoCEv2 sin bloqueo sobre spines Broadcom Tomahawk 4/5: niveles de SKU, plataformas validadas y arquitectura de despliegue.
Obtener el briefFabric DC EVPN-VXLAN
Fabric de centro de datos leaf-spine de nivel operador: IRB simétrico, rutas Type-2/Type-5 y gateway anycast distribuido.
Obtener el briefDatasheet de OcNOS-DC
Formulario rápido. Su PDF se abre en una pestaña nueva inmediatamente después de enviarlo.
✓ Abriendo su PDF en una pestaña nueva…
Si no se ha abierto, utilice el enlace de abajo.
AI Fabric sin pérdidas de 800G con OcNOS
Formulario rápido. Su PDF se abre en una pestaña nueva inmediatamente después de enviarlo.
✓ Abriendo su PDF en una pestaña nueva…
Si no se ha abierto, utilice el enlace de abajo.
Fabric DC EVPN-VXLAN
Formulario rápido. Su PDF se abre en una pestaña nueva inmediatamente después de enviarlo.
✓ Abriendo su PDF en una pestaña nueva…
Si no se ha abierto, utilice el enlace de abajo.
¿Planificando una fabric de GPU rail-optimized? Haremos los cálculos de recuento de puertos con usted.
Díganos la escala de GPU y el recuento de rails, y un ingeniero de IP Infusion dimensionará el pod leaf-spine con usted, o empiece con un primer trazado en el AI Fabric Design Suite.
Diseñe toda la fabric de IA con OcNOS
Desde el caso de negocio hasta los cálculos de recuento de puertos, retome donde esté en la construcción.