AI Fabric 向けレール最適化ネットワークトポロジ
レール最適化ネットワークは、8 基の NIC を備えた各 GPU サーバーから 1 基の NIC を 8 本のレールそれぞれに割り当て、すべてのレールをそれ専用の leaf とします。これにより、支配的なレール内 AllReduce は 1 つの leaf 上にとどまり、spine には一切到達しません。 これは配線とトラフィックローカリティの規律であり、spine 数を削減する手法ではありません。spine は 1:1 ノンブロッキングを維持し、レール間の残余トラフィックのみを運びます。Broadcom Tomahawk 5 上の無損失 RoCEv2 を介した OcNOS-DC 上に構築されます。
レール最適化の意味と、rail-only との違い
最新の GPU サーバーは 8 基の NIC を搭載します。レールとは、すべてのサーバーから取り出した 1 つの NIC 位置です。すべてのサーバーの NIC-1 が rail-1 を構成し、以降 rail-8 まで同様です。レール最適化は各レールをそれ専用の leaf に接続するため、すべてのサーバーは 8 本のレール leaf それぞれに 1 本のリンクを持ちます。
その効果はローカリティにあります。xCCL ライブラリは支配的な AllReduce を単一のレール内でスケジュールし、そのレールは 1 つの leaf であるため、トラフィックは leaf から出ることがありません。より小さなレール間の残余のみが spine に到達します。レール最適化は配線とトラフィックローカリティの規律であり、spine を縮小する手法ではなく、spine は 1:1 ノンブロッキングを維持します。
- Rail-only はレール整合された leaf を維持しつつ spine 階層を省くため、レール間トラフィックはネットワークパスではなくサーバー内 GPU スケールアップドメインに依存します。少数のラックにはより安価ですが、クラスターが 1 つのスケールアップドメインを超えて成長すると、レール間フロー向けのファブリック経路がなくなります。
- Rail-optimized はレール leaf の上に 1:1 ノンブロッキング spine を追加し、レール間フローに実際のネットワークパスを与えます。これは標準的な単一ポッドのスケーラブルユニットであり、rail-only はその下位のエントリーポイントです。
レール整合がホットな集合通信をローカルに保つ
分散トレーニングは、勾配同期のための AllReduce のような集合通信が支配的であり、これらは xCCL ライブラリ(NCCL、RCCL、oneCCL)を介して実行されます。レール整合は同一ランクの GPU を共有 leaf 上に配置するため、こうした集合通信は最小のホップ数で完了し、一般的なケースでは spine を経由しません。これによりテールレイテンシが抑えられ、テールレイテンシは同期ステップのペースを決定します。すなわち、ステップは最も遅い GPU がその交換を終えたときにのみ完了します。
集合通信のローカリティ
xCCL は支配的な AllReduce を 1 つのレール内でスケジュール. Because a rail is one leaf, that traffic stays on the leaf and never contends for spine capacity.
最小のホップ数
同一ランクの GPU は leaf を共有するため、勾配同期の交換は最小のホップ数で完了します。spine はレール間の残余のみを運びます。
テールレイテンシの低減
同期ステップは最も遅い交換が終わったときに終了します。ホットな集合通信を spine から外すことで、処理全体を停滞させるロングテールを削減します。
均等なパス利用
spine に到達するレール間トラフィックについては、 ダイナミックロードバランシング エレファントフローを分散させ、単一のアップリンクがホットスポットにならないようにします。
レール最適化ファブリックのレイアウト
各 GPU サーバーはレールごとに 1 基、計 8 基の NIC を搭載し、各レールはそれ専用の leaf であるため、サーバー上の 8 基すべての NIC は異なる leaf に着地します。rail-N をまたぐ AllReduce は leaf-N 内にとどまり、spine には一切触れません。1:1 ノンブロッキング spine はレール間の残余のみを運びます。この図は模式的なものであり、レール整合を読みやすく保つためにサーバー数と spine 数を減らして描いています。
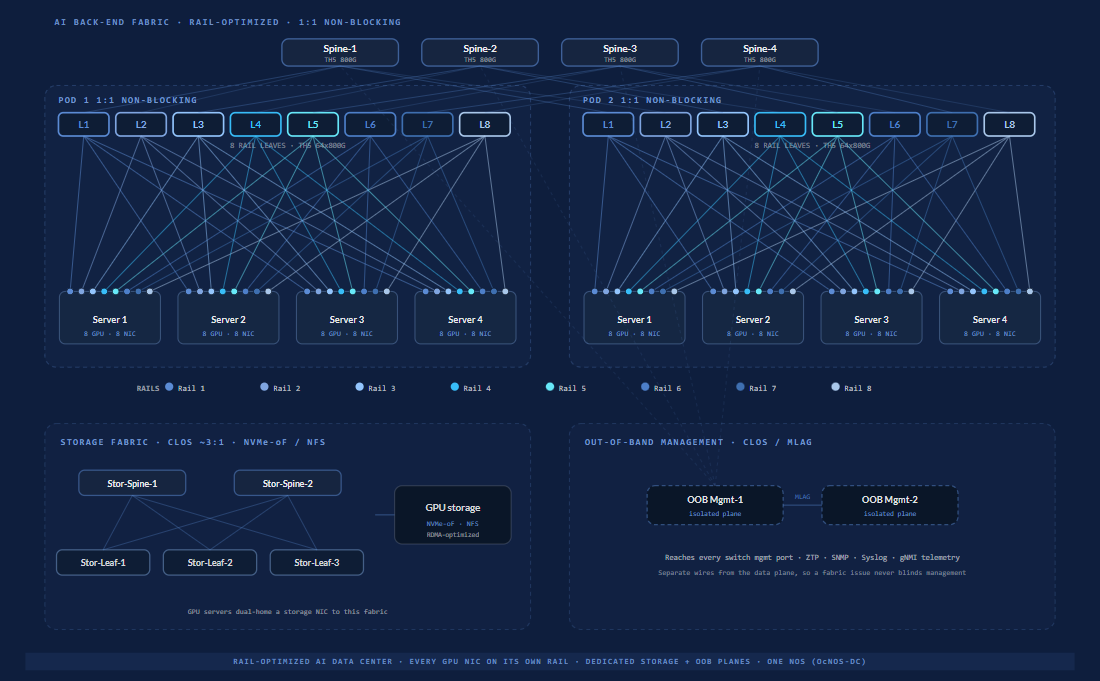
OcNOS構成要素: BGP-unnumbered の L3 アンダーレイ、すべてのレール leaf 上の RoCEv2 無損失(PFC + ECN)、spine 階層での DLB、全体にわたる gNMI/OpenConfig テレメトリ。HCL 掲載の Tomahawk 5 ハードウェアである Edgecore AIS800-64D および UfiSpace S9321-64E(64×800G)上に構築されます。
レール最適化・rail-only・ToR の比較
選択のポイントは、ファブリックが何に整合するかにあります。レールレイアウトは各 GPU ランクをネットワークプレーンに整合させるため、クラスター全体の同一ランク GPU が leaf を共有し、集合通信は最小のホップ数で完了します。ToR レイアウトはサーバーに整合します。1 台のサーバー内のすべての NIC がそのラックスイッチに着地するため、配線は簡素ですが、異なるラックにある同一ランクの GPU は spine を往復させられます。AllReduce が支配的な GPU トレーニングファブリックでは、レール整合が標準です。ToR は、トラフィックがランク同期的でないストレージや汎用ラックには依然として優れた選択肢です。
| Property | Rail-optimized単一ポッドの標準 | Rail-only小規模クラスターのエントリー | Top-of-rack(ToR)server-aligned |
|---|---|---|---|
| Alignment | 各 GPU ランクをネットワークプレーンに整合。すべてのサーバーの NIC-N が leaf-N に接続。 | 同じレール整合。NIC-N はレール leaf-N に接続するが、leaf は 1 列のみ。 | ネットワークをサーバーに整合。サーバー内のすべての NIC がそれ専用のラックスイッチに接続。 |
| Spine tier | レール leaf の上に 1:1 ノンブロッキング spine。 | spine 階層なし。レール leaf は単独で構成。 | ラックスイッチの上に標準的な spine。 |
| レール間パス | ノンブロッキング spine を通る実際のネットワークパス。 | サーバー内 GPU スケールアップドメインに依存。1 つのドメインを超えて成長するとファブリック経路なし。 | ランク同期トラフィックは spine へ押し上げられる。 |
| 集合通信のホップ数 | 最小。同一ランクのピアが leaf を共有するため、レール内 AllReduce は 1 つの leaf 上にとどまる。 | レールは依然として 1 つの leaf であるため、レール内も同様に低い。 | より高い。異なるラックにある同一ランクのピアは異なるスイッチに配置されるため、集合通信は spine を横断する。 |
| 最適な選択 | GPU トレーニングおよび推論ファブリック向けの標準的な単一ポッドスケーラブルユニット。 | 1 つのスケールアップドメイン以下の少数のラック。エントリーポイント。 | トラフィックがランク同期的でないストレージ・CPU・汎用ラック。 |
レール最適化ファブリックのスケール範囲
スケールはスイッチの radix と、各 800G ポートが GPU にどうマッピングされるかによって決まります。radix-64 の Broadcom Tomahawk 5(51.2 Tbps、64×800G)では、設計は 2 階層の leaf-spine から 3 ステージ Clos までに及びます。集合通信トラフィックの大半はレールローカルにとどまるため、super-spine プレーンは実際に必要なポッド間比率にのみ合わせてサイジングされます。参考として、Meta は 24,000 GPU の Ethernet ベース AI トレーニングクラスターを公表しており、これは Ethernet ファブリックが単一ポッドをはるかに超えて動作することを示しています。
2 階層、1:1 ノンブロッキング
GPU あたり 1 つの 800G ファブリックポートによるレール最適化 leaf-spine。標準的な単一ポッドスケーラブルユニット。
800G ブレイクアウトを用いた 2 階層
800G ポートを複数の GPU NIC にブレイクアウトし、スイッチあたりの GPU 密度を高めた同じ 2 階層設計。
3ステージClos
レール最適化ポッドの上に super-spine 階層を追加します。各ポッドは 1:1 ノンブロッキングを維持し、super-spine がポッド間比率を決定します。
fat-tree の限界
この radix における 3 ステージ fat-tree の理論上限。ポッド間比率はワークロードに合わせて調整されます。
ご自身のクラスタをサイジングしますか。 The AI Fabric Design Suite は GPU あたり 1 つのファブリック NIC でノンブロッキングの 2 階層 leaf-spine ポッドをサイジングし、3 階層規模へと移行する際にはそれを示します。トポロジの全体像については、次をご覧ください。 AIファブリックトポロジー reference.
OcNOS-DC がレール最適化ファブリックを構築する方法
OcNOS-DC は、HCL 掲載の Tomahawk 5 スイッチを、ルーテッドアンダーレイ・無損失 RoCEv2 基盤・適応型ロードバランシング・ストリーミングテレメトリを備えたレール最適化ファブリックへと変えます。これは 1 つのシステムです。検証済みハードウェア、OcNOS-DC ネットワークオペレーティングシステム、そして 1 つの TAC と 1 つの SLA による単一のサポート契約です。
BGP-unnumbered L3
BGP unnumbered によるルーテッドアンダーレイは、リンクごとのアドレス設計を不要にし、ECMP によってすべてのレール to spine パスにトラフィックを分散させます。
PFC + ECN を用いた RoCEv2
OcNOS-DC は RoCEv2 が必要とする無損失 Ethernet 基盤を提供します。PFC がプライオリティを無損失に保ち、ECN が輻輳をマークします。RoCEv2 自体は、その基盤上で動作する NIC トランスポートです。
ダイナミックロードバランシング
DLB は静的ハッシュではなくリアルタイムのパス品質によってエレファントフローを分散させるため、レール間トラフィックが 1 つのアップリンクに集中せず、適切に運用されたファブリックは Tomahawk 4/5 で 90 percent を超える利用率を目標にできます。
gNMI/OpenConfig
パスごとの利用率とキュー深度のカウンターは OpenConfig モデルによって gNMI 経由でストリーミングされるため、クラスター立ち上げ時にクローズドループデータでファブリックをチューニングできます。
HCL 掲載の Tomahawk 5
検証済みの 64×800G スイッチである Edgecore AIS800-64D および UfiSpace S9321-64E 上で動作します。ここでのすべての leaf と spine は OcNOS ハードウェア互換性リストに掲載されています。
Ultra Ethernet 対応
IP Infusion は Ultra Ethernet Consortium の貢献メンバーであり、OcNOS-DC は UEC 1.0 ファブリックプロファイルに追従しているため、UEC 対応 NIC の出荷に合わせてファブリックはそのまま発展します。プロファイルへの整合は認証の主張ではありません。
AIファブリックリファレンスデザインを入手
The full PDF: rail-optimized topology, switch and transceiver counts, validated platforms, and a RoCEv2 lossless starting profile on OcNOS-DC.
AIファブリックリファレンスデザインを入手
簡単なフォームです:送信後すぐに PDF がダウンロードされます。
✓ PDF を新しいタブで開いています…
開かない場合は、下記のリンクをご利用ください。
レール最適化ネットワーク FAQ
レール最適化ネットワークとは何ですか。
レール最適化と rail-only の違いは何ですか。
レール対 ToR。AI ファブリックはどちらのレイアウトを用いるべきですか。
レール最適化ファブリックは何基の GPU までスケールしますか。
レール最適化ネットワークに InfiniBand は必要ですか。
OcNOS-DC はレール最適化ファブリックをどのように実装しますか。
さらに詳しく。資料をお持ち帰りください。
製品データシートと、このページよりもさらに踏み込んだ簡潔で技術的なダウンロード資料です。
OcNOS-DC データシート
OcNOS-DC の完全な仕様。EVPN-VXLAN と Ethernet for AI の機能セット、ソフトウェア SKU、サポート対象ハードウェアプラットフォーム、ソリューション発注ガイドを収録しています。
データシートを入手OcNOS 800G ロスレス AI Fabric
Broadcom Tomahawk 4/5 スパインによるノンブロッキング RoCEv2 ファブリック。SKU 階層・検証済みプラットフォーム・導入アーキテクチャを解説します。
概要資料を入手EVPN-VXLAN データセンターファブリック
キャリアグレードの leaf-spine データセンターファブリック。対称型 IRB、Type-2/Type-5 ルート、そして分散エニーキャストゲートウェイ。
概要資料を入手OcNOS-DC データシート
簡単なフォームです。送信後すぐに PDF が新しいタブで開きます。
✓ PDF を新しいタブで開いています…
開かない場合は、下記のリンクをご利用ください。
OcNOS 800G ロスレス AI Fabric
簡単なフォームです。送信後すぐに PDF が新しいタブで開きます。
✓ PDF を新しいタブで開いています…
開かない場合は、下記のリンクをご利用ください。
EVPN-VXLAN データセンターファブリック
簡単なフォームです。送信後すぐに PDF が新しいタブで開きます。
✓ PDF を新しいタブで開いています…
開かない場合は、下記のリンクをご利用ください。
レール最適化 GPU ファブリックを計画中ですか。ポート数の計算を一緒に行います。
GPU 規模とレール数をお知らせいただければ、IP Infusion のエンジニアが leaf-spine ポッドのサイジングを一緒に行います。あるいは AI Fabric Design Suite でレイアウトの初回案から始めることも可能です。
OcNOS で AI ファブリック全体を設計
ビジネスケースからポート数の計算まで、構築のどの段階からでも着手できます。