AI 패브릭을 위한 Rail-optimized 네트워크 토폴로지
Rail-optimized 네트워크는 8-NIC GPU 서버의 각 NIC 하나를 8개의 rail에 각각 배치하고, 각 rail을 자체 전용 leaf로 만들어, 지배적인 rail 내부 AllReduce가 하나의 leaf에 머물며 spine에 도달하지 않도록 합니다. 이는 spine 수를 줄이는 방법이 아니라 배선 및 트래픽 지역성 규율입니다. spine은 1:1 논블로킹을 유지하며 rail 간 나머지만 전달합니다. Broadcom Tomahawk 5의 무손실 RoCEv2 위에서 OcNOS-DC로 구축됩니다.
rail-optimized의 의미와 rail-only와의 차이
최신 GPU 서버에는 8개의 NIC이 탑재됩니다. rail은 모든 서버에서 가져온 하나의 NIC 위치입니다. 모든 서버의 NIC-1이 rail-1을 형성하며, rail-8까지 이어집니다. Rail-optimized는 각 rail을 자체 전용 leaf에 홈으로 두므로, 모든 서버가 8개의 rail leaf 각각에 하나의 링크를 갖습니다.
그 이점은 지역성입니다. xCCL 라이브러리는 지배적인 AllReduce를 단일 rail 내부에서 스케줄링하며, 그 rail이 하나의 leaf이기 때문에 트래픽이 leaf를 벗어나지 않습니다. 더 작은 rail 간 나머지만 spine에 도달합니다. Rail-optimized는 spine을 축소하는 방법이 아니라 배선 및 트래픽 지역성 규율이며, spine은 1:1 논블로킹을 유지합니다.
- 레일 전용 는 rail 정렬 leaf는 유지하되 spine 계층을 없애므로, rail 간 트래픽이 네트워크 경로가 아니라 서버 내 GPU scale-up 도메인에 의존합니다. 소수의 랙에는 더 저렴하지만, 클러스터가 하나의 scale-up 도메인을 넘어서면 rail 간 플로우를 위한 패브릭 경로가 없습니다.
- 레일 최적화 는 rail leaf 위에 1:1 논블로킹 spine을 추가하여 rail 간 플로우에 실제 네트워크 경로를 제공합니다. 이는 표준 단일 파드 확장 단위이며, rail-only는 그 아래의 진입점입니다.
Rail 정렬은 핵심 collective를 로컬에 유지합니다
분산 학습은 gradient 동기화를 위한 AllReduce와 같은 collective가 지배하며, 이는 xCCL 라이브러리(NCCL, RCCL, oneCCL)를 통해 실행됩니다. Rail 정렬은 동일 rank의 GPU를 공유 leaf에 배치하므로, 이러한 collective가 일반적인 경우에 가장 적은 홉 수로, spine을 거치지 않고 완료됩니다. 이는 테일 레이턴시를 낮게 유지하며, 테일 레이턴시가 동기식 스텝의 속도를 결정합니다. 스텝은 가장 느린 GPU가 교환을 마쳐야만 완료됩니다.
Collective 지역성
xCCL은 지배적인 다음을 스케줄링합니다 하나의 rail 내부의 AllReduce. 레일은 하나의 리프이므로 해당 트래픽은 리프 안에 머물며 스파인 용량을 두고 경합하지 않습니다.
가장 적은 홉 수
동일 rank의 GPU가 leaf를 공유하므로, gradient 동기화 교환이 가장 적은 홉으로 완료됩니다. spine은 rail 간 나머지만 전달합니다.
더 낮은 테일 레이턴시
동기식 스텝은 가장 느린 교환이 끝날 때 종료됩니다. 핵심 collective를 spine에서 배제하면 전체 작업을 정체시키는 긴 테일이 줄어듭니다.
고른 경로 사용
spine에 도달하는 rail 간 트래픽에 대해서는, 동적 로드 밸런싱 엘리펀트 플로우를 분산하여 어떤 단일 업링크도 핫스팟이 되지 않도록 합니다.
Rail-optimized 패브릭의 구성
각 GPU 서버는 rail당 하나씩 8개의 NIC을 탑재하며, 각 rail은 자체 전용 leaf이므로 서버의 8개 NIC이 모두 서로 다른 leaf에 연결됩니다. rail-N에 걸친 AllReduce는 leaf-N 내부에 머물며 spine을 전혀 거치지 않습니다. 1:1 논블로킹 spine은 rail 간 나머지만 전달합니다. 이 다이어그램은 개념도로, rail 정렬을 읽기 쉽게 유지하기 위해 서버와 spine 수를 축소하여 그렸습니다.
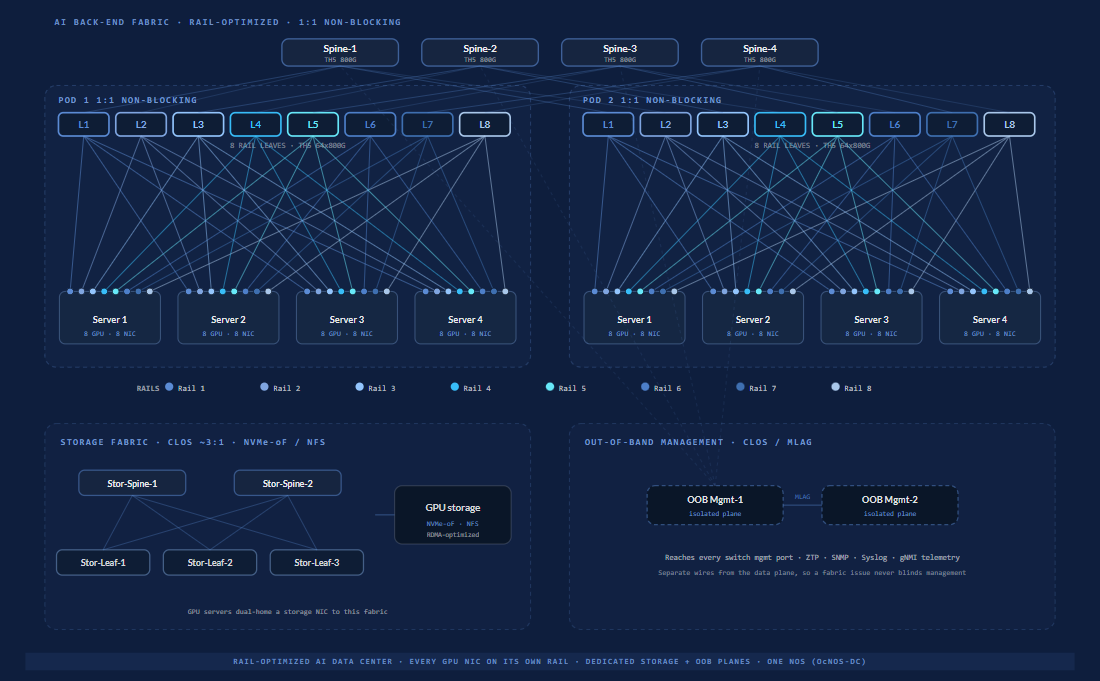
OcNOS 구성 요소: BGP-unnumbered L3 언더레이, 모든 rail leaf에서 RoCEv2 무손실(PFC + ECN), spine 계층에서 DLB, 전반에 걸친 gNMI/OpenConfig 텔레메트리. HCL 등재 Tomahawk 5 하드웨어 기반 구축: Edgecore AIS800-64D 및 UfiSpace S9321-64E(64×800G).
Rail-optimized, rail-only, ToR, 나란히 비교
선택은 패브릭이 무엇에 정렬되는가에 관한 것입니다. rail 레이아웃은 각 GPU rank를 네트워크 플레인에 정렬하므로, 클러스터 전반의 동일 rank GPU가 leaf를 공유하고 collective가 가장 적은 홉 수로 완료됩니다. ToR 레이아웃은 서버에 정렬됩니다. 한 서버의 모든 NIC이 랙 스위치에 연결되어 케이블링은 더 간단하지만, 서로 다른 랙의 동일 rank GPU를 spine으로 올렸다가 다시 내려오게 만듭니다. AllReduce가 지배하는 GPU 학습 패브릭에서는 rail 정렬이 표준이며, ToR은 트래픽이 rank 동기식이 아닌 스토리지 및 범용 랙에 여전히 좋은 선택입니다.
| 특성 | 레일 최적화단일 파드 표준 | 레일 전용소규모 클러스터 진입점 | 톱오브랙 (ToR)서버 기준 정렬 |
|---|---|---|---|
| 정렬 기준 | 각 GPU rank가 네트워크 플레인에 정렬되며, 모든 서버의 NIC-N이 leaf-N에 홈으로 연결됩니다. | 동일한 rail 정렬: NIC-N이 rail leaf-N에 홈으로 연결되지만, leaf가 단일 행뿐입니다. | 네트워크가 서버에 정렬되며, 서버의 모든 NIC이 자체 랙 스위치에 홈으로 연결됩니다. |
| 스파인 계층 | rail leaf 위의 1:1 논블로킹 spine. | spine 계층 없음. rail leaf가 독립적으로 존재합니다. | 랙 스위치 위의 표준 spine. |
| rail 간 경로 | 논블로킹 spine을 통한 실제 네트워크 경로. | 서버 내 GPU scale-up 도메인에 의존하며, 하나의 도메인을 넘어서면 패브릭 경로가 없습니다. | rank 동기식 트래픽이 spine으로 밀려 올라갑니다. |
| Collective 홉 수 | 가장 적음: 동일 rank 피어가 leaf를 공유하므로 rail 내부 AllReduce가 하나의 leaf에 머뭅니다. | rail이 여전히 하나의 leaf이므로 rail 내부도 낮음. | 더 높음: 서로 다른 랙의 동일 rank 피어가 서로 다른 스위치에 위치하므로 collective가 spine을 가로지릅니다. |
| 가장 적합한 선택 | GPU 학습 및 추론 패브릭을 위한 표준 단일 파드 확장 단위. | 하나의 scale-up 도메인 아래의 소수 랙. 진입점입니다. | 트래픽이 rank 동기식이 아닌 스토리지, CPU, 범용 랙. |
Rail-optimized 패브릭이 확장되는 범위
규모는 스위치 radix와 각 800G 포트가 GPU에 어떻게 매핑되는지에 따라 결정됩니다. radix-64 Broadcom Tomahawk 5(51.2 Tbps, 64×800G)에서, 이 설계는 2계층 leaf-spine에서 3단계 Clos까지 실행됩니다. 대부분의 collective 트래픽이 rail 로컬에 머물기 때문에, super-spine 플레인은 실제로 필요한 파드 간 비율에만 맞춰 사이징됩니다. 참고로, Meta는 24,000-GPU 이더넷 기반 AI 학습 클러스터를 공개적으로 설명했으며, 이는 이더넷 패브릭이 단일 파드를 훨씬 넘어 운영됨을 보여줍니다.
2계층, 1:1 논블로킹
GPU당 하나의 800G 패브릭 포트를 갖춘 Rail-optimized leaf-spine. 표준 단일 파드 확장 단위.
800G 분할을 갖춘 2계층
스위치당 더 높은 GPU 밀도를 위해 800G 포트를 여러 GPU NIC으로 분할한 동일한 2계층 설계.
3단 Clos
Rail-optimized 파드 위에 super-spine 계층을 추가합니다. 각 파드는 1:1 논블로킹을 유지하며, super-spine이 파드 간 비율을 설정합니다.
Fat-tree 한계
이 radix에서 3단계 fat-tree의 이론적 상한. 파드 간 비율은 워크로드에 맞춰 조정됩니다.
직접 클러스터를 사이징하고 계십니까? AI 패브릭 설계 스위트 GPU당 하나의 패브릭 NIC 기준으로 논블로킹 2계층 leaf-spine 파드를 사이징하고, 3계층 규모로 넘어가는 시점을 표시합니다. 전체 토폴로지 개요는 다음을 참조하십시오 AI fabric 토폴로지 레퍼런스.
OcNOS-DC가 Rail-optimized 패브릭을 구축하는 방식
OcNOS-DC는 HCL 등재 Tomahawk 5 스위치를, 라우팅 언더레이, 무손실 RoCEv2 기반, 적응형 로드 밸런싱, 스트리밍 텔레메트리를 갖춘 rail-optimized 패브릭으로 전환합니다. 이는 하나의 시스템입니다. 검증된 하드웨어, OcNOS-DC 네트워크 운영체제, 그리고 하나의 TAC와 하나의 SLA를 갖춘 단일 지원 계약입니다.
BGP-unnumbered L3
BGP unnumbered를 갖춘 라우팅 언더레이는 링크별 주소 계획을 없애고 ECMP로 모든 rail 대 spine 경로에 트래픽을 분산합니다.
PFC + ECN을 갖춘 RoCEv2
OcNOS-DC는 RoCEv2가 요구하는 무손실 이더넷 기반을 제공합니다. PFC는 우선순위를 무손실로 유지하고 ECN은 혼잡을 마킹합니다. RoCEv2 자체는 그 기반 위에서 동작하는 NIC 트랜스포트입니다.
동적 로드 밸런싱
DLB는 정적 해시가 아니라 실시간 경로 품질로 엘리펀트 플로우를 분산하므로, rail 간 트래픽이 하나의 업링크에 쌓이지 않고 잘 운영되는 패브릭이 Tomahawk 4/5에서 90퍼센트 이상의 활용률을 목표로 할 수 있습니다.
gNMI / OpenConfig
경로별 활용률 및 큐 깊이 카운터가 OpenConfig 모델과 함께 gNMI를 통해 스트리밍되므로, 클러스터 브링업 중 폐루프 데이터로 패브릭을 튜닝할 수 있습니다.
HCL 등재 Tomahawk 5
검증된 64×800G 스위치에서 실행됩니다: Edgecore AIS800-64D 및 UfiSpace S9321-64E. 여기의 모든 leaf와 spine은 OcNOS Hardware Compatibility List에 등재되어 있습니다.
Ultra Ethernet Consortium 회원사
IP Infusion은 Ultra Ethernet Consortium(UEC) 회원사입니다. UEC 1.0은 하나의 플로우를 여러 경로로 분산하는 멀티패스 이더넷 전송을 정의하며, UEC 지원 NIC에서 실행됩니다.
AI Fabric 레퍼런스 디자인 받기
PDF 전문: 레일 최적화 토폴로지, 스위치 및 트랜시버 수량, 검증된 플랫폼, OcNOS-DC 기반 RoCEv2 무손실 시작 프로파일.
AI Fabric 레퍼런스 디자인 받기
간단한 양식입니다: 제출 직후 PDF가 자동으로 다운로드됩니다.
✓ 새 탭에서 PDF를 여는 중입니다…
열리지 않았다면 아래 링크를 이용해 주십시오.
Rail-optimized 네트워크 FAQ
Rail-optimized 네트워크란 무엇입니까?
Rail-optimized와 rail-only의 차이는 무엇입니까?
Rail vs ToR: AI 패브릭은 어떤 레이아웃을 사용해야 합니까?
Rail-optimized 패브릭은 몇 개의 GPU까지 확장됩니까?
Rail-optimized 네트워크에 InfiniBand가 필요합니까?
OcNOS-DC는 Rail-optimized 패브릭을 어떻게 구현합니까?
더 깊이 살펴보십시오. 자료를 소장하십시오.
제품 데이터시트와 이 페이지보다 한층 더 깊이 있는 간결한 기술 다운로드 자료입니다.
OcNOS-DC 데이터시트
OcNOS-DC 전체 사양: EVPN-VXLAN 및 Ethernet for AI 기능 세트, 소프트웨어 SKU, 지원 하드웨어 플랫폼, 솔루션 주문 가이드.
Datasheet 받기OcNOS 800G 무손실 AI Fabric
Broadcom Tomahawk 4/5 스파인 기반의 논블로킹 RoCEv2 fabric: SKU 등급, 검증된 플랫폼, 도입 아키텍처를 다룹니다.
브리프 받기EVPN-VXLAN 데이터센터 패브릭
통신사업자급 leaf-spine 데이터센터 패브릭: 대칭 IRB, Type-2/Type-5 경로, 그리고 분산 애니캐스트 게이트웨이.
브리프 받기OcNOS-DC 데이터시트
간단한 양식입니다. 제출하면 PDF가 즉시 새 탭에서 열립니다.
✓ 새 탭에서 PDF를 여는 중입니다…
열리지 않았다면 아래 링크를 이용해 주십시오.
OcNOS 800G 무손실 AI Fabric
간단한 양식입니다. 제출하면 PDF가 즉시 새 탭에서 열립니다.
✓ 새 탭에서 PDF를 여는 중입니다…
열리지 않았다면 아래 링크를 이용해 주십시오.
EVPN-VXLAN 데이터센터 패브릭
간단한 양식입니다. 제출하면 PDF가 즉시 새 탭에서 열립니다.
✓ 새 탭에서 PDF를 여는 중입니다…
열리지 않았다면 아래 링크를 이용해 주십시오.
Rail-optimized GPU 패브릭을 계획 중이신가요? 포트 수 계산을 함께 진행해 드립니다.
GPU 규모와 rail 수를 알려주시면 IP Infusion 엔지니어가 함께 leaf-spine 파드를 사이징해 드리며, AI Fabric Design Suite에서 1차 레이아웃으로 시작하실 수도 있습니다.
OcNOS로 전체 AI 패브릭을 설계하십시오
비즈니스 사례부터 포트 수 계산까지, 구축 과정의 어느 단계에서든 이어서 진행하십시오.