Topologie réseau rail-optimized pour les fabrics IA
Un réseau rail-optimized place une carte réseau de chaque serveur GPU à 8 cartes sur chacun des 8 rails, et fait de chaque rail son propre leaf dédié, si bien que l'AllReduce intra-rail dominant reste sur un seul leaf et n'atteint jamais le spine. C'est une discipline de câblage et de localité de trafic, pas un réducteur du nombre de spines : le spine reste 1:1 non bloquant et ne transporte que le reliquat inter-rail. Bâti sur OcNOS-DC au-dessus de RoCEv2 sans perte sur Broadcom Tomahawk 5.
Ce que signifie rail-optimized, et en quoi il diffère de rail-only
Les serveurs GPU modernes sont livrés avec 8 cartes réseau. Un rail est une position de carte réseau prise sur chaque serveur : la NIC-1 de chaque serveur forme le rail-1, et ainsi de suite jusqu'au rail-8. Le rail-optimized rattache chaque rail à son propre leaf dédié, si bien que chaque serveur dispose d'un lien vers chacun des 8 leaves de rail.
Le bénéfice est la localité : les bibliothèques xCCL ordonnancent l'AllReduce dominant à l'intérieur d'un seul rail, et parce que ce rail est un seul leaf, le trafic ne quitte jamais le leaf. Seul le reliquat inter-rail, plus réduit, atteint le spine. Le rail-optimized est une discipline de câblage et de localité de trafic, pas un moyen de réduire le spine, qui reste 1:1 non bloquant.
- Rail uniquement conserve les leaves alignés sur les rails mais supprime le niveau spine, si bien que le trafic inter-rail s'appuie sur le domaine de scale-up GPU interne au serveur plutôt que sur un chemin réseau. Moins cher pour une poignée de racks, mais sans route de fabric pour les flux inter-rail dès que le cluster dépasse un domaine de scale-up.
- Optimisé par rail ajoute un spine 1:1 non bloquant au-dessus des leaves de rail, offrant aux flux inter-rail un vrai chemin réseau. C'est l'unité évolutive standard à un seul pod ; rail-only est le point d'entrée en dessous.
L'alignement sur les rails garde le collectif chaud en local
L'entraînement distribué est dominé par des collectifs tels que l'AllReduce pour la synchronisation des gradients, exécutés au travers des bibliothèques xCCL (NCCL, RCCL, oneCCL). L'alignement sur les rails place les GPU de même rang sur un leaf partagé, si bien que ces collectifs s'achèvent avec le plus faible nombre de sauts et sans transit par le spine dans le cas courant. Cela contient la latence de queue, et la latence de queue fixe le rythme d'une étape synchrone : elle ne s'achève que lorsque le GPU le plus lent termine son échange.
Localité collective
xCCL ordonnance l'AllReduce dominant à l'intérieur d'un seul rail. Comme un rail correspond à une seule leaf, ce trafic reste sur la leaf et n'entre jamais en concurrence pour la capacité du spine.
Plus faible nombre de sauts
Les GPU de même rang partagent un leaf, si bien que les échanges de synchronisation de gradient s'achèvent en un minimum de sauts. Le spine ne transporte que le reliquat inter-rail.
Latence de queue réduite
Une étape synchrone se termine lorsque l'échange le plus lent se termine. Tenir le collectif chaud à l'écart du spine réduit la longue traîne qui bloque toute la tâche.
Utilisation uniforme des chemins
Pour le trafic inter-rail qui atteint effectivement le spine, Équilibrage de charge dynamique répartit les flux éléphants afin qu'aucune liaison montante ne devienne le point chaud.
Le fabric rail-optimized, en schéma
Chaque serveur GPU porte 8 cartes réseau, une par rail, et chaque rail est son propre leaf dédié, si bien que les 8 cartes d'un serveur aboutissent sur des leaves différents. L'AllReduce sur le rail-N reste à l'intérieur du leaf-N et ne touche jamais le spine ; un spine 1:1 non bloquant ne transporte que le reliquat inter-rail. Le schéma est schématique : il représente un nombre réduit de serveurs et de spines pour garder l'alignement sur les rails lisible.
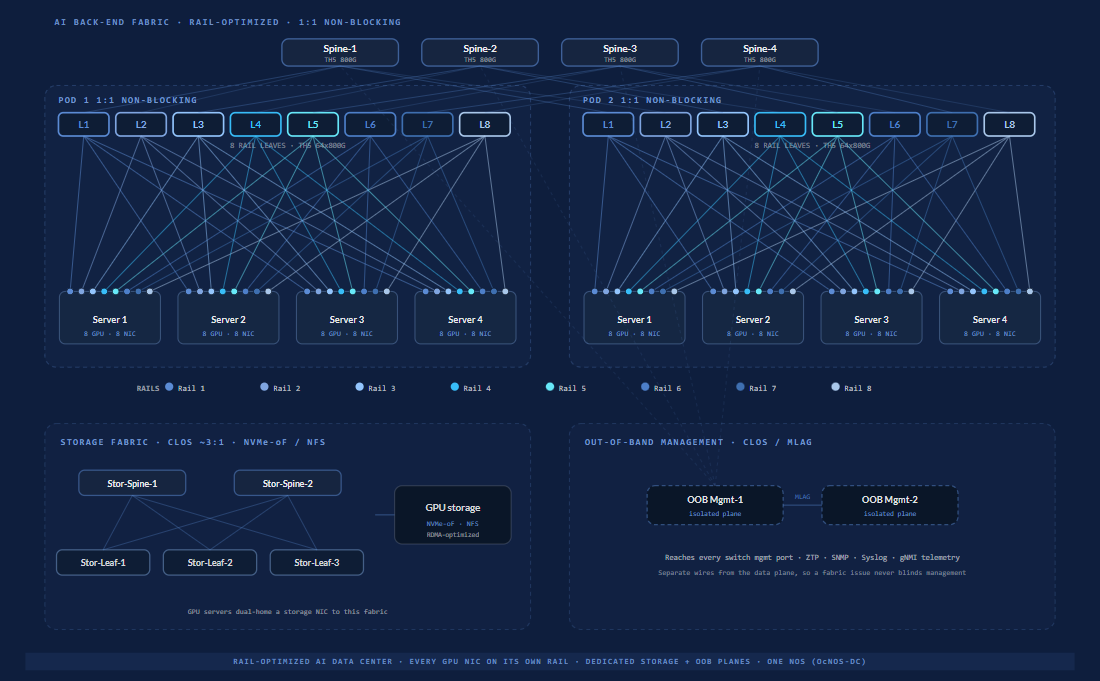
Composants OcNOS : Underlay L3 BGP unnumbered, RoCEv2 sans perte (PFC + ECN) sur chaque leaf de rail, DLB au niveau spine, télémétrie gNMI/OpenConfig de bout en bout. Bâti sur du matériel Tomahawk 5 inscrit à la HCL : l'Edgecore AIS800-64D et l'UfiSpace S9321-64E (64×800G).
Rail-optimized, rail-only et ToR, côte à côte
Le choix porte sur ce à quoi le fabric s'aligne. Une disposition en rail aligne chaque rang GPU sur un plan réseau, si bien que les GPU de même rang à travers le cluster partagent un leaf et que le collectif s'achève avec le plus faible nombre de sauts. Une disposition ToR s'aligne sur le serveur : chaque carte réseau d'un serveur aboutit sur son commutateur de rack, plus simple à câbler mais forçant les GPU de même rang situés dans des racks différents à remonter jusqu'au spine et à redescendre. Pour les fabrics d'entraînement GPU où l'AllReduce domine, l'alignement sur les rails est la norme ; le ToR reste un bon choix pour le stockage et les racks polyvalents où le trafic n'est pas synchrone par rang.
| Propriété | Optimisé par railstandard à un seul pod | Rail uniquemententrée pour petit cluster | Top-of-rack (ToR)aligné sur le serveur |
|---|---|---|---|
| Alignement | Chaque rang GPU aligné sur un plan réseau ; la NIC-N de chaque serveur se rattache au leaf-N. | Même alignement sur les rails : la NIC-N se rattache au leaf de rail N, mais une seule rangée de leaves. | Réseau aligné sur le serveur ; chaque carte réseau d'un serveur se rattache à son propre commutateur de rack. |
| Niveau spine | Spine 1:1 non bloquant au-dessus des leaves de rail. | Aucun niveau spine ; les leaves de rail sont autonomes. | Spine standard au-dessus des commutateurs de rack. |
| Chemin inter-rail | Un vrai chemin réseau à travers le spine non bloquant. | S'appuie sur le domaine de scale-up GPU interne au serveur ; aucune route de fabric dès qu'il dépasse un domaine. | Le trafic synchrone par rang est poussé jusqu'au spine. |
| Nombre de sauts du collectif | Le plus faible : les pairs de même rang partagent un leaf, si bien que l'AllReduce intra-rail reste sur un seul leaf. | Également faible en intra-rail, puisque le rail reste un seul leaf. | Plus élevé : les pairs de même rang situés dans des racks différents se trouvent sur des commutateurs différents, si bien que les collectifs traversent le spine. |
| Choix le plus adapté | L'unité évolutive standard à un seul pod pour les fabrics d'entraînement et d'inférence GPU. | Une poignée de racks sous un seul domaine de scale-up ; le point d'entrée. | Racks de stockage, de CPU et polyvalents où le trafic n'est pas synchrone par rang. |
Jusqu'où un fabric rail-optimized passe à l'échelle
L'échelle est déterminée par le radix du switch et par la façon dont chaque port 800G est réparti entre les GPU. Sur Broadcom Tomahawk 5 (51.2 Tbps, 64×800G ou 128×400G), les conceptions vont d'un leaf-spine à 2 niveaux jusqu'à trois niveaux avec un super-spine. Comme la majeure partie du trafic collectif reste locale au rail, le plan super-spine n'est dimensionné que selon le ratio inter-pod dont vous avez réellement besoin. Pour mémoire, Meta a décrit publiquement un cluster d'entraînement IA basé sur Ethernet de 24 576 GPU, ce qui montre des fabrics Ethernet fonctionnant bien au-delà d'un seul pod.
2 niveaux, 1:1 non bloquant
Leaf-spine rail-optimized à 800G par GPU, chaque GPU sur deux ports leaf 400G : 128 leaves, 64 spines. Le plus grand pod à deux niveaux sur ce silicium.
2 niveaux à 400G par GPU
La même conception à 2 niveaux pour des GPU dotés chacun d'une NIC 400G.
3 niveaux, super-spine
Au-delà de 4 096 GPU, ajoutez un niveau super-spine au-dessus des pods rail-optimized. Chaque pod reste non bloquant en 1:1 ; le super-spine fixe le ratio inter-pod.
Vous dimensionnez votre propre cluster ? La Suite de conception de fabric IA dimensionne un pod leaf-spine non bloquant à deux niveaux et signale lorsque vous franchissez l'échelle à trois niveaux. Pour une vue complète des topologies, voir la Topologies de fabric IA référence.
Comment OcNOS-DC construit un fabric rail-optimized
OcNOS-DC transforme les commutateurs Tomahawk 5 inscrits à la HCL en un fabric rail-optimized avec un underlay routé, un substrat RoCEv2 sans perte, un équilibrage de charge dynamique et de la télémétrie en continu. C'est un seul système : du matériel validé, le système d'exploitation réseau OcNOS-DC et un contrat de support unique avec un seul TAC et un seul SLA.
L3 BGP unnumbered
Un underlay routé avec BGP unnumbered supprime la planification d'adresses par lien et répartit le trafic sur chaque chemin rail-à-spine avec ECMP.
RoCEv2 avec PFC + ECN
OcNOS-DC fournit le substrat Ethernet sans perte que RoCEv2 exige : PFC maintient la priorité sans perte et ECN marque la congestion. RoCEv2 lui-même est le transport de la carte réseau qui s'appuie sur ce substrat.
Équilibrage de charge dynamique
DLB répartit les flux éléphants selon la qualité de chemin en temps réel au lieu d'un hachage statique, si bien que le trafic inter-rail ne s'accumule pas sur une seule liaison montante et qu'un fabric bien exploité peut viser une utilisation supérieure à 90 pour cent sur Tomahawk 4/5.
gNMI / OpenConfig
La télémétrie est diffusée via gNMI avec les modèles OpenConfig, si bien que vous réglez la fabric avec des données en boucle fermée pendant la mise en service du cluster.
Tomahawk 5 inscrit à la HCL
Fonctionne sur des commutateurs 64×800G validés : Edgecore AIS800-64D et UfiSpace S9321-64E. Chaque leaf et spine ici figure sur la liste de compatibilité matérielle (HCL) d'OcNOS.
Membre de l'Ultra Ethernet Consortium
IP Infusion est membre de l'Ultra Ethernet Consortium (UEC). UEC 1.0 définit un transport Ethernet multichemin qui répartit un flux sur de nombreux chemins et s'exécute sur des NIC compatibles UEC.
Obtenez la conception de référence de fabric IA
Le PDF complet : topologie optimisée par rail, nombre de commutateurs et de transceivers, plateformes validées et profil de départ RoCEv2 sans perte sur OcNOS-DC.
Obtenez la conception de référence de fabric IA
Formulaire court : votre PDF se télécharge immédiatement après l'envoi.
✓ Ouverture de votre PDF dans un nouvel onglet…
S'il ne s'est pas ouvert, utilisez le lien ci-dessous.
FAQ sur le réseau rail-optimized
Qu'est-ce qu'un réseau rail-optimized ?
Quelle est la différence entre rail-optimized et rail-only ?
Rail contre ToR : quelle disposition un fabric IA doit-il adopter ?
À combien de GPU un fabric rail-optimized passe-t-il à l'échelle ?
Un réseau rail-optimized a-t-il besoin d'InfiniBand ?
Comment OcNOS-DC met-il en œuvre un fabric rail-optimized ?
Approfondissez. Emportez-le avec vous.
La fiche technique du produit et des téléchargements techniques et concis qui vont plus loin que cette page.
Datasheet OcNOS-DC
Spécification complète OcNOS-DC : l'ensemble des fonctionnalités EVPN-VXLAN et Ethernet for AI, les SKU logiciels, les plateformes matérielles prises en charge et le guide de commande de la solution.
Obtenir la fiche techniqueOcNOS 800G Fabric IA sans perte
Fabric RoCEv2 sans perte sur des spines Tomahawk 5 : niveaux de SKU, plateformes qualifiées et architecture de déploiement.
Obtenir le briefFabric DC EVPN-VXLAN
Fabric de centre de données leaf-spine sur EVPN-VXLAN : une VRF et des VNI par locataire, multihoming EVPN, BGP unnumbered et filtrage par route target.
Obtenir le briefDatasheet OcNOS-DC
Formulaire rapide. Votre PDF s'ouvre dans un nouvel onglet immédiatement après l'envoi.
✓ Ouverture de votre PDF dans un nouvel onglet…
S'il ne s'est pas ouvert, utilisez le lien ci-dessous.
OcNOS 800G Fabric IA sans perte
Formulaire rapide. Votre PDF s'ouvre dans un nouvel onglet immédiatement après l'envoi.
✓ Ouverture de votre PDF dans un nouvel onglet…
S'il ne s'est pas ouvert, utilisez le lien ci-dessous.
Fabric DC EVPN-VXLAN
Formulaire rapide. Votre PDF s'ouvre dans un nouvel onglet immédiatement après l'envoi.
✓ Ouverture de votre PDF dans un nouvel onglet…
S'il ne s'est pas ouvert, utilisez le lien ci-dessous.
Vous planifiez un fabric GPU rail-optimized ? Nous ferons les calculs de nombre de ports avec vous.
Indiquez-nous l'échelle GPU et le nombre de rails, et un ingénieur IP Infusion dimensionnera avec vous le pod leaf-spine, ou commencez par un premier schéma dans l'AI Fabric Design Suite.
Concevez tout le fabric IA avec OcNOS
Du dossier économique au calcul du nombre de ports, reprenez où vous en êtes dans la construction.