Topologies de fabric IA : conceptions rail-optimized jusqu'à 16K GPU
Adaptez la topologie au nombre de GPU : un pod leaf-spine rail-optimized à deux niveaux jusqu'à 4 096 GPU, un troisième niveau super-spine au-delà jusqu'à 16 384, et du DCI cohérent pour relier les sites. Choisissez le plus petit design non bloquant qui garde le lien de chaque GPU saturé pendant les collectives. Les trois s'exécutent sur OcNOS-DC au-dessus d'un fabric L3 RoCEv2 sans perte (PFC + ECN), dimensionné ici en nombres de ports concrets sur Broadcom Tomahawk 4 et Tomahawk 5.
Le plus petit design non bloquant adapté à votre nombre de GPU
Une topologie de fabric IA a une seule mission : maintenir saturé le lien sortant de chaque GPU pendant une opération collective sans créer de valeurs aberrantes de tail-latency. La bonne topologie est la plus petite qui y parvient pour votre nombre de GPU, avec une voie de repli pour la taille suivante. Trois points de référence, avec des calculs de ports concrets sur le silicium Broadcom Tomahawk.
Un leaf-spine à deux niveaux atteint 4 096 GPU à 800G par GPU ; un déploiement de 1 024 GPU compte 32 leaves et 16 spines, soit 48 switchs. Au-delà de 4 096 GPU, ajoutez le niveau super-spine. La même image OcNOS-DC fonctionne à chaque niveau, de sorte que la fabric évolue avec le cluster au lieu d'être reconçue à chaque étape.
Vous dimensionnez votre propre cluster ? La Suite de conception de fabric IA fournit un premier dimensionnement rapide : il dimensionne un pod leaf-spine non bloquant à deux niveaux et signale lorsque vous franchissez l'échelle à trois niveaux. Les reference designs ci-dessous utilisent le même calcul leaf/spine non bloquant et ajoutent un niveau super-spine au-delà de 4 096 GPU, de sorte que les nombres de switchs concordent avec l'outil. Ici, rail-optimized désigne la discipline de câblage d'un serveur GPU à 8 NIC (un rail par leaf, de sorte que l'AllReduce intra-rail reste sur le leaf) superposée à cette fabric non bloquante : elle modifie la localité du trafic, pas le nombre de switchs. Utilisez l'outil pour un ordre de grandeur ; utilisez ces conceptions pour le déploiement.
Pod à deux niveaux, fabric à trois niveaux et DCI cohérent
Trois topologies de référence couvrent les fabrics IA mono-pod, multi-pod et multi-site, chacune dimensionnée sur du matériel Broadcom figurant dans la HCL.
Pod unique optimisé par rail
Sur chaque serveur GPU, les 8 NIC arrivent sur 8 rail leaves dédiés, de sorte que l'AllReduce sur le même rail reste sur un seul leaf et ne traverse jamais le spine. Un spine non bloquant transporte les flux inter-rails. L'unité évolutive single-pod, jusqu'à 4 096 GPU sur Tomahawk 5.
Fabric rail-optimized à trois niveaux
Les étages leaf, spine et super-spine portent la fabric au-delà de 4 096 GPU, jusqu'à 16 384 dans le reference design. Non bloquant au sein de chaque pod, le plan super-spine fixant le ratio inter-pod. DLB à chaque saut, GLB de bout en bout dans OcNOS 7.1.
DCI cohérent multi-datacenters
Lorsqu'un entraînement s'étend sur plusieurs salles machines, étendez le fabric avec des optiques cohérentes 400G ZR / ZR+ sur le spine. DCI sans transpondeur entre sites, avec la fabric interne au site inchangée.
Pod unique optimisé par rail
Chaque serveur GPU dispose de 8 NIC, une par rail (un canal collectif xCCL dédié (NCCL / RCCL / oneCCL)). Chaque rail correspond à son propre leaf dédié, de sorte que les 8 NIC de chaque serveur arrivent sur un leaf différent. Le trafic AllReduce sur le rail N reste au sein du leaf N, si bien qu'il n'y a aucune pression est-ouest sur le spine pour le motif collectif dominant.
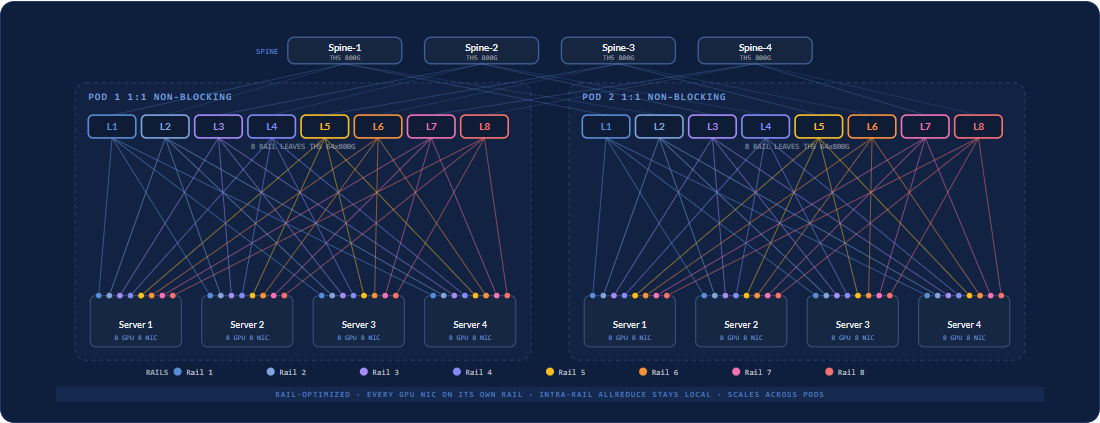
Composants OcNOS : Underlay L3 BGP-unnumbered, RoCEv2 sans perte (PFC + ECN) sur chaque leaf, DLB à l'étage spine. Bâti sur du matériel référencé HCL : l'unité extensible 800G utilise des leaves et spines TH5 64x800G (Edgecore AIS800-64D ou UfiSpace S9321-64E) ; le pod d'entrée 256-GPU utilise l'Edgecore AS9736-64D (TH4, 64x400G).
Fabric rail-optimized à trois niveaux : au-delà de 4 096 GPU
Un pod rail-optimized à deux niveaux sur Tomahawk 5 plafonne à 4 096 GPU à 800G par GPU, lorsque les spines n'ont plus de ports. Au-delà, la même conception rail-optimized ajoute un troisième niveau : leaf, spine, super-spine. Deux GPU quelconques sont séparés d'au plus quatre sauts de switch ; les pairs sur le même leaf et dans le même pod sont plus proches.
La difficulté sur un Clos consiste à répartir les flux uniformément pour qu'aucun lien ne devienne un point chaud. Les approches vont de l'ECMP par flux à l'équilibrage de charge dynamique, jusqu'au packet spray par paquet, le modèle qu'utilise Ultra Ethernet avec le réordonnancement géré par la NIC. Une famille distincte, les fabrics ordonnancés à cellules comme Broadcom DDC, segmente le trafic en cellules et l'ordonnance à l'intérieur du fabric. OcNOS équilibre le plan GPU avec DLB et ajoute un GLB à l'échelle du fabric dans OcNOS 7.1.
Le schéma est simplifié : il représente un nombre réduit d'éléments par niveau. Le déploiement de 16 384 GPU compte 512 leaves / 256 spines / 128 super-spines sur TH5 800G.
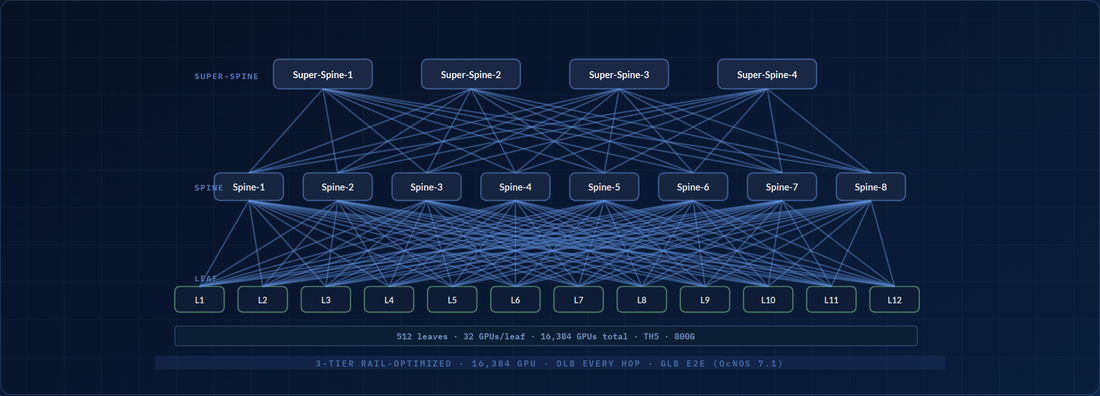
Composants OcNOS : Underlay L3 eBGP-unnumbered, RoCEv2 sans perte (PFC + ECN), DLB à chaque étage, GLB de bout en bout dans OcNOS 7.1, et télémétrie en streaming gNMI vers votre pile d'observabilité. Bâti de bout en bout sur des châssis TH5 64x800G référencés HCL.
Le taux de souscription est un réglage, pas une règle figée. Ces nombres rendent chaque pod de 1 024 GPU non bloquant en 1:1 et utilisent un super-spine optimisé en coût à ~2:1 pour le trafic inter-pod, l'approche rail-optimized sur laquelle reposent les fabrics Ethernet hyperscale (les conceptions à grande échelle publiées sursouscrivent bien davantage le niveau supérieur, car le trafic collectif reste local au pod). Vous voulez plutôt une marge any-to-any maximale ? Un déploiement entièrement non bloquant 1:1 compte 512 / 512 / 256 à 16 384 GPU ; seuls les nombres de spines et de super-spines changent. Modélisez l'un ou l'autre dans le Suite de conception de fabric IA.
Fabric IA multi-datacenters : DCI cohérent
Lorsqu'un même entraînement s'étend sur plus d'une salle de données, ce qui est de plus en plus courant pour les modèles à mille milliards de paramètres, la fabric s'étend à travers le WAN. OcNOS-DC prend en charge les optiques cohérentes 400G ZR / ZR+ directement sur le spine pour un DCI sans transpondeur entre sites. La fabric à l'intérieur de chaque site reste inchangée.
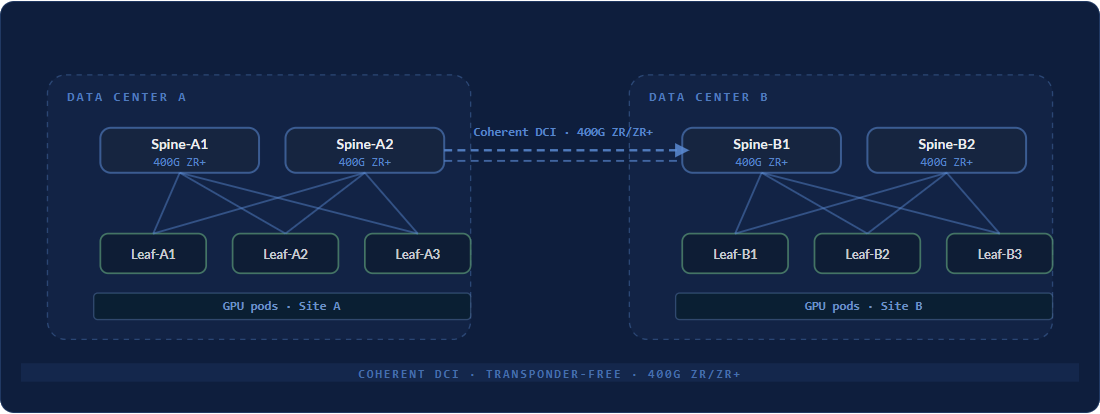
Composants OcNOS : Optiques cohérentes enfichables 400G ZR/ZR+ sur un port spine ou border-leaf compatible DWDM, avec télémétrie gNMI entre les sites. Aucun transpondeur externe requis. Portée : 400ZR jusqu'à environ 120 km en amplifié ; OpenZR+ va plus loin grâce à l'oFEC.
Règles de conception empiriques
Quelques règles maintiennent un fabric IA du bon côté de la courbe performance/coût, quelle que soit l'architecture de référence retenue.
- Adaptez la topologie au nombre de GPU. Pods les plus petits (en deçà du radix de NIC d'un seul leaf) : le rail-only suffit. Échelle d'un seul pod, jusqu'à 4 096 GPU sur Tomahawk 5 : leaf-spine optimisé pour le rail. Au-delà : ajoutez un niveau super-spine à la même conception rail-optimized, avec un pod non bloquant et un ratio inter-pod ajusté à la charge de travail.
- Toujours une souscription 1:1 sur le plan IA. Les baies de stockage et de CPU peuvent fonctionner avec des ratios de surabonnement plus élevés. Le plan GPU ne le devrait pas.
- Dimensionnez le nombre de rails à partir de xCCL, pas du câblage. 8 rails constitue le standard de facto actuel pour les serveurs GPU à 8 NIC. Ne regroupez pas les rails sur un nombre réduit de leaves.
- Choisissez le silicon selon la puissance et la densité, pas selon le badge. Le TH4 (25,6T) et le TH5 (51,2T) sont les bêtes de somme ; le choix entre les deux relève de la puissance en rack et du coût des câbles breakout.
- Validez par rapport à la HCL. Chaque référence présentée ici repose sur du matériel listé dans le Liste de compatibilité matérielle OcNOS; partez de là pour un support de premier ordre.
FAQ sur la topologie du fabric IA
Qu'est-ce qu'une topologie optimisée par rail, et en quoi diffère-t-elle du rail-only ?
Quand une fabric IA a-t-elle besoin d'un troisième niveau ?
Dois-je utiliser Tomahawk 4 ou Tomahawk 5 ?
Ai-je besoin d'InfiniBand, ou Ethernet suffit-il ?
Où s'arrête le scale-up et où commence le scale-out ?
Approfondissez. Emportez-le avec vous.
La fiche technique du produit et des téléchargements techniques et concis qui vont plus loin que cette page.
Datasheet OcNOS-DC
Spécification complète OcNOS-DC : l'ensemble des fonctionnalités EVPN-VXLAN et Ethernet for AI, les SKU logiciels, les plateformes matérielles prises en charge et le guide de commande de la solution.
Obtenir la fiche techniqueOcNOS 800G Fabric IA sans perte
Fabric RoCEv2 non bloquante sur des spines Broadcom Tomahawk 4/5 : niveaux de SKU, plateformes validées et architecture de déploiement.
Obtenir le briefFabric DC EVPN-VXLAN
Fabric de data center leaf-spine de niveau opérateur : IRB symétrique, routes Type-2/Type-5 et passerelle anycast distribuée.
Obtenir le briefDatasheet OcNOS-DC
Formulaire rapide. Votre PDF s'ouvre dans un nouvel onglet immédiatement après l'envoi.
✓ Ouverture de votre PDF dans un nouvel onglet…
S'il ne s'est pas ouvert, utilisez le lien ci-dessous.
OcNOS 800G Fabric IA sans perte
Formulaire rapide. Votre PDF s'ouvre dans un nouvel onglet immédiatement après l'envoi.
✓ Ouverture de votre PDF dans un nouvel onglet…
S'il ne s'est pas ouvert, utilisez le lien ci-dessous.
Fabric DC EVPN-VXLAN
Formulaire rapide. Votre PDF s'ouvre dans un nouvel onglet immédiatement après l'envoi.
✓ Ouverture de votre PDF dans un nouvel onglet…
S'il ne s'est pas ouvert, utilisez le lien ci-dessous.
Vous concevez votre fabric IA ? Nous calculerons le nombre de ports avec vous.
Indiquez-nous la charge de travail et l'échelle GPU, et un ingénieur IP Infusion dimensionnera avec vous les étages leaf, spine et super-spine, ou commencez par une première ébauche de topologie dans l'AI Fabric Design Suite.
Concevez tout le fabric IA avec OcNOS
Du dossier économique au calcul du nombre de ports, reprenez où vous en êtes dans la construction.