BCM78900 · TSMC 5 nm · 自 2023 年 3 月起出货

Broadcom Tomahawk 5 Tomahawk 5 交换机 三款 800G 开放平台,已在 OcNOS-DC 上完成验证。

Edgecore AIS800-64D、UfiSpace S9321-64E 和 S9321-64EO:相同的芯片、相同的 OcNOS-DC 镜像、三条采购路径。为正在挑选 Tomahawk 5 交换机的工程师提供规格、决策规则以及 OcNOS-DC 特性面。

51.2Tbps
交换容量
64×800G
原生端口密度
3SKUs
OcNOS 已验证
2ODMs
Edgecore · UfiSpace
5nm
TSMC N5 工艺
01
交换机

三款 800G 平台。两家 ODM。同一套 OcNOS-DC 镜像。

两种硬件设计,三个 SKU。三款产品出厂均预装 ONIE,并运行同一个 OcNOS-DC 镜像。区别在于外形规格(QSFP-DD 与 OSFP)、品牌定位(AI 网络 SKU 与通用数据中心 SKU),以及部署所依托的光模块生态。每张卡片都链接到厂商完整数据手册(PDF,本站托管)。

Edgecore· DCS560 平台家族
AI fabric 骨干层

AIS800-64D

经 OcNOS-DC 验证 · 预装 ONIE
端口
64 × QSFP-DD800拆分:2×400 / 4×200 / 8×100(320 个逻辑端口)
外形
2RU
电源
2× 3000 W AC/DC 冗余每个 QSFP-DD 端口 30 W
CPU
Intel Xeon D1713NTE
▌ 适用场景

GPU 集群 AI fabric。采用 AI-fabric SKU 定位的 Edgecore DCS560 机箱。
UfiSpace· S9321 平台系列
AI fabric 骨干层

S9321-64E

经 OcNOS-DC 验证 · 预装 ONIE
端口
64 × QSFP-DD (200/400/800G)拆分:2×400 / 4×200 / 8×100
外形
2RU · 23.72 kg
电源
典型 913 W(不含光模块)每个 QSFP-DD 端口 30 W
CPU
Intel Icelake-D 4 核 · 32 GB DDR4
▌ 适用场景

大规模、低熵的AI流量。UfiSpace将64E定位用于以AllReduce为主的流量,其中TH5动态负载均衡是设计的核心。

UfiSpace· S9321 平台系列
800G DCI · 相干光模块

S9321-64EO

经 OcNOS-DC 验证 · 预装 ONIE
端口
64 × OSFP (200/400/800G)拆分:2×400 / 4×200 / 8×100
外形
2RU · 23.74 kg
电源
典型 925 W · 200-240 V AC用于更高功率光模块的 OSFP 笼
CPU
Intel Icelake-D · 32 GB DDR4
▌ 适用场景

更高功率模块类别。64E 采用 OSFP 形态:当光模块决定笼位选择时即可选用。

· 如何在三款产品中选择

AIS800 与 S9321-64E 对比同款 TH5 芯片,双 ODM 来源。Edgecore DCS560 (AIS800-64D) 与 UfiSpace S9321:面向超大规模与 NeoCloud 采购的双源 BoM。
QSFP-DD vs OSFPQSFP-DD(S9321-64E 和 AIS800-64D)适用于大批量供应的光模块生态。OSFP(S9321-64EO)适用于更高功率的模块等级。
Edgecore vs UfiSpace两者都是开放硬件 ODM。可根据您与 ODM 的合作关系、RMA 物流或 BoM 成本进行选择。
单一厂商风险两家厂商均提供 TH5 平台,意味着双源 BoM 切实可行,这对超大规模和 NeoCloud 采购至关重要。
02
深入芯片内部

Tomahawk 5:Broadcom 的旗舰通用交换 ASIC。

BCM78900 是一颗 5 nm 单片裸片,提供 51.2 Tbps 交换容量,原生支持 64 个 800GbE 端口、128 个 400G 端口或 256 个 200G 端口。它是 Broadcom 首款 5 nm 商用交换 IC。 512 条 SerDes 通道,以 100G PAM4 运行:与 Tomahawk 4 相同的通道数量,每通道速率翻倍。

除原始容量之外,AI fabric 还取决于三项架构选择: 共享缓冲架构 在硬件层吸收 xCCL (NCCL / RCCL / oneCCL) 集体通信微突发 认知路由 (DLB)可在 ASIC 中重新绑定大象流,配合 5 nm 的散热余量,使 30 W 的 QSFP-DD800 笼位无需逐端口主动散热即可运行。

规格可对照 Broadcom 公开资料进行验证 BCM78900 产品页面.

工艺TSMC N5 系列StrataXGS 缓存共享、RDMA 调优 路由认知式 · DLB 出货自 2023 年 3 月起
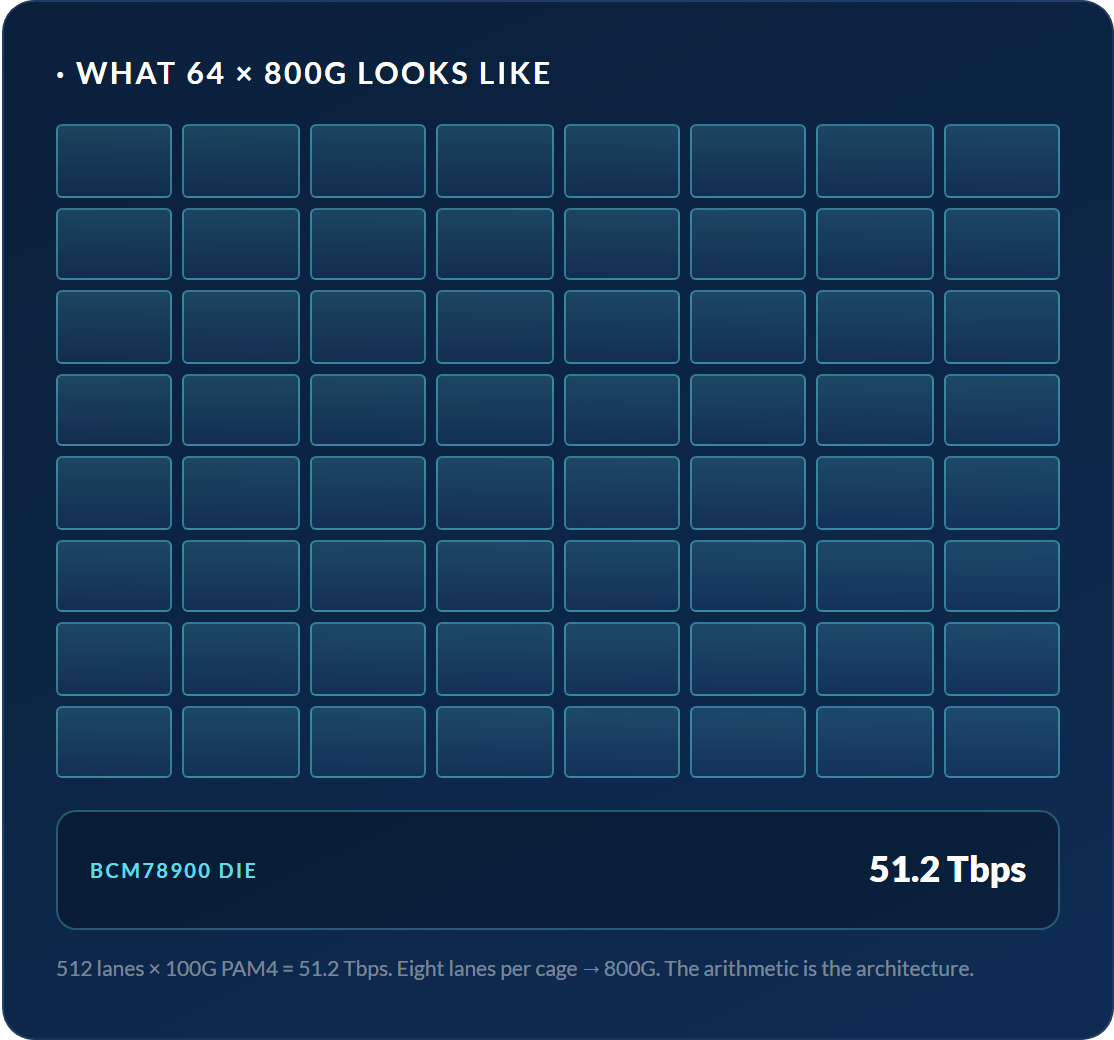
Broadcom Tomahawk 5 (BCM78900) 端口基数以 64 个端口的网格形式呈现,每个端口为 800G QSFP-DD,单芯片合计提供 51.2 Tbps 的交换容量
64 x 800G 的构成:BCM78900 芯片上 512 条 100G PAM4 通道,合计 51.2 Tbps。

TH5 为何适合开放 AI fabric。

夺人眼球的指标数字会登上新闻头条。但这四项工程选择,才是 AI fabric 架构师真正关心的。

原则 01

通道数相同,速率翻倍。

TH5 与 TH4 一样配备 512 条 SerDes 通道,但以 100G PAM4 而非 50G 运行。吞吐量翻倍源于既有基础设施的提速,而非额外增加通道。

100G PAM4 · 106 Gbps
原则 02

共享缓存,而非分区。

全部 64 个端口共享的报文内存池、而非按端口划分。某一端口上的 xCCL AllReduce 微突发会被吸收进全局 fabric 池,而不会触发 tail-drop。这就是 TH5 在 RoCEv2 上胜出的关键所在。

共享缓冲 · RDMA 调优
原则 03

硬件动态负载均衡。

Broadcom Cognitive Routing 在 ASIC 内检测拥塞路径并重绑定大象流:无需控制器往返,也无需 ECMP 重新哈希。OcNOS-DC 以 DLB Reactive-Path Rebalance 形式将其开启。

DLB · flowlet
原则 04

5 nm 散热裕量。

首款 5 nm 通用交换芯片。正是这一制程缩减,使每个 QSFP-DD800 笼位 30 W 的功耗在无需逐端口主动散热的情况下成为可能,包括高功率 800G 光模块和 8×100G breakout。

TSMC N5 · 每端口 30 W
03
代际跨越

单端口速率翻倍。容量翻倍。同样的 64 端口规模。

TH4(25.6 Tbps · 64×400G · 7 nm)对于围绕 400G 网卡构建的集群仍然表现出色。当每端口 800G 和 AI 网络原语都重要时,TH5 才对得起它的机架空间。

Tomahawk 6:1.6T 带来的变化 →

交换容量
25.6 Tbps → 51.2 Tbps

在相同机架占用下容量翻倍。相同的 2RU,相同的功耗等级。

逐端口速率
64 × 400G → 64 × 800G

在 IPI 实际平台上保持相同的 64-port radix (AS9736-64D → AIS800-64D / S9321)。每端口带宽翻倍,因此每个 Clos 层承载的流量也翻倍。

制程节点
7 nm → 5 nm

首款 5 nm 通用交换芯片。具备 30 W/端口的热余量,无需主动散热。

每通道 SerDes
50G PAM4 → 100G PAM4

同样的 512 条通道,速率翻倍。吞吐量的翻番源自现有基础设施。

棕地改造保持简洁。 同一份 OcNOS-DC 镜像可运行于 TH3、TH4 和 TH5 平台:配置、自动化和 gNMI 流水线均可沿用。新集群可选 TH5;现有可用的 TH4 则继续保留。
04
OcNOS-DC 交付内容

运营商级 NOS。面向 AI 调优的默认配置。

Tomahawk 5 具备硬件能力。NOS 的职责是将其暴露给运维人员、遥测管线和集群调度器,而无需他们围绕它编写繁复的 CLI 操作。OcNOS-DC 将这些原语作为一等的可配置对象交付,并以 YANG 建模其状态。

共享缓冲架构,零丢包东西向流量。

OcNOS-DC 提供 PFC + ETS + Dynamic ECN。TH5 的共享缓冲池可吸收同步的多对一流量,而这类流量在分区缓冲芯片上会发生尾部丢弃。

DLB 在 ASIC 中对 flowlet 重新绑定。

大象流下的 ECMP 哈希冲突是 AI 网络的致命问题。OcNOS-DC 开启 TH5 Cognitive Routing 的 flowlet 重绑定,使 AllReduce 流量自动分散到每条 spine 路径上。

逐端口、逐优先级。自动排空。

在暂停队列周期挂起训练任务之前即可检测到。无需运维人员介入即可自动恢复。

gNMI on-change, OpenConfig YANG.

缓存深度、ECN 标记、PFC 暂停计数:每个阈值都是一个旋钮,每个计数器都是一条传感器路径。可对接 Prometheus、Grafana、OTel。

BGP · OSPF · IS-IS,在支持的平台上还有 EVPN-VXLAN。

TH5 spine 同时也是一台真正的路由器。在同一款芯片上运行完整的运营商级三层栈:像运维网络其余部分一样运维 AI fabric,而非把它当作黑盒。

来自实时 OcNOS Feature Matrix 的 TH5 功能。

三层路由 · L1/L2 · AI fabric 基础功能 · 组播 · QoS · 安全 · 硬件 · 管理。每一项均在公开矩阵中按平台列出。

RoCEv2 / PFC DCQCN DLB BGP / OSPF / IS-IS gNMI / NETCONF ZTP
Day-0 至 Day-2

ZTP. gNMI on-change. NETCONF + YANG. DCBX.

通过零接触部署在机架中启用一台 TH5 spine。将每个计数器流式输出至您的可观测性栈。通过 YANG 建模的配置调整每个阈值。无需任何粘合脚本。

ZTP IPv4/IPv6 gNMI NETCONF OpenConfig YANG DCBX LLDP Ansible Terraform 提供者

三类运营商画像。一套芯片 + NOS 组合。

相同的 TH5 裸片、相同的 OcNOS-DC 镜像,对同一架构问题给出三种不同的诠释:如何在不将整个技术栈锁定于单一厂商的前提下,扩展无损东西向流量?

在通用芯片上支持高达 16k-GPU 上限的训练网络。

“我们需要 800G 直连叶节点、无损 RoCEv2,以及在 AllReduce 下不会失控的尾部时延。单一厂商锁定不在考虑范围内。”

TH5 64×800G spine、带 PFC 和 ECN 的 RoCEv2、支持 Reactive Path Rebalance 的 DLB、PFC 死锁检测与恢复。与 TH4 相同的 64 端口规模,但每个 spine 端口承载 800G,在相同 fabric 总带宽下将 spine-leaf 布线量减半。

DC · AI 网络 SKU

AI 集群运营商

多租户 fabric,BoM 成本可控。

“客户自行选择 GPU。我们无法把织构 BoM 绑定到他们的 NIC 选型上。我们需要一款至少能从两家厂商采购的交换机。”

来自两家厂商(Edgecore、UfiSpace)的三款经 OcNOS 验证的 TH5 SKU。VRF-Lite 租户隔离、gNMI 按租户遥测,以及在平台支持时的 EVPN-VXLAN 分段。一个 NOS 镜像,多厂商硬件。

DC · 多租户

NeoCloud · GPU 即服务

TH3/TH4 fabric 升级换代,无需整机更换。

"我们已有一套 TH4 网络结构投入生产。下一个训练集群需要 800G 网卡。我们不想为了升级芯片而重新设计整个 NOS 层。"

同一套 OcNOS-DC 镜像运行在 TH3、TH4 和 TH5 平台上。棕地改造可完整保留配置、自动化与 gNMI 管线。

DC · TH3 至 TH5

超大规模数据中心 · 棕地改造

架构师关心的问题

横跨两家 ODM 的三款开放硬件平台:Edgecore AIS800-64D(DCS560 机箱)、UfiSpace S9321-64E(QSFP-DD)和 S9321-64EO(OSFP)。三者均预装 ONIE 出厂,并运行同一套 OcNOS-DC 镜像:相同的配置、相同的功能面、相同的自动化挂钩。两家供应商意味着双源 BoM 对超大规模和 NeoCloud 采购而言切实可行。
QSFP-DD(AIS800-64D 和 S9321-64E)是大规模量产的光模块生态,是数据中心内部短距 800G 的恰当默认选择。OSFP(S9321-64EO)则提供更高功率的笼体,可容纳 QSFP-DD 无法承载的模块类型:例如更长距离的 DR4/DR8,以及可插拔放大器。当光模块决定了笼体选择时,请选 OSFP;否则在成本和生态广度上 QSFP-DD 更胜一筹。
TH4 为 25.6 Tbps · 64×400G · 7 nm · 50G PAM4。TH5 在相同的 64 端口规模下,将单端口速率和总交换容量翻倍(51.2 Tbps · 64×800G · 5 nm · 100G PAM4)。决策规则:如果集群原生需要 800G 端口,或每个 spine 端口需要承载两倍带宽(在相同 fabric 总吞吐量下将布线量减半),请选择 TH5。如果设计围绕 400G NIC 和单 pod 规模构建,TH4 仍是出色的选择,且单端口成本更低。OcNOS-DC 以同一镜像支持两者:存量升级依然顺畅。
Ultra Ethernet 端点行为(数据包喷洒、重排序、选择性重传)运行在支持 UEC 的 NIC 上,而 UEC 1.0 规范也涵盖链路和交换机行为,因此 UEC 的适配取决于 NIC、交换芯片和 NOS 版本。目前在 Tomahawk 5 上,OcNOS-DC 以 PFC、ECN 和 DLB 在生产环境中运行无损 RoCEv2。IP Infusion 是 Ultra Ethernet Consortium 的成员。如需规划 UEC 如何融入具体部署,请联系我们。
在 TH5 上,OcNOS-DC 提供以下 AI fabric 功能:PFC over L3、ETS、Dynamic ECN、DLB Reactive-Path Rebalance、DLB Random-Flow、PFC 死锁检测与恢复、交换机数据包缓冲调优、DCBX LLDP。在同一芯片上,它还运行完整的运营商级三层协议栈(BGP、OSPF、IS-IS),并在平台支持时提供 EVPN-VXLAN。OcNOS Feature Matrix 按平台列出了每项功能。
SP 边缘、蜂窝基站网关、1 Tbps 以下的汇聚。在这些角色中,64×800G 的端口密度不足以体现其机架空间价值。对于 SP 路由,OcNOS 验证了 Broadcom Qumran(Q2C、Q2C+)和 Jericho(J2C+);对于单 pod 环境下的 100G/400G DC 叶交换机,Trident(TD3-X7、TD4)经济性更优。当 800G 端口密度和 AI 网络原语都重要时,TH5 胜出。

正在设计 Tomahawk 5 fabric?让我们一起为它定型。

与 OcNOS 网络架构师进行 30 分钟的架构沟通。带上您的 GPU 数量、NIC 速率和层级偏好,即可获得覆盖三款 TH5 SKU 的规格化物料清单。