BCM78900・TSMC 5 nm・2023年3月より出荷中

Broadcom Tomahawk 5 Tomahawk 5 スイッチ OcNOS-DCで検証済みの3つの800Gオープンプラットフォーム。

Edgecore AIS800-64D、UfiSpace S9321-64E および S9321-64EO:同一のシリコン、同一の OcNOS-DC イメージ、3 つの調達経路。Tomahawk 5 スイッチを選定するエンジニア向けの仕様、判断基準、OcNOS-DC 機能群。

51.2Tbps
スイッチ容量
64×800G
ネイティブポートレイディックス
3SKUs
OcNOS 検証済み
2ODMs
Edgecore · UfiSpace
5nm
TSMC N5プロセス
01
スイッチ
Tomahawk 5を搭載したオープンハードウェア

3つの800Gプラットフォーム。2つのODM。単一のOcNOS-DCイメージ。

2 つのハードウェア設計と 3 つの SKU。3 製品とも ONIE をプリロードして出荷され、同じ OcNOS-DC イメージで動作します。違いは、フォームファクター(QSFP-DD と OSFP)、ブランディング(AI ファブリック向け SKU と汎用 DC 向け SKU)、導入の前提となる光モジュールのエコシステムです。各カードからベンダーの詳細なデータシート(PDF、当サイトでホスト)にリンクしています。

Edgecore・ DCS560プラットフォームファミリー
AI ファブリックスパイン

AIS800-64D

OcNOS-DC で検証済み・ONIE プリロード
ポート
64 × QSFP-DD800ブレイクアウト:2×400/4×200/8×100(論理320ポート)
フォームファクター
2RU
電源
2× 3000 W AC/DC 冗長QSFP-DDケージあたり30W
CPU
Intel Xeon D1713NTE
▌ こんなときに最適

GPUクラスター向けAIファブリック。AIファブリックSKU構成のEdgecore DCS560シャーシ。
UfiSpace・S9321プラットフォームファミリー
AI ファブリックスパイン

S9321-64E

OcNOS-DC で検証済み・ONIE プリロード
ポート
64 × QSFP-DD (200/400/800G)ブレイクアウト:2×400/4×200/8×100
フォームファクター
2RU · 23.72 kg
電源
標準消費電力 913W(トランシーバーなし)QSFP-DDケージあたり30W
CPU
Intel Icelake-D 4コア・32 GB DDR4
▌ こんなときに最適

大規模で低エントロピーのAIフローです。UfiSpaceは、TH5の適応型ルーティングが設計の中核となるAllReduce主体のトラフィック向けとして64Eを訴求しています。

UfiSpace・S9321プラットフォームファミリー
800G DCI・コヒーレント光

S9321-64EO

OcNOS-DC で検証済み・ONIE プリロード
ポート
64 × OSFP (200/400/800G)ブレイクアウト:2×400/4×200/8×100
フォームファクター
2RU · 23.74 kg
電源
標準 925 W · 200-240 V AC高出力光モジュール向けOSFPケージ
CPU
Intel Icelake-D・32 GB DDR4
▌ こんなときに最適

800G ZR/ZR+コヒーレントやその他の高電力モジュールクラス。64EのOSFPフォームファクタ:光モジュールがケージ選択を左右する場合に選択。

· 3 製品の選び方

AIS800 と S9321-64E の比較同じ TH5 シリコン、2 つの ODM。Edgecore DCS560 (AIS800-64D) と UfiSpace S9321:ハイパースケールおよび NeoCloud 調達のためのデュアルソース BoM。
QSFP-DD vs OSFPQSFP-DD(S9321-64E と AIS800-64D)は量産型の光モジュールのエコシステム向けです。OSFP(S9321-64EO)は 800G ZR/ZR+ コヒーレントを含む高出力のモジュールクラス向けです。
Edgecore vs UfiSpaceいずれもIP Infusionとの緊密なコデザインを実現したオープンハードウェアODMです。ODMとの関係性、RMAロジスティクス、またはBoMの経済性に応じて選定してください。
単一ベンダーのリスクTH5プラットフォームを持つベンダーが2社あることで、デュアルソースのBoMが現実的になり、これはハイパースケールおよびNeoCloudの調達において重要です。
02
シリコンの内部
1ダイ51.2 Tbpsがもたらす価値

Tomahawk 5:Broadcomのフラッグシップマーチャントスイッチ ASIC。

BCM78900 は51.2 Tbpsのスイッチング容量を提供する単一の5 nmモノリシックダイであり、800GbE 64ポート、400G 128ポート、または200G 256ポートをネイティブに供給します。Broadcom初の5 nmマーチャントスイッチICであり、ケージで800GbEをサポートした世界初の製品でした。 100G PAM4で動作する512本のSerDesレーン:Tomahawk 4と同じレーン数で、レーンあたりの速度は2倍。

生のキャパシティにとどまらず、3つのアーキテクチャ上の選択がTH5を大半の本番AIファブリックを支えるシリコンたらしめました: 共有バッファアーキテクチャ xCCL (NCCL / RCCL / oneCCL) コレクティブのマイクロバーストをハードウェアで吸収 コグニティブルーティング (DLB)はエレファントフローをASIC内で再バインドし、5 nmの熱ヘッドルームにより30 W QSFP-DD800ケージをポート単位のアクティブ冷却なしで動作可能に。

Broadcom 公開資料に対して検証可能な仕様 BCM78900製品ページ.

プロセスTSMC N5 シリーズStrataXGS バッファ共有型・RDMA 最適化 ルーティングコグニティブ・DLB 出荷2023年3月より
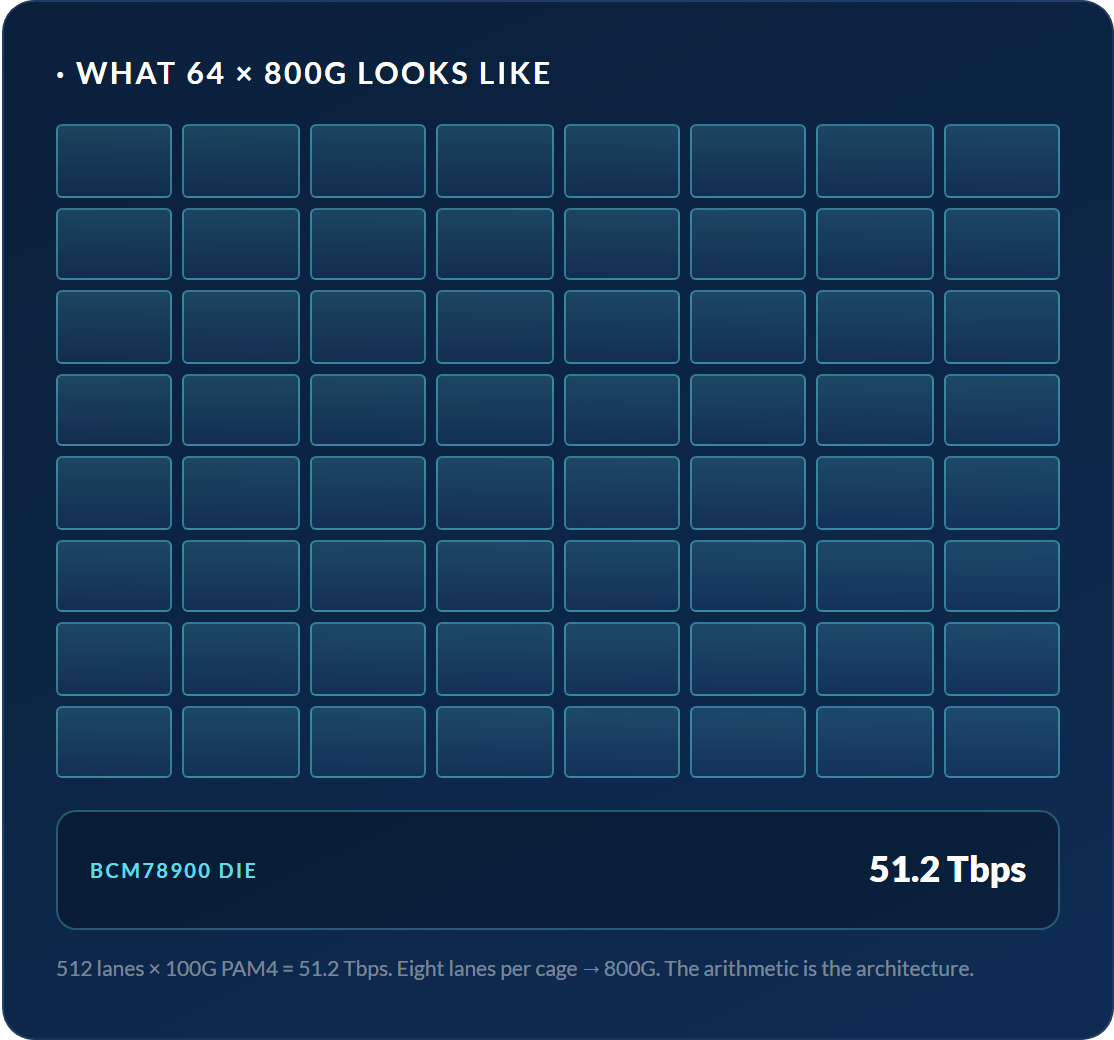
Broadcom Tomahawk 5 (BCM78900) のポート基数を64ポートのグリッドで表示。各ポートは 800G QSFP-DD で、単一ダイ上で合計 51.2 Tbps のスイッチング能力を実現します。
64 x 800G の構成イメージ:100G PAM4 の512レーンが BCM78900 ダイ上で合計 51.2 Tbps を構成します。
重要な4つの設計上の選択

2024年以降に構築されたほぼすべてのオープンAIファブリックにTH5が採用された理由。

見出しの数字は報道を集めます。しかし、AIファブリックのアーキテクトが実際に重視するのは、この4つのエンジニアリング上の選択です。

原則 01

同じレーン数で、2倍の速度。

TH5はTH4と同じ512本のSerDesレーンを備え、50Gではなく100G PAM4で動作させます。スループットの倍増は、新規インフラの追加ではなく既存インフラの高速化によって実現されました。

100G PAM4・106 Gbps
原則 02

共有バッファであり、分割ではありません。

全 64 ポートに共通のパケットメモリプール、ポートごとに分割されません。1 ポート上の xCCL AllReduce マイクロバーストはファブリック全体のプールに吸収され、テールドロップを引き起こしません。TH5 が RoCEv2 で勝つ理由を一文で言えばこれです。

共有バッファ · RDMA 最適化
原則 03

ハードウェア適応型ルーティング。

Broadcom Cognitive Routingは輻輳パスを検出し、エレファントフローをASIC内で再バインドします:コントローラーへの往復もECMP再ハッシュも不要。OcNOS-DCはこれをDLB Reactive-Path Rebalanceとして有効化します。

DLB ・ 64 µs フローレット
原則 04

5 nmプロセスの熱設計余裕。

業界初の5nmマーチャントシリコンスイッチIC。このプロセス微細化こそが、高出力800G光モジュールや8×100Gブレイクアウトを含め、ポート単位のアクティブ冷却なしにQSFP-DD800ケージあたり30 Wを実現可能にしました。

TSMC N5 · 30 W/ポート
03
世代間の飛躍
Tomahawk 4 → Tomahawk 5

ポート単位の速度2倍。容量2倍。同じ64ポートのradix。

TH4(25.6 Tbps · 64×400G · 7 nm)は、400G NICを中心に構築されたクラスタにとって依然として優れています。TH5は、ポートあたり800GとAIファブリックのプリミティブの両方が重要な場合にラックスペースに見合います。

Tomahawk 6:1.6Tで何が変わるか →

スイッチング容量
25.6 Tbps → 51.2 Tbps

同じラックフットプリントで2倍。同じ2RU、同じ電力エンベロープクラス。

ポートあたり速度
64 × 400G → 64 × 800G

IPI の実プラットフォームでも同じ 64 ポートのラディックス (AS9736-64D → AIS800-64D / S9321)。ポートあたり帯域が倍増するため、Clos 各ティアは 2 倍のトラフィックを収容します。

プロセスノード
7 nm → 5 nm

初の5nmマーチャントスイッチIC。アクティブ冷却なしで30 W/ポートに対応する熱的余裕。

レーンあたりSerDes
50G PAM4 → 100G PAM4

同じ512レーンで速度は2倍。スループットの倍増は既存インフラから実現。

ブラウンフィールド刷新もクリーンに維持。 同一のOcNOS-DCイメージがTH3、TH4、TH5の各プラットフォームで動作し、設定、自動化、gNMIパイプラインをそのまま継承します。次のクラスターにはTH5を採用し、TH4は既に稼働している箇所でそのまま活用ください。
04
OcNOS-DC の提供内容
このシリコン上のOcNOS-DC

キャリアグレードのNOS。AI最適化されたデフォルト設定。

Tomahawk 5はハードウェアを備えています。NOSの役割は、それをオペレーター、テレメトリパイプライン、クラスタスケジューラに対して、CLIの曲芸を強いることなく公開することです。OcNOS-DCは、これらのプリミティブをYANGモデル化された状態を持つ第一級の構成可能オブジェクトとして提供します。

共有バッファアーキテクチャ、ゼロドロップのイースト・ウエスト通信。

OcNOS-DC は PFC + ETS + Dynamic ECN を xCCL 集合通信パターン向けに事前チューニングして提供。コミュニティ NOS のファブリックを機能停止に追い込む AllReduce マイクロバースト下でもテールレイテンシは抑えられます。TH5 の共有バッファプールは、分割バッファチップではテールドロップする同期多対一トラフィックを吸収します。

DLBは64 µsでフローレットを再バインド。

エレファントフロー下でのECMPハッシュ衝突は、AIファブリックにとって致命的です。OcNOS-DCはTH5 Cognitive Routingのフローレット再バインドを有効化し、AllReduceトラフィックをすべてのスパインパスへ自動的に分散させます。

ポートごと、プライオリティごと。自動ドレイン。

トレーニングジョブをハングさせる前にpaused-queueサイクルを検知。オペレーターの介入なしに自動復旧します。

gNMI on-change, OpenConfig YANG.

バッファ深度、ECNマーク、PFCポーズ回数:各閾値がつまみとなり、各カウンタがセンサーパスとなる。Prometheus、Grafana、OTelに連携。

BGP · OSPF · IS-IS · EVPN-VXLAN.

TH5スパインは本物のルーターでもあります。同一シリコン上の完全なキャリアグレードのLayer 3スタック:AIファブリックをブラックボックスとしてではなく、ネットワーク全体の一部として運用可能。

8カテゴリにわたる215機能、最新のOcNOS Feature Matrixから抽出。

レイヤー 3 ルーティング · L1/L2 · AI ファブリックの基本機能 · マルチキャスト · QoS · セキュリティ · ハードウェア · 管理。すべての項目は公開マトリクスでプラットフォームごとに確認できます。

RoCEv2 / PFC DCQCN DLB EVPN-VXLAN SR-MPLS BGP / OSPF / IS-IS gNMI / NETCONF ZTP
Day-0 から Day-2

ZTP. gNMI on-change. NETCONF + YANG. DCBX.

ゼロタッチプロビジョニングでラック内のTH5スパインを立ち上げ。すべてのカウンターをオブザーバビリティスタックへストリーミング。YANGモデル化された設定であらゆるしきい値をチューニング。グルースクリプトは不要です。

ZTP IPv4/IPv6 gNMI NETCONF OpenConfig YANG DCBX LLDP Ansible Terraform プロバイダー
このスタックを構築する企業

3つのオペレータープロファイル。単一のシリコン + NOSの組み合わせ。

同一のTH5ダイ、同一のOcNOS-DCイメージで、同じアーキテクチャ上の問いを3通りに捉え直します。すなわち、スタック全体を単一ベンダーに固定することなく、いかにロスレスな東西通信をスケールさせるかという問いです。

オープンシリコン上で最大16k GPUの上限までトレーニングファブリックを拡張。

「リーフまでの800G、ロスレスRoCEv2、そしてAllReduce下でも破綻しないテールレイテンシが必要です。シングルベンダーロックインは論外です。」

TH5 64×800Gスパイン、xCCLチューニングされたDCQCNを備えたRoCEv2、サブミリ秒のDLBリバインディング、PFCデッドロックウォッチドッグ。TH4と同じ64ポートのradixながら各スパインポートが800Gを伝送し、同一の総ファブリック帯域幅に対してスパイン・リーフ間の配線量を半減。

DC・AI Fabric SKU

AI クラスタオペレータ

マルチテナントファブリック、BoM を抑制。

「お客様はGPUを選定する。当社のファブリックBoMを彼らのNIC選択に縛り付けることはできない。最低でも2ベンダーから購入できるスイッチが必要だ。」

2 社のベンダー(Edgecore、UfiSpace)による 3 つの OcNOS 検証済み TH5 SKU。VRF-Lite によるテナント分離、gNMI によるテナントごとのテレメトリ、EVPN-VXLAN によるセグメンテーション。1 つの NOS イメージで、マルチベンダーのハードウェアを運用します。

DC · マルチテナント

NeoCloud · GPU-as-a-Service

フォークリフト交換不要の TH3/TH4 ファブリック刷新。

「当社は本番環境でTH4ファブリックを運用しています。次のトレーニングクラスタには800G NICが必要です。シリコンをアップグレードするために、NOSレイヤ全体を再設計したくはありません。」

同一の OcNOS-DC イメージが TH3、TH4、TH5 プラットフォームで動作。ブラウンフィールドのリフレッシュでも設定、自動化、gNMI パイプラインをそのまま維持。

DC · TH3 から TH5

ハイパースケーラー・ブラウンフィールド刷新

よくあるご質問

アーキテクトからよくある質問

2社のODMにまたがる3つのオープンハードウェアプラットフォーム:Edgecore AIS800-64D(DCS560シャーシ)、UfiSpace S9321-64E(QSFP-DD)、S9321-64EO(OSFP)。3機種すべてがONIEプリロード済みで出荷され、同一のOcNOS-DCイメージを実行します。設定も、機能範囲も、自動化フックも同一です。2ベンダー体制により、ハイパースケールおよびNeoCloud調達においてデュアルソースのBoMが現実的になります。
QSFP-DD(AIS800-64DおよびS9321-64E)は大量流通する光モジュールのエコシステムであり、データセンター内の短距離800Gにおける適切なデフォルトです。OSFP(S9321-64EO)は、QSFP-DDでは収容できないモジュールクラス向けに高出力ケージを提供します:DCI向けの800G ZR/ZR+コヒーレント、より長距離のDR4/DR8、プラガブル増幅器などです。光モジュールがケージ選定を左右する場合はOSFPを、それ以外ではコストとエコシステムの広さでQSFP-DDを選択してください。
TH4は25.6 Tbps・64×400G・7 nm・50G PAM4。TH5は同じ64ポートのradixのまま、ポートあたり速度と総スイッチング容量を倍増する(51.2 Tbps・64×800G・5 nm・100G PAM4)。判断基準:クラスタが800Gポートをネイティブに必要とする場合、または各スパインポートが2倍の帯域を担う必要がある場合(同じ総ファブリックスループットに対しケーブルプラントを半減)はTH5を選択。設計が400G NICと単一podのフットプリントを中心に構築されているなら、TH4は依然として優れており、ポートあたりコストも安い。OcNOS-DCは同一の機能セットで両者をサポートするため、ブラウンフィールドの更改もクリーンに進められる。
Ultra Ethernet のエンドポイント動作(パケットスプレー、並べ替え、選択的再送)は UEC 対応 NIC 上で実行され、UEC 1.0 仕様はリンクとスイッチの動作もカバーしています。そのため UEC との適合性は、NIC、スイッチシリコン、NOS リリースによって決まります。現在 Tomahawk 5 上では、OcNOS-DC が PFC、ECN、DCQCN、ミリ秒未満の DLB によるロスレス RoCEv2 を本番環境で稼働させています。IP Infusion は Ultra Ethernet Consortium のメンバーです。特定の構成に UEC をどう組み込むかは、IP Infusion のエンジニアにご相談ください。
TH5上では、OcNOS-DCはAIファブリック向けに事前チューニングされた状態で提供されます:PFC over L3、ETS、Dynamic ECN、DLB Reactive-Path Rebalance、DLB Random-Flow、PFC Deadlock Detection & Recovery、xCCL準拠のバッファプロファイル、DCBX LLDP。同一シリコン上で、AI専用スタックでは通常カバーされない完全なキャリアグレードのLayer 3スタック(BGP、OSPF、IS-IS、SR-MPLS、EVPN-VXLAN)も動作します。8カテゴリーにわたり215機能を検証済みで、各項目は公開されているOcNOS Feature Matrixで確認可能です。
SPエッジ、セルサイトゲートウェイ、1 Tbps未満の集約。これらの役割では、64×800Gのradixはラックスペースに見合いません。SPルーティングではOcNOSはBroadcom Qumran(Q2C、Q2C+)とJericho(J2C+)を検証しています。シングルポッド構成の100G/400G DCリーフでは、Trident(TD3-X7、TD4)の方が経済性に優れます。800G radixとAIファブリックのプリミティブの両方が重要な場合はTH5が有利です。

Tomahawk 5ファブリックを設計中か。サイジングを一緒に行いましょう。

OcNOS のネットワークアーキテクトとの 30 分間のアーキテクチャセッション。GPU 数、NIC の速度、希望する層構成をお持ちいただければ、3 つの TH5 SKU すべてにわたるサイジング済みの BoM をお渡しします。