BCM78900 · TSMC 5 nm · En envío desde marzo de 2023

Broadcom Tomahawk 5 Switches Tomahawk 5 Tres plataformas abiertas de 800G, validadas en OcNOS-DC.

Edgecore AIS800-64D, UfiSpace S9321-64E y S9321-64EO: el mismo silicio, la misma imagen de OcNOS-DC, tres rutas de adquisición. Especificaciones, reglas de decisión y la superficie de funciones de OcNOS-DC para los ingenieros que eligen un switch Tomahawk 5.

51.2Tbps
Capacidad del switch
64×800G
Radix de puertos nativo
3SKUs
Validado por OcNOS
2ODMs
Edgecore · UfiSpace
5nm
Proceso TSMC N5
01
Los switches
Hardware abierto que ejecuta Tomahawk 5

Tres plataformas de 800G. Dos ODM. Una sola imagen OcNOS-DC.

Dos diseños de hardware, tres SKU. Los tres se entregan con ONIE precargado y ejecutan la misma imagen de OcNOS-DC. Las diferencias son el formato (QSFP-DD frente a OSFP), el posicionamiento (SKU para fabric de IA frente a SKU para centro de datos general) y el ecosistema de ópticas en torno al que se construye el despliegue. Cada tarjeta enlaza a la hoja de datos completa del fabricante (PDF, alojada localmente).

Edgecore· familia de plataformas DCS560
Spine de fabric de AI

AIS800-64D

Validado en OcNOS-DC · ONIE precargado
Puertos
64 × QSFP-DD800Breakout: 2×400 / 4×200 / 8×100 (320 puertos lógicos)
Formato
2RU
Alimentación
2× 3000 W AC/DC redundante30 W por jaula QSFP-DD
CPU
Intel Xeon D1713NTE
▌ Elija esto cuando

Fabric de IA para clúster de GPU. Chasis Edgecore DCS560 con el enfoque del SKU de fabric de IA.
UfiSpace· familia de plataformas S9321
Spine de fabric de AI

S9321-64E

Validado en OcNOS-DC · ONIE precargado
Puertos
64 × QSFP-DD (200/400/800G)Breakout: 2×400 / 4×200 / 8×100
Formato
2RU · 23.72 kg
Alimentación
913 W típicos (sin transceptores)30 W por jaula QSFP-DD
CPU
Intel Icelake-D de 4 núcleos · 32 GB DDR4
▌ Elija esto cuando

Flujos de IA voluminosos y de baja entropía. UfiSpace posiciona el 64E para el tráfico dominado por AllReduce, donde el enrutamiento adaptativo del TH5 constituye el núcleo del diseño.

UfiSpace· familia de plataformas S9321
DCI de 800G · óptica coherente

S9321-64EO

Validado en OcNOS-DC · ONIE precargado
Puertos
64 × OSFP (200/400/800G)Breakout: 2×400 / 4×200 / 8×100
Formato
2RU · 23.74 kg
Alimentación
925 W típicos · 200-240 V CAJaulas OSFP para ópticas de mayor potencia
CPU
Intel Icelake-D · 32 GB DDR4
▌ Elija esto cuando

800G ZR/ZR+ coherente u otras clases de módulos de mayor potencia. El factor de forma OSFP del 64E: elíjalo cuando las ópticas determinen la elección de la jaula.

· Cómo elegir entre los tres

AIS800 vs S9321-64EEl mismo silicio TH5, dos ODM. Edgecore DCS560 (AIS800-64D) vs UfiSpace S9321: BoM de doble fuente para el aprovisionamiento hyperscale y NeoCloud.
QSFP-DD vs OSFPQSFP-DD (S9321-64E y AIS800-64D) para el ecosistema de ópticas de gran volumen. OSFP (S9321-64EO) para clases de módulos de mayor potencia, incluido el coherente 800G ZR/ZR+.
Edgecore vs UfiSpaceAmbos son ODMs de hardware abierto con un sólido codiseño de IP Infusion. Elija según su relación con el ODM, la logística de RMA o la economía del BoM.
Riesgo de proveedor únicoDos proveedores con plataformas TH5 significa que una BoM de doble fuente es realista, algo importante para la adquisición de hyperscale y NeoCloud.
02
Dentro del silicio
Lo que le aportan 51,2 Tbps en un solo die

Tomahawk 5: el ASIC de switch merchant insignia de Broadcom.

El BCM78900 es un único die monolítico de 5 nm que ofrece 51.2 Tbps de capacidad de conmutación, alimentando 64 puertos de 800GbE, 128 de 400G o 256 de 200G de forma nativa. Fue el primer IC de conmutación merchant de 5 nm de Broadcom y el primer producto en cualquier lugar en admitir 800GbE en la jaula. 512 carriles SerDes a 100G PAM4: el mismo conteo de lanes que el Tomahawk 4, el doble de velocidad por lane.

Más allá de la capacidad bruta, tres decisiones arquitectónicas convirtieron al TH5 en el silicio bajo la mayoría de las redes de IA en producción: un arquitectura de búfer compartido que absorbe en hardware los micro-bursts de los colectivos xCCL (NCCL / RCCL / oneCCL) Enrutamiento cognitivo (DLB) que reasigna flujos elefante en el ASIC, y holgura térmica de 5 nm que permite operar jaulas QSFP-DD800 de 30 W sin refrigeración activa por puerto.

Especificaciones verificables frente a la documentación pública de Broadcom Página de producto BCM78900.

ProcesoTSMC N5 SerieStrataXGS BufferCompartido, optimizado para RDMA EnrutamientoCognitivo · DLB DisponibilidadDesde marzo de 2023
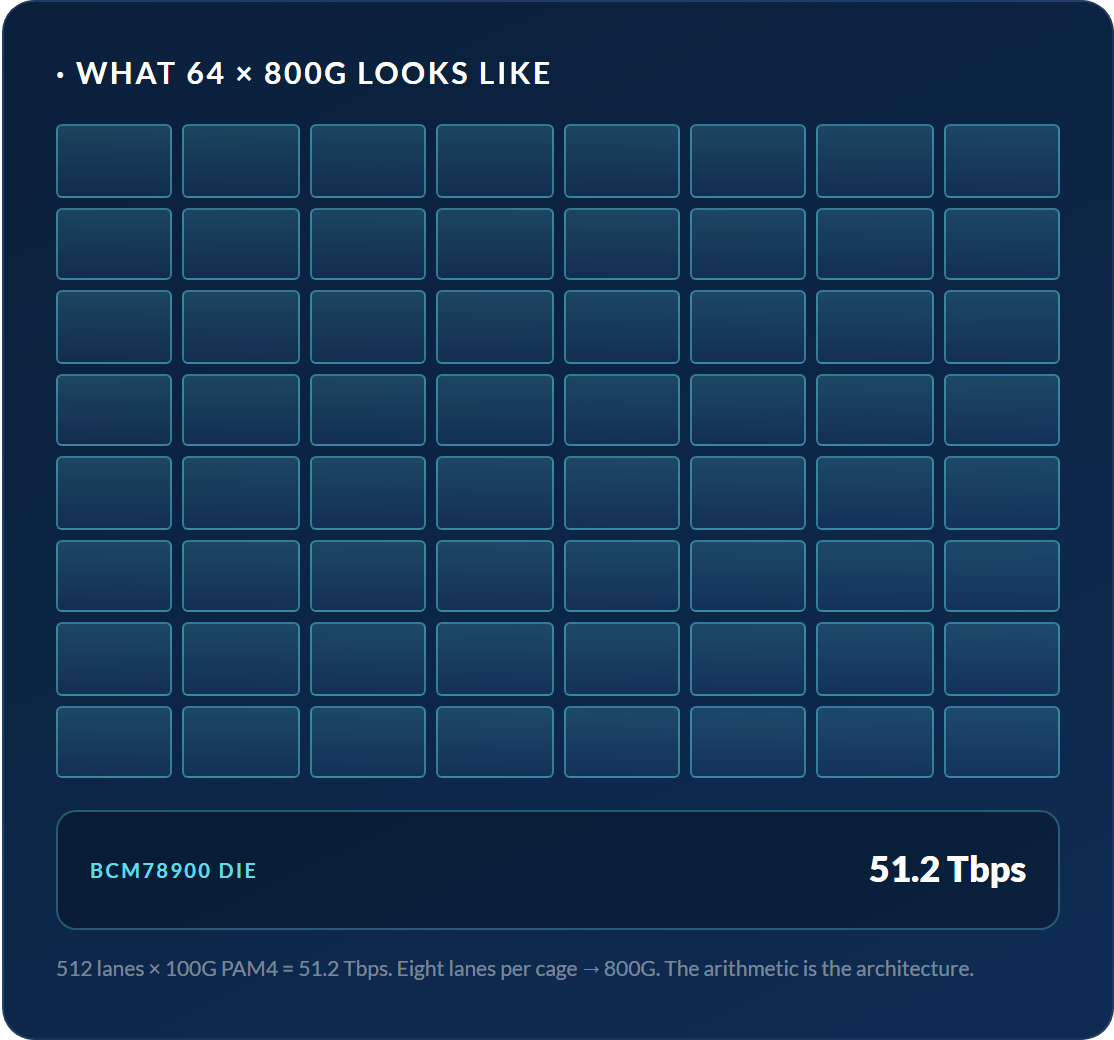
Radix de puertos del Broadcom Tomahawk 5 (BCM78900) representado como una cuadrícula de 64 puertos, cada uno 800G QSFP-DD, con un total de 51,2 Tbps de conmutación en un solo die
Cómo se ve 64 x 800G: 512 lanes de 100G PAM4 que suman 51,2 Tbps en el die BCM78900.
Cuatro decisiones de diseño que importan

Por qué el TH5 terminó en casi todos los AI fabric abiertos construidos desde 2024.

La cifra principal acapara la prensa. Estas cuatro decisiones de ingeniería son lo que realmente les importa a los arquitectos de fabric de IA.

PRINCIPIO 01

El mismo número de carriles, el doble de velocidad.

TH5 incorpora los mismos 512 carriles SerDes que TH4, ejecutándolos a 100G PAM4 en lugar de 50G. La duplicación del rendimiento provino de acelerar la infraestructura existente, no de añadirle más.

100G PAM4 · 106 Gbps
PRINCIPIO 02

Búfer compartido, no particionado.

Pools de memoria de paquetes compartidos en los 64 puertos, no divididos por puerto. Los micro-bursts xCCL AllReduce en un puerto se absorben en el pool global del fabric en lugar de provocar tail-drop. La razón en una línea por la que el TH5 gana en RoCEv2.

Búfer compartido · optimizado para RDMA
PRINCIPIO 03

Enrutamiento adaptativo por hardware.

El Cognitive Routing de Broadcom detecta las rutas congestionadas y revincula los flujos elefante en el ASIC: sin ida y vuelta al controlador, sin rehashing de ECMP. OcNOS-DC lo activa como DLB Reactive-Path Rebalance.

DLB · flowlet de 64 µs
PRINCIPIO 04

Margen térmico de 5 nm.

El primer IC de switch merchant de 5 nm. La reducción de proceso es lo que hizo factibles los 30 W por jaula QSFP-DD800 sin refrigeración activa por puerto, incluyendo óptica de 800G de alta potencia y breakout de 8×100G.

TSMC N5 · 30 W/puerto
03
Salto generacional
Tomahawk 4 → Tomahawk 5

Velocidad por puerto duplicada. Capacidad duplicada. El mismo radix de 64 puertos.

TH4 (25.6 Tbps · 64×400G · 7 nm) sigue siendo excelente para clústeres construidos en torno a NIC de 400G. TH5 justifica su espacio en el rack cuando importan tanto los 800G por puerto como las primitivas de AI-fabric.

Tomahawk 6: qué cambia a 1.6T →

Capacidad de conmutación
25,6 Tbps → 51,2 Tbps

El doble en la misma huella de rack. El mismo 2RU, la misma clase de envolvente de potencia.

Velocidad por puerto
64 × 400G → 64 × 800G

El mismo radix de 64 puertos en las plataformas IPI reales (AS9736-64D → AIS800-64D / S9321). El ancho de banda por puerto se duplica, por lo que cada nivel Clos transporta el doble de tráfico.

Nodo de proceso
7 nm → 5 nm

Primer IC de switch merchant de 5 nm. Margen térmico para 30 W/puerto sin refrigeración activa.

SerDes por carril
50G PAM4 → 100G PAM4

Las mismas 512 lanes, el doble de velocidad. La duplicación del throughput provino de la infraestructura existente.

La renovación del entorno existente se mantiene limpia. La misma imagen de OcNOS-DC se ejecuta en plataformas TH3, TH4 y TH5: las configuraciones, la automatización y las canalizaciones de gNMI se trasladan sin cambios. Elija TH5 para el próximo clúster; conserve TH4 donde ya funciona.
04
Qué incluye OcNOS-DC
OcNOS-DC en este silicio

NOS de nivel operador. Valores predeterminados ajustados para IA.

Tomahawk 5 tiene el hardware. La labor del NOS es exponerlo, a los operadores, a los pipelines de telemetría, al planificador del clúster, sin obligarlos a escribir malabarismos de CLI a su alrededor. OcNOS-DC ofrece estas primitivas como objetos configurables de primera clase con estado modelado en YANG.

Arquitectura de buffer compartido, este-oeste sin descartes.

OcNOS-DC entrega PFC + ETS + Dynamic ECN preajustados a los patrones colectivos xCCL. La latencia de cola se mantiene acotada bajo micro-bursts AllReduce que derriban a los fabrics de NOS comunitarios. El pool de buffer compartido del TH5 absorbe el tráfico sincronizado many-to-one que provocaría tail-drop en chips de buffer particionado.

DLB revincula los flowlets en 64 µs.

La colisión de hash de ECMP bajo flujos elefante es lo que destruye el fabric de IA. OcNOS-DC activa el rebinding de flowlets del Cognitive Routing de TH5 para que el tráfico de AllReduce se distribuya automáticamente por cada ruta de spine.

Por puerto, por prioridad. Purga automática.

Detecta los ciclos de cola en pausa antes de que bloqueen los trabajos de entrenamiento. Se recupera automáticamente sin intervención del operador.

gNMI on-change, OpenConfig YANG.

Profundidad de búfer, marcas ECN, conteos de pausa PFC: cada umbral es una perilla, cada contador una ruta de sensor. Se integra con Prometheus, Grafana, OTel.

BGP · OSPF · IS-IS · EVPN-VXLAN.

El spine TH5 también es un router real. Pila de Layer 3 de nivel operador completa sobre el mismo silicio: opere la fabric de IA como el resto de su red, no como una caja negra.

215 funciones en 8 categorías, extraídas de la OcNOS Feature Matrix en vivo.

Enrutamiento de capa 3 · L1/L2 · primitivas de fabric de IA · Multicast · QoS · Seguridad · Hardware · Gestión. Cada entrada se puede verificar por plataforma en la matriz pública.

RoCEv2 / PFC DCQCN DLB EVPN-VXLAN SR-MPLS BGP / OSPF / IS-IS gNMI / NETCONF ZTP
Del Día 0 al Día 2

ZTP. gNMI on-change. NETCONF + YANG. DCBX.

Ponga en marcha un spine TH5 en el rack con aprovisionamiento sin intervención. Transmita cada contador a su pila de observabilidad. Ajuste cada umbral mediante configuración modelada en YANG. Sin scripts de pegamento.

ZTP IPv4/IPv6 gNMI NETCONF OpenConfig YANG DCBX LLDP Ansible Proveedor de Terraform
Quién construye este stack

Tres perfiles de operador. Una combinación de silicio + NOS.

El mismo die TH5, la misma imagen de OcNOS-DC, tres enfoques distintos de la misma cuestión arquitectónica: ¿cómo escala el tráfico este-oeste sin pérdidas sin atar toda la pila a un único proveedor?

Fabric de entrenamiento hasta el techo de 16k GPU sobre silicio abierto.

"Necesitamos 800G hacia el leaf, RoCEv2 sin pérdidas y una latencia de cola que no se dispare bajo AllReduce. El bloqueo propietario de un solo proveedor no es una opción."

Spines TH5 de 64×800G, RoCEv2 con DCQCN ajustado para xCCL, rebinding DLB en submilisegundos, watchdog de deadlock PFC. La misma densidad de 64 puertos que el TH4, pero cada puerto de spine transporta 800G, lo que reduce a la mitad la planta de cableado spine-leaf para el mismo ancho de banda agregado de la fabric.

SKU de DC · AI Fabric

Operador de clúster de IA

Fabric multiinquilino, con la BoM bajo control.

"Nuestros clientes eligen la GPU. No podemos atar el BoM de nuestro fabric a su elección de NIC. Necesitamos un switch que podamos comprar de al menos dos proveedores."

Tres SKU TH5 validados por OcNOS de dos fabricantes (Edgecore, UfiSpace). Aislamiento de tenants con VRF-Lite, telemetría gNMI por tenant, segmentación EVPN-VXLAN. Una sola imagen de NOS, hardware multifabricante.

DC · Multiinquilino

NeoCloud · GPU como servicio

Renovación del fabric TH3/TH4 sin recambio total.

"Tenemos un fabric TH4 en producción. El próximo clúster de entrenamiento necesita NICs de 800G. No queremos rediseñar toda la capa del NOS para actualizar el silicio."

La misma imagen de OcNOS-DC se ejecuta en plataformas TH3, TH4 y TH5. Una renovación brownfield mantiene intactas las configuraciones, la automatización y los pipelines de gNMI.

DC · TH3 a TH5

Hyperscaler · Renovación de entorno existente

Preguntas frecuentes

Preguntas que hacen los arquitectos

Tres plataformas de hardware abierto en dos ODM: Edgecore AIS800-64D (chasis DCS560) y UfiSpace S9321-64E (QSFP-DD) y S9321-64EO (OSFP). Las tres se entregan con ONIE precargado y ejecutan la misma imagen de OcNOS-DC: la misma configuración, la misma superficie de funciones, los mismos puntos de enganche de automatización. Dos proveedores significan que una BoM de doble fuente es realista para la adquisición de hyperscale y NeoCloud.
QSFP-DD (AIS800-64D y S9321-64E) es el ecosistema óptico de alto volumen, la opción predeterminada adecuada para 800G de corto alcance dentro del centro de datos. OSFP (S9321-64EO) proporciona jaulas de mayor potencia para clases de módulo que QSFP-DD no puede alojar: óptica coherente 800G ZR/ZR+ para DCI, mayor alcance DR4/DR8 y amplificadores enchufables. Elija OSFP cuando la óptica determine la elección de la jaula; de lo contrario, QSFP-DD gana en costo y amplitud de ecosistema.
TH4 es de 25.6 Tbps · 64×400G · 7 nm · 50G PAM4. TH5 duplica la velocidad por puerto y la capacidad total de conmutación con el mismo radix de 64 puertos (51.2 Tbps · 64×800G · 5 nm · 100G PAM4). Regla de decisión: si el clúster necesita puertos de 800G de forma nativa, o si cada puerto de spine debe transportar el doble de ancho de banda (reduciendo a la mitad la planta de cableado para el mismo rendimiento agregado del fabric), elija TH5. Si el diseño está construido en torno a NICs de 400G y una huella de un solo pod, TH4 sigue siendo excelente y más económico por puerto. OcNOS-DC admite ambos con el mismo conjunto de funciones: la actualización de entornos existentes se mantiene limpia.
El comportamiento de extremo de Ultra Ethernet (packet spray, reordenación, retransmisión selectiva) se ejecuta en NIC compatibles con UEC, y la especificación UEC 1.0 también cubre el comportamiento del enlace y del switch, por lo que el encaje de UEC depende de la NIC, el silicio del switch y la versión del NOS. En Tomahawk 5, OcNOS-DC ya ejecuta en producción RoCEv2 sin pérdidas con PFC, ECN, DCQCN y DLB por debajo del milisegundo. IP Infusion es miembro del Ultra Ethernet Consortium. Para planificar cómo encaja UEC en un diseño concreto, hable con un ingeniero de IP Infusion.
En TH5, OcNOS-DC se entrega preajustado para fabrics de AI: PFC sobre L3, ETS, ECN dinámico, DLB Reactive-Path Rebalance, DLB Random-Flow, detección y recuperación de bloqueo mutuo de PFC, perfiles de buffer alineados con xCCL, DCBX LLDP. Sobre el mismo silicio también ejecuta una pila de Capa 3 de nivel operador completa (BGP, OSPF, IS-IS, SR-MPLS, EVPN-VXLAN) que las pilas exclusivas para AI normalmente no cubren. 215 funciones validadas en 8 categorías, cada entrada verificable en el OcNOS Feature Matrix público.
Borde de SP, gateway de sitio celular, agregación por debajo de 1 Tbps. En esos roles, el radix de 64×800G no justifica su espacio en el rack. Para enrutamiento de SP, OcNOS valida Broadcom Qumran (Q2C, Q2C+) y Jericho (J2C+); para leaf de DC 100G/400G en despliegues de un solo pod, Trident (TD3-X7, TD4) ofrece mejor economía. TH5 gana cuando importan tanto el radix de 800G como las primitivas de AI-fabric.

¿Diseñando un fabric Tomahawk 5? Dimensionémoslo juntos.

Sesión de arquitectura de 30 minutos con un arquitecto de red de OcNOS. Traiga su número de GPU, la velocidad de sus NIC y su preferencia de niveles, y llévese una lista de materiales dimensionada para los tres SKU TH5.