BCM78900 · TSMC 5 nm · 自 2023 年 3 月起出貨

Broadcom Tomahawk 5 Tomahawk 5 交換機 三款 800G 開放平台,已在 OcNOS-DC 上完成驗證。

Edgecore AIS800-64D、UfiSpace S9321-64E 和 S9321-64EO:相同的晶片、相同的 OcNOS-DC 鏡像、三條採購路徑。為正在挑選 Tomahawk 5 交換機的工程師提供規格、決策規則以及 OcNOS-DC 特性面。

51.2Tbps
交換容量
64×800G
原生埠密度
3SKUs
OcNOS 已驗證
2ODMs
Edgecore · UfiSpace
5nm
TSMC N5 工藝
01
交換機

三款 800G 平台。兩家 ODM。同一套 OcNOS-DC 鏡像。

兩種硬體設計,三個 SKU。三款產品出廠均預裝 ONIE,並執行同一個 OcNOS-DC 鏡像。區別在於外形規格(QSFP-DD 與 OSFP)、品牌定位(AI 網路 SKU 與通用資料中心 SKU),以及部署所依託的光模組生態。每張卡片都連結到廠商完整資料手冊(PDF,本站託管)。

Edgecore· DCS560 平台家族
AI fabric 骨幹層

AIS800-64D

經 OcNOS-DC 驗證 · 預裝 ONIE
埠
64 × QSFP-DD800拆分:2×400 / 4×200 / 8×100(320 個邏輯埠)
外形
2RU
電源
2× 3000 W AC/DC 冗餘每個 QSFP-DD 埠 30 W
CPU
Intel Xeon D1713NTE
▌ 適用場景

GPU 叢集 AI fabric。採用 AI-fabric SKU 定位的 Edgecore DCS560 機箱。
UfiSpace· S9321 平台系列
AI fabric 骨幹層

S9321-64E

經 OcNOS-DC 驗證 · 預裝 ONIE
埠
64 × QSFP-DD (200/400/800G)拆分:2×400 / 4×200 / 8×100
外形
2RU · 23.72 kg
電源
典型 913 W(不含光模組)每個 QSFP-DD 埠 30 W
CPU
Intel Icelake-D 4 核 · 32 GB DDR4
▌ 適用場景

大規模、低熵的AI流量。UfiSpace將64E定位用於以AllReduce為主的流量,其中TH5自適應路由是設計的核心。

UfiSpace· S9321 平台系列
800G DCI · 相干光模組

S9321-64EO

經 OcNOS-DC 驗證 · 預裝 ONIE
埠
64 × OSFP (200/400/800G)拆分:2×400 / 4×200 / 8×100
外形
2RU · 23.74 kg
電源
典型 925 W · 200-240 V AC用於更高功率光模組的 OSFP 籠
CPU
Intel Icelake-D · 32 GB DDR4
▌ 適用場景

更高功率模組類別。64E 採用 OSFP 形態:當光模組決定籠位選擇時即可選用。

· 如何在三款產品中選擇

AIS800 與 S9321-64E 對比同款 TH5 晶片,雙 ODM 來源。Edgecore DCS560 (AIS800-64D) 與 UfiSpace S9321:適用於超大規模與 NeoCloud 採購的雙源 BoM。
QSFP-DD vs OSFPQSFP-DD(S9321-64E 和 AIS800-64D)適用於大批量供應的光模組生態。OSFP(S9321-64EO)適用於更高功率的模組等級。
Edgecore vs UfiSpace兩者均為與 IP Infusion 深度協同設計的開放硬體 ODM。可依據您的 ODM 合作關係、RMA 物流或 BoM 經濟性進行選擇。
單一廠商風險兩家廠商均提供 TH5 平台,意味著雙源 BoM 切實可行,這對超大規模和 NeoCloud 採購至關重要。
02
深入晶片內部

Tomahawk 5:Broadcom 的旗艦通用交換 ASIC。

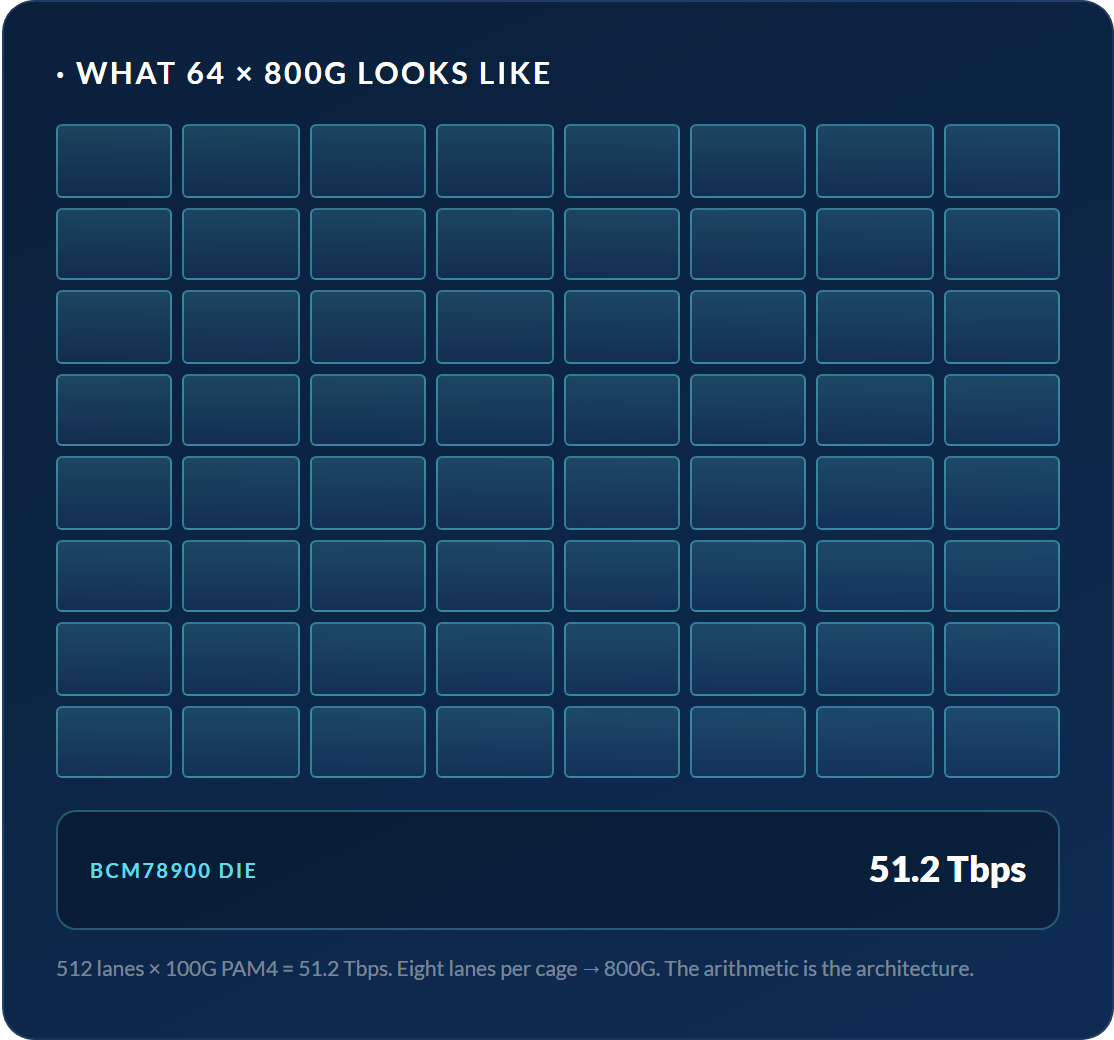
BCM78900 是一顆 5 nm 單片裸片,提供 51.2 Tbps 的交換容量,可原生支持 64 個 800GbE 埠、128 個 400G 埠或 256 個 200G 埠。它是 Broadcom 首款 5 nm 通用交換 IC,也是業界首款在籠位上支持 800GbE 的產品。 512 條 SerDes 通道,以 100G PAM4 運行:與 Tomahawk 4 相同的通道數量,每通道速率翻倍。

除了原始容量之外,還有三項架構選擇使 TH5 成為大多數生產級 AI 組網底層所採用的晶片: 共享緩衝架構 在硬體層吸收 xCCL (NCCL / RCCL / oneCCL) 集體通信微突發 認知路由 (DLB)可在 ASIC 中重新綁定大象流,配合 5 nm 的散熱餘量,使 30 W 的 QSFP-DD800 籠位無需逐埠主動散熱即可運行。

規格可對照 Broadcom 公開資料進行驗證 BCM78900 產品頁面.

工藝TSMC N5 系列StrataXGS 緩存共享、RDMA 調優 路由認知式 · DLB 出貨自 2023 年 3 月起
Broadcom Tomahawk 5 (BCM78900) 的連接埠基數,以 64 個連接埠的網格呈現,每個連接埠為 800G QSFP-DD,在單一晶片上提供總計 51.2 Tbps 的交換能力
64 x 800G 的樣貌:512 條 100G PAM4 通道,在 BCM78900 晶片上提供總計 51.2 Tbps。

為何自 2024 年以來幾乎每一個開放 AI fabric 都用上了 TH5。

奪人眼球的指標數字會登上新聞頭條。但這四項工程選擇,才是 AI fabric 架構師真正關心的。

原則 01

通道數相同,速率翻倍。

TH5 與 TH4 一樣配備 512 條 SerDes 通道,但以 100G PAM4 而非 50G 運行。吞吐量翻倍源於既有基礎設施的提速,而非額外增加通道。

100G PAM4 · 106 Gbps
原則 02

共享緩存,而非分區。

全部 64 個埠共享的報文記憶體池、而非按埠劃分。某一埠上的 xCCL AllReduce 微突發會被吸收進全局 fabric 池,而不會觸發 tail-drop。這就是 TH5 在 RoCEv2 上勝出的關鍵所在。

共享緩衝 · RDMA 調優
原則 03

硬體自適應路由。

Broadcom Cognitive Routing 在 ASIC 內檢測擁塞路徑並重綁定大象流:無需控制器往返,也無需 ECMP 重新哈希。OcNOS-DC 以 DLB Reactive-Path Rebalance 形式將其開啟。

DLB · 64 µs 流片(flowlet)
原則 04

5 nm 散熱裕量。

首款 5 nm 通用交換晶片。正是這一製程縮減,使每個 QSFP-DD800 籠位 30 W 的功耗在無需逐埠主動散熱的情況下成為可能,包括高功率 800G 光模組和 8×100G breakout。

TSMC N5 · 每埠 30 W
03
代際跨越

單埠速率翻倍。容量翻倍。同樣的 64 埠規模。

TH4(25.6 Tbps · 64×400G · 7 nm)對於圍繞 400G 網卡建構的叢集仍然表現出色。當每埠 800G 與 AI 網路原語都重要時,TH5 才對得起它的機架空間。

Tomahawk 6:1.6T 帶來的變化 →

交換容量
25.6 Tbps → 51.2 Tbps

在相同機架佔用下容量翻倍。相同的 2RU,相同的功耗等級。

逐埠速率
64 × 400G → 64 × 800G

在 IPI 實際平台上保持相同的 64-port radix (AS9736-64D → AIS800-64D / S9321)。每埠頻寬翻倍,因此每個 Clos 層承載的流量也翻倍。

製程節點
7 nm → 5 nm

首款 5 nm 通用交換晶片。具備 30 W/埠的熱餘量,無需主動散熱。

每通道 SerDes
50G PAM4 → 100G PAM4

同樣的 512 條通道,速率翻倍。吞吐量的翻番源自現有基礎設施。

棕地改造保持簡潔。 同一份 OcNOS-DC 鏡像可運行於 TH3、TH4 和 TH5 平台:配置、自動化和 gNMI 流水線均可沿用。新叢集可選 TH5;現有可用的 TH4 則繼續保留。
04
OcNOS-DC 交付內容

電信等級 NOS。適用於 AI 調優的預設配置。

Tomahawk 5 具備硬體能力。NOS 的職責是將其暴露給維運人員、遙測管線和叢集調度器,而無需他們圍繞它編寫繁複的 CLI 操作。OcNOS-DC 將這些原語作為一等的可配置對象交付,並以 YANG 建模其狀態。

共享緩衝架構,零丟包東西向流量。

OcNOS-DC 出廠即提供針對 xCCL 集體通信模式預調優的 PFC + ETS + Dynamic ECN。在足以拖垮社區版 NOS fabric 的 AllReduce 微突發下,尾時延仍保持有界。TH5 的共享緩衝池吸收在分區緩衝晶片上會發生 tail-drop 的同步多對一流量。

DLB 在 64 µs 內重新綁定 flowlet。

大象流下的 ECMP 哈希衝突是 AI 網路的致命問題。OcNOS-DC 開啟 TH5 Cognitive Routing 的 flowlet 重綁定,使 AllReduce 流量自動分散到每條 spine 路徑上。

逐埠、逐優先級。自動排空。

在暫停隊列周期掛起訓練任務之前即可檢測到。無需維運人員介入即可自動恢復。

gNMI on-change, OpenConfig YANG.

緩存深度、ECN 標記、PFC 暫停計數:每個閾值都是一個旋鈕,每個計數器都是一條傳感器路徑。可對接 Prometheus、Grafana、OTel。

BGP · OSPF · IS-IS · EVPN-VXLAN.

TH5 spine 同時也是一臺真正的路由器。在同一款晶片上運行完整的電信等級三層棧:像運維網路其餘部分一樣運維 AI fabric,而非把它當作黑盒。

涵蓋 8 個類別的 215 項功能,取自實時的 OcNOS Feature Matrix。

三層路由 · L1/L2 · AI 網路基礎能力 · 組播 · QoS · 安全 · 硬體 · 管理。每一項都可以在公開矩陣中按平台核實。

RoCEv2 / PFC DCQCN DLB EVPN-VXLAN SR-MPLS BGP / OSPF / IS-IS gNMI / NETCONF ZTP
Day-0 至 Day-2

ZTP. gNMI on-change. NETCONF + YANG. DCBX.

通過零接觸部署在機架中啟用一臺 TH5 spine。將每個計數器流式輸出至您的可觀測性棧。通過 YANG 建模的配置調整每個閾值。無需任何粘合腳本。

ZTP IPv4/IPv6 gNMI NETCONF OpenConfig YANG DCBX LLDP Ansible Terraform 提供者

三類電信業者畫像。一套晶片 + NOS 組合。

相同的 TH5 裸片、相同的 OcNOS-DC 鏡像,對同一架構問題給出三種不同的詮釋:如何在不將整個技術棧鎖定於單一廠商的前提下,擴展無損東西向流量?

在通用晶片上支持高達 16k-GPU 上限的訓練網路。

「我們需要 800G 直連葉節點、無損 RoCEv2,以及在 AllReduce 下不會失控的尾部時延。單一廠商鎖定不在考慮範圍內。」

TH5 64×800G spine,搭配經 xCCL 調優的 DCQCN 的 RoCEv2、亞毫秒級 DLB 重綁定、PFC 死鎖看門狗。與 TH4 相同的 64 埠基數,但每個 spine 埠承載 800G,在同等聚合 fabric 頻寬下將 spine-leaf 布線量減半。

DC · AI 網路 SKU

AI 叢集電信業者

多租戶 fabric,BoM 成本可控。

「客戶自行選擇 GPU。我們無法把織構 BoM 綁定到他們的 NIC 選型上。我們需要一款至少能從兩家廠商採購的交換機。」

來自兩家廠商(Edgecore、UfiSpace)的三款經 OcNOS 驗證的 TH5 SKU。VRF-Lite 租戶隔離、gNMI 按租戶遙測、EVPN-VXLAN 分段。一個 NOS 鏡像,多廠商硬體。

DC · 多租戶

NeoCloud · GPU 即服務

TH3/TH4 fabric 升級換代,無需整機更換。

"我們已有一套 TH4 網路結構投入生產。下一個訓練叢集需要 800G 網卡。我們不想為了升級晶片而重新設計整個 NOS 層。"

同一套 OcNOS-DC 映像檔執行於 TH3、TH4 和 TH5 平台上。棕地改造可完整保留配置、自動化與 gNMI 管線。

DC · TH3 至 TH5

超大規模資料中心 · 棕地改造

架構師會問的問題

橫跨兩家 ODM 的三款開放硬體平台:Edgecore AIS800-64D(DCS560 機箱)、UfiSpace S9321-64E(QSFP-DD)和 S9321-64EO(OSFP)。三者均預裝 ONIE 出廠,並運行同一套 OcNOS-DC 鏡像:相同的配置、相同的功能面、相同的自動化掛鈎。兩家供應商意味著雙源 BoM 對超大規模和 NeoCloud 採購而言切實可行。
QSFP-DD(AIS800-64D 和 S9321-64E)是大規模量產的光模組生態,是資料中心內部短距 800G 的恰當預設選擇。OSFP(S9321-64EO)則提供更高功率的籠體,可容納 QSFP-DD 無法承載的模組類型:例如更長距離的 DR4/DR8,以及可插拔放大器。當光模組決定了籠體選擇時,請選 OSFP;否則在成本和生態廣度上 QSFP-DD 更勝一籌。
TH4 為 25.6 Tbps · 64×400G · 7 nm · 50G PAM4。TH5 在相同 64 埠基數下將單埠速率和總交換容量翻倍(51.2 Tbps · 64×800G · 5 nm · 100G PAM4)。決策準則:如果叢集需要原生 800G 埠,或每個 spine 埠需要承載兩倍頻寬(在相同 fabric 總吞吐下將布線規模減半),則選用 TH5。如果設計圍繞 400G NIC 和單 pod 規模構建,TH4 仍然非常出色且單埠成本更低。OcNOS-DC 以相同的功能集同時支持二者:存量網路(brownfield)升級保持簡潔。
Ultra Ethernet 的端點行為(封包噴灑、重排序、選擇性重傳)執行於支援 UEC 的 NIC 上,而 UEC 1.0 規範也涵蓋鏈路與交換器行為,因此 UEC 是否適配取決於 NIC、交換晶片和 NOS 版本。如今在 Tomahawk 5 上,OcNOS-DC 已在生產環境中執行基於 PFC、ECN、DCQCN 和亞毫秒級 DLB 的無損 RoCEv2。IP Infusion 是 Ultra Ethernet Consortium 的成員。如需規劃 UEC 在具體部署中的定位,請諮詢 IP Infusion 工程師。
在 TH5 上,OcNOS-DC 針對 AI 架構出廠即完成預調優:PFC over L3、ETS、Dynamic ECN、DLB Reactive-Path Rebalance、DLB Random-Flow、PFC Deadlock Detection & Recovery、與 xCCL 對齊的緩衝配置檔案、DCBX LLDP。在同一晶片上,它還運行一套完整的電信等級 Layer 3 協議棧(BGP、OSPF、IS-IS、SR-MPLS、EVPN-VXLAN),這是純 AI 協議棧通常無法覆蓋的。215 項功能跨 8 個類別完成驗證,每一項均可在公開的 OcNOS Feature Matrix 上查證。
SP 邊緣、蜂巢基地台閘道、1 Tbps 以下的匯聚。在這些角色中,64×800G 的埠密度不足以體現其機架空間價值。對於 SP 路由,OcNOS 驗證了 Broadcom Qumran(Q2C、Q2C+)與 Jericho(J2C+);對於單 pod 環境下的 100G/400G DC 葉交換器,Trident(TD3-X7、TD4)經濟性更優。當 800G 埠密度與 AI 網路原語都重要時,TH5 勝出。

正在設計 Tomahawk 5 fabric?讓我們一起為它定型。

與 OcNOS 網路架構師進行 30 分鐘的架構溝通。帶上您的 GPU 數量、NIC 速率和層級偏好,即可獲得覆蓋三款 TH5 SKU 的規格化物料清單。