Global Load Balancing: Fabric-weite Pfadwahl
DLB trifft die richtige Entscheidung an einem Hop; GLB trifft die richtige Entscheidung über die gesamte Fabric hinweg. Global Load Balancing kommt mit OcNOS 7.1 und erweitert Load Balancing von einer Sicht pro Port auf die durchgängige Pfadqualität. Damit schließt es die Multi-Hop-Hotspot-Lücke in dreistufigen AI-Fabrics bis zur Obergrenze von 16.384 GPUs.
Bewertung des gesamten Pfads, nicht nur des lokalen Hops
Ein dreistufiger Ausschnitt (Leaf, Spine, Super-Spine), der GPU-AllReduce trägt. GLB wählt den Pfad mit der besten durchgängigen Bewertung, nicht mit der besten lokalen Egress-Bewertung, sodass ein freier Uplink, der auf einem überlasteten Downlink landet, nicht mehr blind gewählt wird.
DLB und GLB, nach Reichweite der Pfadentscheidung
DLB bewertet jeden ECMP-Next-Hop anhand der lokalen Egress-Queue-Tiefe, was auf einem zweistufigen Leaf-Spine optimal ist. Skalieren Sie auf ein dreistufiges Clos, können Sie einen Spine mit freiem Uplink wählen und dann auf einem Super-Spine landen, dessen Downlink zurück zum Egress-Leaf überlastet ist. Die lokale Sicht ist korrekt; die durchgängige Sicht ist falsch.
| Kriterium | DLBlokal, heute verfügbar | GLBglobal, OcNOS 7.1 |
|---|---|---|
| Reichweite der Entscheidung | Per-Hop: Jeder Switch bewertet seine eigenen ECMP-Next-Hops. | Durchgängig: Ingress-Leaves bewerten vollständige Leaf-zu-Leaf-Pfade. |
| Verwendetes Signal | Lokale Egress-Queue-Tiefe und Link-Auslastung auf diesem Switch. | Überlastungs-Telemetrie, aggregiert aus jeder Ebene, zurück zum Ingress. |
| Beste Passung | Zweistufige Leaf-Spine-Fabrics und der Leaf-zu-Spine-Hop in einer dreistufigen Fabric. | Dreistufige Fabrics mit Super-Spines, bis zur Obergrenze von 16.384 GPUs. |
| Erkannter Hotspot | Nur lokale Egress-Überlastung. | Downstream-Hotspots, die der lokale Hop nicht sehen kann. |
| Neuzuordnung | Flowlet-ausgerichtet, In-Order für RoCEv2 und TCP. | Flowlet-ausgerichtet, dieselbe In-Order-Garantie, Eingabe über die gesamte Fabric. |
Wie die GLB-Implementierung zusammenpasst
GLB wird durch OcNOS als Netzwerkbetriebssystem auf offener Broadcom-basierter Hardware ermöglicht.
Bis zur Obergrenze von 16k GPU
An der Obergrenze von 16.384 GPUs nutzt eine dreistufige Fabric aus 64x800G Tomahawk 5 Switches mit einer Cross-Pod-Ebene von ~2:1 etwa 512 Leaves, 384 Spines und 128 Super-Spines, eine Schätzung aus der Clos-Port-Rechnung; die genauen Anzahlen je Design, mit einem Ingenieur von IP Infusion.
Was Sie erwartet, wenn Sie GLB einführen
GLB kommt mit OcNOS 7.1. Kontaktieren Sie IP Infusion zu unterstützten Plattformen und Lizenzierung.
- Kommt mit OcNOS 7.1. Release-Lebenszyklus und Support-Zeiträume unter OcNOS-Releases-Seite.
- Architektur-Review verfügbar. Wenn Sie eine Fabric mit mehr als 1.000 GPUs dimensionieren, führen wir eine Sizing-Analyse durch, die die GLB-Telemetrie-Ebene einbezieht. Erhalten Sie einen ersten Leaf-Spine-Entwurf mit der AI Fabric Design Suite.
DLB legt die Basis, GLB hebt die Obergrenze
Dynamisches Load Balancing reduziert bereits die Tail-Latency im zweistufigen Maßstab. GLB, das mit OcNOS 7.1 kommt, überträgt dieselbe Disziplin auf die dreistufigen Fabrics, in denen die größten Cluster laufen.
DLB löst den Regelfall
Auf zweistufiger Leaf-Spine und beim Leaf-zu-Spine-Hop beseitigt lokales dynamisches Load Balancing bereits die meisten ECMP-Kollisionen. Das ist heute auf TH4 und TH5 verfügbar.
GLB löst den Skalierungsfall
GLB, das mit OcNOS 7.1 kommt, bewertet vollständige Pfade, sodass das Ingress-Leaf nicht länger einem sauberen Uplink in einen überlasteten Downlink folgt.
Global Load Balancing, erklärt
Worin unterscheidet sich GLB von DLB?
Wann ist GLB verfügbar?
Wie große Fabrics unterstützt GLB?
Tiefer einsteigen. Zum Mitnehmen.
Das Produktdatenblatt und kurze, technische Downloads, die über diese Seite hinausgehen.
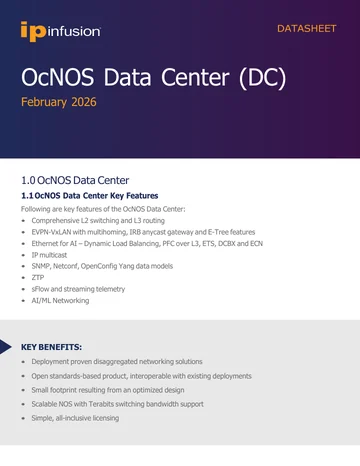
OcNOS-DC-Datenblatt
Vollständige OcNOS-DC-Spezifikation: Funktionsumfang für EVPN-VXLAN und Ethernet for AI, Software-SKUs, unterstützte Hardware-Plattformen und der Solution Ordering Guide.
Datenblatt abrufen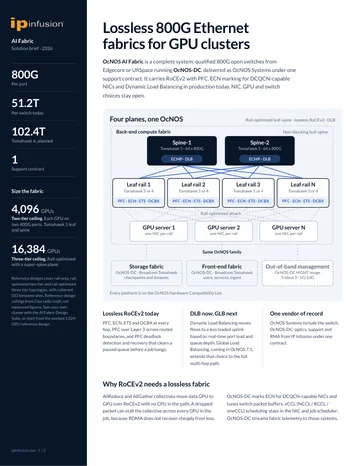
OcNOS: verlustfreie 800G-AI-Fabric
Verlustfreie RoCEv2-Fabric auf Tomahawk-5-Spines: SKU-Stufen, qualifizierte Plattformen und Deployment-Architektur.
Brief anfordern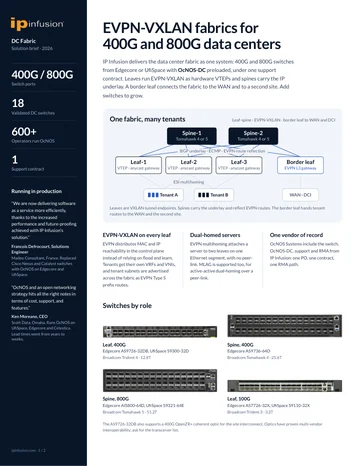
EVPN-VXLAN-Data-Center-Fabric
Leaf-Spine-Rechenzentrums-Fabric auf EVPN-VXLAN: eine VRF und VNIs pro Mandant, EVPN-Multihoming, BGP unnumbered und Route-Target-Filterung.
Brief anfordernOcNOS-DC-Datenblatt
Kurzes Formular. Ihr PDF öffnet sich unmittelbar nach dem Absenden in einem neuen Tab.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
OcNOS: verlustfreie 800G-AI-Fabric
Kurzes Formular. Ihr PDF öffnet sich unmittelbar nach dem Absenden in einem neuen Tab.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
EVPN-VXLAN-Data-Center-Fabric
Kurzes Formular. Ihr PDF öffnet sich unmittelbar nach dem Absenden in einem neuen Tab.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
Die gesamte AI-Fabric mit OcNOS entwerfen
Vom Business Case bis zur Portanzahl-Berechnung: Steigen Sie dort ein, wo Sie beim Aufbau gerade stehen.
Sie dimensionieren eine Fabric mit mehreren Tausend GPUs? Lassen Sie uns die Zahlen gemeinsam durchrechnen
Nennen Sie uns den Workload und die GPU-Größenordnung, und ein IP Infusion Engineer dimensioniert gemeinsam mit Ihnen die GLB-Telemetrie-Ebene, oder beginnen Sie mit einem ersten Leaf-Spine-Entwurf in der AI Fabric Design Suite.