Was ist ein AI-Networking-Switch?
Ein AI-Networking-Switch ist ein Data-Center-Ethernet-Switch mit hohem Radix, meist 400G oder 800G pro Port, der GPU-Server in der AI-Back-End-Fabric verbindet und RDMA-Verkehr mit PFC, ECN und dynamischem Load Balancing verlustfrei hält, weil der langsamste Flow bestimmt, wie lange ein Trainingsjob dauert. IP Infusion entwickelt OcNOS-DC, das Netzwerkbetriebssystem für diese Switches, und liefert es als komplette, validierte Systeme auf 51,2-Tbit/s-Plattformen mit Broadcom Tomahawk 5 sowie auf 25,6- und 12,8-Tbit/s-Plattformen.
Was einen Data-Center-Switch zum AI-Switch macht
Ein Switch verdient die Bezeichnung AI, wenn er GPU-Verkehr mit der Geschwindigkeit, Skalierung und Verlustrate transportiert, die ein Trainingscluster braucht. Fünf Eigenschaften unterscheiden ihn. Das Netz, das diese Switches bilden, wird behandelt in Was ist eine AI-Fabric; diese Seite behandelt den Switch selbst.
- Portgeschwindigkeit und Kapazität. GPU-NICs werden mit 400G und 800G angebunden, und der Switch-Port muss dazu passen. Ein 51,2-Tbit/s-Switch bietet 64 Ports mit 800G; ein 25,6-Tbit/s-Switch bietet 64 Ports mit 400G.
- Radix. Die Anzahl der Ports pro Switch bestimmt, wie viele GPUs ein Leaf bedienen und wie viele Leaves ein Spine verbinden kann, und damit, wie viele Stufen die Fabric braucht. Weniger Stufen bedeuten weniger Hops, weniger Optiken und weniger Strom.
- Verlustfreier Transport. GPUs tauschen Daten über RDMA over Converged Ethernet (RoCEv2) aus, das bei Paketverlusten stark einbricht. Der Switch braucht Priority Flow Control (PFC), um eine Queue vor dem Überlaufen anzuhalten, und Explicit Congestion Notification (ECN), um Sender frühzeitig zu warnen, im Zusammenspiel mit DCQCN als Congestion Control auf der NIC.
- Gleichmäßige Last. Kollektive Operationen wie AllReduce erzeugen wenige sehr große Flows. Statisches Hashing kann zwei davon auf einen Link legen, während ein anderer Link ungenutzt bleibt. Dynamisches Load Balancing verlagert Verkehr auf weniger ausgelastete Pfade.
- Transparenz. Streaming-Telemetrie meldet Queue-Tiefe, PFC-Pausen und ECN-Markierungen in Echtzeit, sodass Betreiber den einen Link finden, der einen Job verlangsamt.
Wo AI-Switches in einer AI-Netzwerk-Fabric eingesetzt werden
Ein AI-Rechenzentrum betreibt vier Netze nebeneinander, und jedes stellt andere Anforderungen an seine Switches. Die GPU-Back-End-Fabric ist das, was die meisten mit einem AI-Switch meinen.
GPU-Back-End-Fabric
Verbindet GPU-NICs über Server hinweg für Training und Inferenz. Aufgebaut aus rail-optimierten Leaves und einem Clos-Spine mit 400G oder 800G und durchgängig verlustfrei betrieben. Hier zählen Portgeschwindigkeit und Radix am meisten.
Storage-Fabric
Liefert Trainingsdaten an die GPU-Server und schreibt Checkpoints zurück. Oft ebenfalls RoCEv2 , dimensioniert auf dauerhafte Bandbreite statt auf GPU-Anzahl.
Front-End-Netz
Verbindet den Cluster mit Nutzern, Orchestrierung und dem übrigen Rechenzentrum. Ein konventionelles Leaf-Spine, oft mit EVPN-VXLAN zur Trennung von Mandanten in einer GPU-Cloud.
Out-of-Band-Management
Ein separates 1G-Netz für Konsolen, Server-Management-Controller und Switch-Management, damit Betreiber jedes Gerät erreichen, wenn die Data Planes ausgelastet oder ausgefallen sind.
Innerhalb der Back-End-Fabric kann dasselbe Switch-Modell als Rail-Leaf, Spine oder Super-Spine dienen. Ein rail-optimiertes Design verbindet jede GPU-NIC eines Servers mit einem anderen Leaf, sodass GPU-Verkehr gleichen Rangs einen Hop entfernt bleibt. Die Topologie bestimmt die Rolle; AI-Fabric-Topologien und rail-optimiertes Netz behandeln diese Designs.
AI-Switches werden von Neocloud- und GPU-Cloud-Anbietern, Rechenzentren großer Unternehmen und MSPs sowie von Service Providern gekauft, die GPU-Kapazität in ihren eigenen Rechenzentren aufbauen.
800G oder 400G: einen AI-Switch nach Radix dimensionieren
Die Portanzahl des Switches bestimmt, wie weit eine Fabric wächst, bevor sie eine weitere Stufe braucht. In einem nicht blockierenden zweistufigen Leaf-Spine teilt jedes Leaf seine Ports gleichmäßig zwischen GPUs und Spines auf, und jeder Spine-Port verbindet ein Leaf. Ein Switch mit k Ports unterstützt dann k zum Quadrat geteilt durch zwei Endpunkte in zwei Stufen und k hoch drei geteilt durch vier in drei Stufen.
| Switch-Kapazität | Ports mit voller Rate | Zwei Stufen, nicht blockierend | Drei Stufen, nicht blockierend |
|---|---|---|---|
| 51,2 Tbps | 64 mit 800G | 2.048 Endpunkte mit 800G | 65.536 Endpunkte mit 800G |
| 25.6 Tbps | 64 mit 400G | 2.048 Endpunkte mit 400G | 65.536 Endpunkte mit 400G |
| 12.8 Tbps | 32 mit 400G | 512 Endpunkte mit 400G | 8.192 Endpunkte mit 400G |
- Dies sind rechnerische Obergrenzen, keine Skalierungswerte von Produkten. Reale Designs verschieben sie durch Oversubscription, Rails pro Server, Reichweite der Optiken und Rack-Leistung.
- 800G bei gleichem Radix verdoppelt die Bandbreite pro GPU, ohne eine Stufe hinzuzufügen. Deshalb nutzen Back-End-Fabrics mit 800G-NICs 51,2-Tbit/s-Switches.
- Referenzdesigns von IP Infusion für Rail-optimierte zwei- und dreistufige Fabrics, dimensioniert in realen Port-Zahlen, finden Sie auf AI-Fabric-Topologien. Die Wahl zwischen den Designs wird erläutert in So wählen Sie eine AI-Networking-Fabric.
Für OcNOS-DC qualifizierte AI-Data-Center-Switches
OcNOS-DC ist das Netzwerkbetriebssystem von IP Infusion für Data-Center- und AI-Fabrics. Es läuft auf offenen Switches mit Broadcom-Silicon, und jede der folgenden Plattformen steht in der OcNOS-Hardware-Kompatibilitätsliste, die insgesamt über 40 qualifizierte Plattformen umfasst.
| Kapazität | Broadcom-ASIC | Qualifizierte Plattformen | Typischer Einsatzort in einem AI-Rechenzentrum |
|---|---|---|---|
| 51,2 Tbps | Tomahawk 5 (BCM78900) | Edgecore AIS800-64D, UfiSpace S9321-64E, UfiSpace S9321-64EO | 800G-Back-End-Leaf und -Spine; der S9321-64EO überträgt außerdem kohärentes DCI zwischen Standorten |
| 25.6 Tbps | Tomahawk 4 (BCM56990) | Edgecore AS9736-64D (DCS520) | 400G-Back-End-Fabric, Storage oder Front-End |
| 12.8 Tbps | Trident 4 (BCM56880) | Edgecore AS9726-32DB (DCS240), UfiSpace S9300-32D | 400G-Leaf für Front-End und Storage; IPoDWDM-fähig |
Was OcNOS-DC dem Switch bringt
- Verlustfreies RoCEv2: PFC, einschließlich PFC über geroutete Layer-3-Underlays, PFC-Deadlock-Erkennung und -Behebung, ECN für DCQCN sowie DCBX und ETS für Bandbreite pro Klasse.
- Lastverteilung: Dynamic Load Balancing (DLB) für überlastungsbewusste Pfadwahl sowie Global Load Balancing (GLB) für die Fabric-weite Pfadoptimierung in OcNOS 7.1.
- Mandantenfähige GPU-Clouds: EVPN-VXLAN trennt Mandanten auf einer gemeinsamen Fabric. Auf Plattformen mit Trident 3 X4, X5 und X7 sowie Trident 4 signalisieren ECN und PFC over VXLAN außerdem Überlast über das Overlay hinweg.
- Betrieb: Streaming-Telemetrie über gNMI und OpenConfig sowie NETCONF, YANG und Zero-Touch Provisioning.
- Lizenzierung und Plattformunterstützung: DLB, PFC-Deadlock-Erkennung und -Behebung sowie ECN over VXLAN sind Features der Stufe OcNOS-DC PLUS, und die Unterstützung variiert je nach Plattform. Die OcNOS-Feature-Matrix listet jedes Feature nach Plattform und Stufe.
- Management-Netz: 1G-Plattformen mit Trident 3 X2 (Edgecore AS4625-54T, Celestica DS1000 und UfiSpace S6301-56ST, jeweils 120 Gbps) betreiben das Out-of-Band-Netz mit demselben NOS.
Was offene AI-Switches Ihnen bieten und was sie von Ihnen verlangen
Offene Switches mit einem separaten Netzwerkbetriebssystem verändern, wo die Entscheidungen und wo die Arbeit liegen.
Was Sie gewinnen
- Hardwareauswahl. OcNOS-DC läuft auf Switches von mehr als einem Hardwarehersteller, sodass jede Plane nach Kapazität, Optiken und Lieferzeit ausgewählt werden kann.
- Ein NOS über alle Planes. Back-End-, Storage-, Front-End- und Management-Netze laufen mit einem Betriebssystem, einer CLI und einem Automatisierungsmodell.
- Standard-Ethernet. Eine RoCEv2-Fabric nutzt dieselben Optiken, dieselbe Verkabelung und dieselben Tools wie das übrige Rechenzentrum, und die GPU-NIC wird unabhängig vom Switch ausgewählt.
- Ein Weg zu neuem Silicon. Der Wechsel von 25,6 auf 51,2 Tbit/s ändert den Switch, nicht das Betriebsmodell.
Was er von Ihnen verlangt
- Integration. Verlustfreies Ethernet funktioniert nur, wenn Switch-Puffer, PFC, ECN und die Congestion Control der NIC gemeinsam abgestimmt sind. Jemand muss dieses Tuning durchführen und verantworten.
- Supportmodell. Bei Hardware und Software von verschiedenen Unternehmen braucht der Betreiber einen klar Verantwortlichen, wenn eine Störung die Grenze zwischen beiden überschreitet.
- Validierungsaufwand. Optiken, Kabel, NIC-Firmware und NOS-Releases ändern sich jeweils mit der Zeit, und jede Kombination muss vor der Produktion getestet werden.
OcNOS-Systeme gehen diese drei Punkte an, indem sie den Switch und OcNOS-DC als ein komplettes, validiertes System sofort einsatzbereit ausliefern, wobei die unterstützten Kombinationen aus Plattform und Features in der Hardware Compatibility List und der Feature Matrix veröffentlicht sind.
Drei Wege, AI-Data-Center-Switches zu beschaffen
Das Switch-Silicon ist bei den Optionen oft dasselbe. Unterschiedlich ist, wer die Software auswählt, wer die Komponenten integriert und wer die Tests trägt.
| Frage | Integrierter Switch und NOS von einem Hersteller | Selbst integrierter offener Switch | Validiertes offenes System |
|---|---|---|---|
| Hardwareauswahl | Die eigenen Modelle des Herstellers | Jeder vom Käufer gewählte offene Switch | Offene Switches aus der OcNOS-HCL |
| Netzwerkbetriebssystem | An die Hardware gebunden | Vom Käufer gewählt und installiert | OcNOS-DC, qualifiziert auf dieser Plattform |
| Wer integriert und testet | Der Hersteller | Der Käufer | IP Infusion qualifiziert die Kombination aus Plattform und NOS |
| Wahl der GPU-NIC | Je nach Hersteller unterschiedlich | Jede NIC, die RoCEv2 unterstützt | Jede NIC, die RoCEv2 unterstützt |
| Wo der Aufwand liegt | Geringer Integrationsaufwand, eingeschränkte Auswahl | Höchster Integrationsaufwand, größte Auswahl | Integration vorab erledigt, Auswahl innerhalb der HCL |
| Wechsel auf neues Silicon | Wenn der Hersteller es veröffentlicht | Wenn der Käufer es validiert hat | Wenn die Plattform in die HCL aufgenommen wird |
FAQ zu AI-Networking-Switches
Was ist ein AI-Switch?
Welcher Switch ist der beste für AI?
Brauche ich 800G-Switches für AI, oder reicht 400G?
Was ist ein GPU-Fabric-Switch?
Brauchen AI-Switches Deep Buffers?
Kann eine AI-Netzwerk-Fabric Ethernet statt InfiniBand nutzen?
Welche Switches unterstützt OcNOS für AI-Fabrics?
Weiterlesen zu AI-Fabrics und Open Networking
Was ist ein Netzwerkbetriebssystem?
Die Software, die Silicon zu einer Fabric macht.
Was ist verlustfreies Ethernet?
PFC, ECN und DCQCN und wie sie Verluste verhindern.
Tiefer einsteigen. Zum Mitnehmen.
Zwei kurze, technische Downloads, die weiter gehen als diese Seite: das vollständige OcNOS-DC-Datenblatt und die verlustfreie 800G-AI-Fabric-Architektur.
OcNOS-DC-Datenblatt
Vollständige OcNOS-DC-Spezifikation: Funktionsumfang für EVPN-VXLAN und Ethernet for AI, Software-SKUs, unterstützte Hardware-Plattformen und der Solution Ordering Guide.
Datenblatt abrufen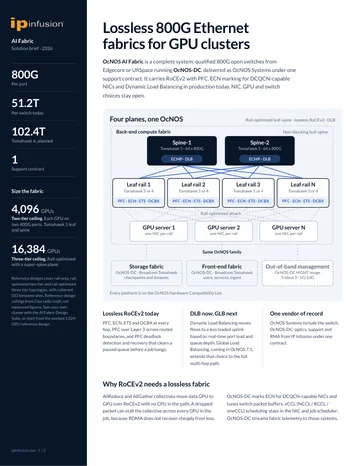
OcNOS: verlustfreie 800G-AI-Fabric
Verlustfreie RoCEv2-Fabric auf Tomahawk-5-Spines: SKU-Stufen, qualifizierte Plattformen und Deployment-Architektur.
Brief anfordernOcNOS-DC-Datenblatt
Kurzes Formular. Ihr PDF öffnet sich unmittelbar nach dem Absenden in einem neuen Tab.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
OcNOS: verlustfreie 800G-AI-Fabric
Kurzes Formular. Ihr PDF öffnet sich unmittelbar nach dem Absenden in einem neuen Tab.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
Sie wählen Switches für einen GPU-Cluster aus? Beginnen Sie mit der GPU-Anzahl.
Nennen Sie uns die GPU-Anzahl, die NIC-Geschwindigkeit und die Oversubscription, die Sie akzeptieren können. Ein Ingenieur von IP Infusion dimensioniert die Leaf-, Spine- und Super-Spine-Stufen auf qualifizierten Switches mit OcNOS-DC.