Dynamic Load Balancing: überlastungsbewusste Pfadwahl für AI-Fabrics
Verwenden Sie in einer AI-Fabric Dynamic Load Balancing statt statischem Hash-ECMP. DLB bewertet den Pfad bei jedem Flowlet neu, einem Sub-Flow-Abschnitt, der durch eine Inter-Packet-Gap abgegrenzt ist, unter Verwendung von Live-ASIC-Telemetrie zu Egress-Queue-Tiefe und Port-Auslastung, sodass GPU-Kollektive nicht länger auf einem einzelnen Uplink kollidieren. Es läuft im Switch-ASIC auf Broadcom Tomahawk 4 und 5, ohne Änderungen an NIC oder Collective-Library.
Dynamisches Load Balancing auf einer Leaf-Spine-Fabric
Ein Ausschnitt mit vier Spines und zwei Leaves, der GPU-AllReduce-Verkehr trägt. DLB misst die lokale Egress-Queue-Tiefe in Echtzeit. Wenn Spine-3 sättigt, verlagert das Leaf das nächste Flowlet auf ein weniger ausgelastetes Spine und hält alle vier Uplinks im Gleichgewicht.
Statisches ECMP und DLB, Achse für Achse
Standard-ECMP hasht das 5-Tupel beim Flow-Start und fixiert den Flow für seine gesamte Lebensdauer. Bei Nord-Süd-Webverkehr glätten Millionen kurzlebiger Flows die Auslastung über die Pfade. In einer AI-Fabric verursachen eine Handvoll GPU-Elephant-Flows, von denen jeder einen ganzen 400G- oder 800G-Uplink für Sekunden belegt, Hash-Kollisionen: Einige Uplinks sättigen, während parallele Pfade brachliegen. DLB bewertet den Pfad bei jedem Flowlet mithilfe von Live-ASIC-Telemetrie neu.
| Kriterium | Statisches ECMPhashen und fixieren | DLBüberlastungsbewusst, pro Flowlet |
|---|---|---|
| Pfadentscheidung | Hasht das 5-Tupel einmal beim Flow-Start und fixiert den Flow für seine gesamte Lebensdauer. | Bewertet den Pfad an jeder Flowlet-Grenze neu und verlagert Verkehr auf einen weniger überlasteten Uplink. |
| Granularität | Ganzer Flow. Eine einzige Hash-Entscheidung bestimmt Sekunden von Elephant-Flow-Verkehr. | Flowlet: ein Sub-Flow-Abschnitt, abgegrenzt durch eine kleine Inter-Packet-Gap, sicher neu verteilbar ohne Neuordnung. |
| Congestion-Signal | Keines. Der Hash ist blind für den Echtzeit-Link-Status. | Live-ASIC-Telemetrie zu Egress-Queue-Tiefe und Port-Auslastung. |
| Unter GPU-Elephant-Flows | Hash-Kollisionen: Zwei Elefanten können auf demselben Uplink landen, während ein anderer brachliegt. | Gesättigte Members fallen aus der Kandidatenmenge, sodass die Uplinks im Gleichgewicht bleiben. |
| Neuordnungsrisiko | Keines; der Flow ist fixiert, aber auf Kosten von Hotspots und Tail-Latenz-Ausreißern. | In der Praxis keines; die Inter-Packet-Gap sorgt dafür, dass RoCEv2 und TCP eine korrekte In-Order-Zustellung sehen. |
| NIC / Collective-Library | Keine Änderungen; Standardverhalten. | Keine Änderungen. Läuft im Switch-ASIC, sodass RoCEv2-NICs und xCCL-Stacks unberührt bleiben. |
| Hardware | Jeder ECMP-fähige Switch. | Broadcom Tomahawk 4 (25.6T) und Tomahawk 5 (51.2T) in 64x400G- und 64x800G-Konfigurationen. |
Die OcNOS-DLB-Implementierung
DLB ist kein Aufsatz auf der Control-Plane. Es läuft in der Broadcom-Forwarding-Pipeline, bewertet jeden ECMP-Next-Hop anhand von Live-Congestion-Signalen und verteilt Flowlets in Hardware neu.
Flowlet-Gap-Timer
Ein ASIC-nativer Flowlet-Inaktivitäts-Timer teilt lange Elephant-Flows in Abschnitte, die sich sicher über Pfade verteilen lassen, ohne TCP- oder RoCEv2-Neuordnung.
Live-Feedback zur Queue-Tiefe
DLB nutzt Signale zur Queue-Belegung pro Egress-Port und zur Link-Auslastung aus der Tomahawk-Pipeline, um jeden ECMP-Next-Hop in Echtzeit zu bewerten.
Überlastungsbewusste Next-Hop-Auswahl
An jeder Flowlet-Grenze wird das Member mit der höchsten Qualität gewählt, sodass ein gesättigter Spine aus der Kandidatenmenge fällt.
TH4 / TH5 nativ
Qualifiziert auf Broadcom Tomahawk 4 (25.6T) und Tomahawk 5 (51.2T) Spine-Plattformen, in 64x400G- und 64x800G-Port-Konfigurationen.
Wo DLB in der Fabric sitzt
DLB ist die Single-Hop-, congestion-bewusste Schicht eines größeren offenen Ethernet-Transports. Es setzt auf verlustfreiem RoCEv2 auf, und fabric-weites GLB, das mit OcNOS 7.1 kommt, erweitert es um eine Ende-zu-Ende-Bewertung.
Verlustfreier Transport darunter
DLB verteilt Flowlets neu auf Basis einer Verlustfreie RoCEv2-Fabric (PFC, ECN, DCQCN).
Fabric-weite Bewertung als Nächstes
Wo DLB den lokalen Next-Hop bewertet, GLB (OcNOS 7.1) erweitert die Entscheidung auf die Ende-zu-Ende-Pfadqualität über die gesamte Leaf-Spine-Fabric.
Dieselbe Idee in der NIC
Ultra Ethernet verlagert die Pfadverteilung in die NIC: Packet Spray und Multi-Path-RDMA verteilen einen Flow von UEC-fähigen NICs aus über viele Pfade.
Was DLB in produktiven AI-Fabrics leistet
Indem DLB Flowlets von den überlasteten Uplinks fernhält, die statisches ECMP überfrachtet, macht es aus einer symmetrischen Leaf-Spine-Fabric eine, die unter GPU-Kollektivverkehr ausbalanciert bleibt.
- Höhere Auslastung. Flowlet-Rebalancing hält Traffic von den überlasteten Uplinks fern, die statisches ECMP überfrachtet, sodass eine gut betriebene Fabric auf derselben Hardware eine Auslastung von über 90 Prozent anstreben kann, ohne zusätzliche Uplinks zu kaufen.
- Niedrigere Tail-Latenz. Die Collective-Completion-Time verbessert sich, weil kein einzelner Link gesättigt wird, während andere ungenutzt bleiben.
- Keine NIC-Änderungen. DLB ist im Switch-ASIC angesiedelt. Bestehende RoCEv2-NICs und xCCL-Kollektiv-Stacks (NCCL, RCCL, oneCCL) sehen eine korrekte In-Order-Zustellung ohne Codeänderungen.
- PLUS-Stufe. DLB ist in den OcNOS-DC-PLUS-SKUs enthalten, mit demselben Supportvertrag wie das übrige OcNOS-DC.
Dynamisches Load Balancing ist Grundvoraussetzung für eine Ethernet-AI-Fabric
Statisches ECMP wurde für Nord-Süd-Webverkehr entwickelt. Sobald eine Fabric GPU-Kollektive überträgt, entscheidet dynamisches Load Balancing über den Unterschied zwischen ausbalancierten Uplinks und ins Stocken geratenen Trainingsjobs, und OcNOS liefert es heute auf offener Hardware.
ECMP allein reicht nicht aus
Eine Handvoll Elephant-Flows setzt statisches Hashing außer Kraft. Hash-Kollisionen lassen einige Uplinks gesättigt zurück, während parallele Pfade ungenutzt bleiben.
DLB schließt die Routing-Lücke
Überlastungsbewusste Pfadauswahl je Flowlet hält eine Ethernet-Fabric unter Kollektivverkehr ausbalanciert, eine der Dimensionen, in denen InfiniBand einen Vorsprung hatte.
OcNOS ist der Enabler
DLB heute, GLB in OcNOS 7.1. Ein NOS auf qualifizierter offener Hardware von Anbietern wie Edgecore und UfiSpace, ohne Änderungen an NIC oder Kollektivbibliothek.
Dynamic Load Balancing, erklärt
Was ist ein Flowlet und warum verwendet DLB es?
Worin unterscheidet sich DLB von statischem ECMP?
Erfordert DLB neue NICs oder Änderungen an meiner Collective-Bibliothek?
Welche Hardware unterstützt OcNOS DLB?
Tiefer einsteigen. Zum Mitnehmen.
Das Produktdatenblatt und kurze, technische Downloads, die über diese Seite hinausgehen.
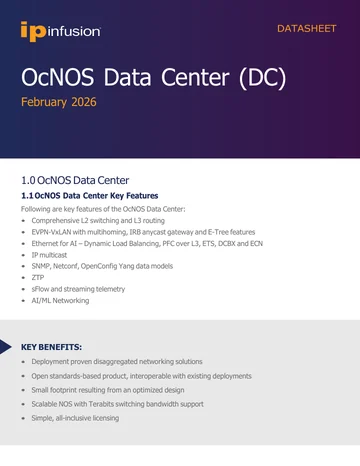
OcNOS-DC-Datenblatt
Vollständige OcNOS-DC-Spezifikation: Funktionsumfang für EVPN-VXLAN und Ethernet for AI, Software-SKUs, unterstützte Hardware-Plattformen und der Solution Ordering Guide.
Datenblatt abrufen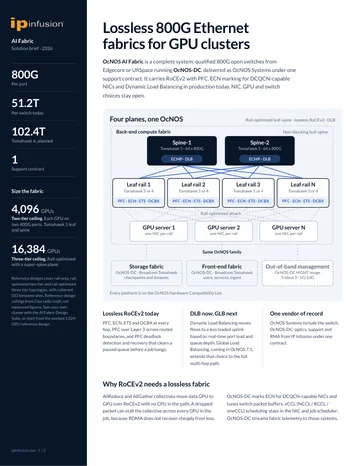
OcNOS: verlustfreie 800G-AI-Fabric
Verlustfreie RoCEv2-Fabric auf Tomahawk-5-Spines: SKU-Stufen, qualifizierte Plattformen und Deployment-Architektur.
Brief anfordern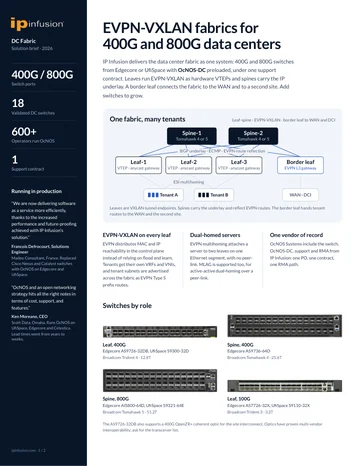
EVPN-VXLAN-Data-Center-Fabric
Leaf-Spine-Rechenzentrums-Fabric auf EVPN-VXLAN: eine VRF und VNIs pro Mandant, EVPN-Multihoming, BGP unnumbered und Route-Target-Filterung.
Brief anfordernOcNOS-DC-Datenblatt
Kurzes Formular. Ihr PDF öffnet sich unmittelbar nach dem Absenden in einem neuen Tab.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
OcNOS: verlustfreie 800G-AI-Fabric
Kurzes Formular. Ihr PDF öffnet sich unmittelbar nach dem Absenden in einem neuen Tab.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
EVPN-VXLAN-Data-Center-Fabric
Kurzes Formular. Ihr PDF öffnet sich unmittelbar nach dem Absenden in einem neuen Tab.
✓ Ihr PDF wird in einem neuen Tab geöffnet…
Falls es sich nicht geöffnet hat, nutzen Sie den untenstehenden Link.
Die gesamte AI-Fabric mit OcNOS entwerfen
Vom Business Case bis zur Portanzahl-Berechnung: Steigen Sie dort ein, wo Sie beim Aufbau gerade stehen.
DLB für Ihre GPU-Fabric optimieren? Fordern Sie eine workload-spezifische Bewertung an
Nennen Sie uns die GPU-Größenordnung und das Kollektivmuster, und ein IP Infusion Engineer stimmt gemeinsam mit Ihnen die Flowlet-Timer und das Path-Scoring ab, oder beginnen Sie mit einem ersten Leaf-Spine-Entwurf in der AI Fabric Design Suite.