什么是 GPU Fabric?
GPU fabric 是把跨服务器和跨 pod 的 GPU 互连起来的后端网络,使它们能够协同完成一项训练或推理作业。 它承载 GPU 在集合操作期间交换的 RDMA 流量,独立于用于管理和存储的前端网络。它是一张 scale-out 网络,从服务器内的 scale-up 域(例如 NVLink)结束之处开始,由运行无损 RoCEv2 的 rail 优化和 Clos 拓扑构建,OcNOS-DC 在 Broadcom Tomahawk 5 硬件上提供它。
scale-up 结束,scale-out 开始
GPU fabric 位于一条清晰边界的一侧。在服务器内部,scale-up 域以太比特速率运行;在服务器之间,scale-out GPU fabric 承载其余部分。一次集合通信先在域内使用 scale-up,然后由这张 fabric 承载跨服务器流量。
scale-up 域
GPU 服务器及其紧耦合域内部的超高带宽互连,例如 NVL72 机架内的 NVLink。在这里,GPU 之间的通信就像一个大型加速器。这不是 GPU 网络。
横向扩展 GPU 网络
服务器与 pod 之间跨越以下层级的以太网网络: rail、leaf、spine 和 Clos 各层。这才是 GPU 网络。由于纵向扩展会先把数据移到目标轨道上,这个平面主要承载同轨道和跨 pod 流量,这正是在这里值得专门投入 1:1 无阻塞的原因。
Rail 与 Clos
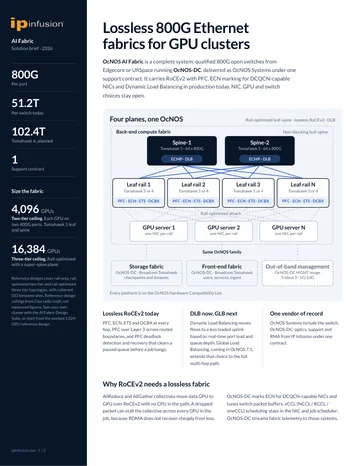
多数 GPU fabric 是 rail 优化的 leaf-spine 网络:GPU 服务器的 8 块 NIC 各自连接到专用的 rail leaf,因此占主导的同 rail AllReduce 流量留在一台 leaf 上,绝不穿越 spine。超出 4,096 个 GPU 的单个 pod 后,同样的 rail 优化设计增加 super-spine 层。
三层规模
在 Tomahawk 5 上,双层 fabric 可达 4,096 个 GPU ,每个 GPU 800G,1:1 无阻塞;超过此规模,第三层最多可扩展至 16,384 个 GPU.
无损 RoCEv2,由 OcNOS-DC 交付
GPU 通过基于 RoCEv2 的 RDMA 搬移数据,而 RDMA 在丢包下表现很差。因此 GPU fabric 被精心设计为无损并保持负载均匀,使集合通信期间没有链路成为热点。OcNOS-DC 在 Broadcom Tomahawk 5 上正是提供了这一点,作为开放、多厂商硬件的使能者。
- 通过优先级流控(包括三层)和 ECN 精心设计为无损,使一个训练步骤绝不因丢包而停滞。
- 借助 DLB 保持负载均匀,使集合通信期间没有任何单条链路成为热点。
- 由 OcNOS-DC 在 Broadcom Tomahawk 5(51.2 Tbps,64x800G)平台上交付,例如 Edgecore AIS800-64D 和 UfiSpace S9321-64E。
什么是 GPU Fabric 常见问题解答
什么是GPU组网?
scale-up 和 scale-out 有何区别?
GPU fabric 采用什么拓扑?
GPU fabric 必须无损吗?
深入了解,随身带走。
两份简短的技术下载资料,比本页更深入:完整的 OcNOS-DC 数据表和无损 800G AI fabric 架构。
OcNOS-DC 数据手册
表单简短。提交后您的 PDF 将立即在新标签页中打开。
✓ 正在新标签页中打开您的 PDF……
如果未能自动打开,请使用下方链接。
OcNOS 800G 无损 AI Fabric
表单简短。提交后您的 PDF 将立即在新标签页中打开。
✓ 正在新标签页中打开您的 PDF……
如果未能自动打开,请使用下方链接。
用 OcNOS 设计整张 AI fabric
从商业论证到端口数量测算,无论您进行到哪一步,都可从此接续。
在搭建 GPU fabric?让我们一起为该平面设定规格。
告诉我们 GPU 数量和工作负载,IP Infusion 的工程师将与您一起做端口测算,或先在 AI Fabric Design Suite 中从一版初步的 rail 优化布局开始。