面向 neocloud 与 GPU 云运营商的网络
IP Infusion 提供 GPU 云赖以运行的网络:在经过认证的交换机上运行 OcNOS-DC,覆盖无损 GPU fabric、存储网络、租户前端网络和带外管理,全部纳入一份支持合同。
一台 GPU 服务器,四张网络
GPU 云中的每台服务器都连接四张网络:GPU 后端 fabric、存储、租户前端和管理。OcNOS-DC 可运行全部四张网络,因此一个团队即可在整个云中运维同一个软件系列。
选择一张网络,查看它承载的流量
GPU 后端。 GPU 集合通信运行在独立的路由 fabric 上。基于三层的 PFC 和 ECN 让 RoCEv2 流量保持无损,动态负载均衡将 flowlet 转移到负载较轻的上行链路。Tomahawk 5 交换机提供 64 × 800G。
存储。 存储流量拥有独立的网络,并通过 PFC 和 ECN 保持无损。当存储与 EVPN-VXLAN fabric 共用时,PFC 和 ECN 也可在受支持的交换机上基于 VXLAN 运行。
前端。 客户通过前端网络访问其 GPU。在受支持的 Trident 3 和 Trident 4 交换机上,EVPN-VXLAN 为每个租户提供独立的 VRF 和 VNI,并支持 MAC 限制和 route-target 过滤。
管理。 带外管理运行在 1G 交换机上,配合管理 VRF 和零接触配置,使管理流量与生产网络分离。
示意图。
训练与推理对网络的要求各不相同
Neocloud 两者兼顾。训练以稳定、同步的流量填满少数几个大型集群。推理流量分布在众多站点,并以突发方式到达。
| 网络所面对的 | 训练AI 工厂 | 推理实时服务 |
|---|---|---|
| 分布 | 少数几个大型 GPU 集群 | 众多区域和边缘站点 |
| 流量 | 大批量、同步的 GPU 到 GPU 集合通信 | 小而对时延敏感的请求 |
| 负载特征 | 长时间保持接近满载的 GPU 利用率 | 突发且弹性,数秒内激增 |
| 网络必须做到 | 在持续带宽下保持无损 | 低时延,且每一层都冗余 |
OcNOS-DC 在 GPU 云中运行哪些功能
各网络所依赖的功能,来自 OcNOS 功能矩阵。
| 能力 | 它的作用 | 适用范围 |
|---|---|---|
| 基于三层的 PFC 和 ECN | 在路由 fabric 上实现无损 RoCEv2,并在流量类别之间运行 ETS | 所有 OcNOS-DC |
| 动态负载均衡 | 将 flowlet 转移到负载较轻的上行链路 | 部分交换机 |
| PFC 死锁检测与恢复 | 检测停滞的优先级队列并将其恢复 | 部分交换机 |
| EVPN-VXLAN | 基于 VXLAN 的二层 EVPN,每个租户一个 VRF 和多个 VNI | Trident 3 和 4 |
| 租户限制 | 每租户 MAC 限制和 route-target 过滤 | 部分交换机 |
| 基于 VXLAN 的 PFC 和 ECN | EVPN-VXLAN fabric 上的无损存储流量 | 部分交换机 |
| MLAG 与 EVPN 多归属 | MLAG 采用 active/active 模式;EVPN 采用 single-active 或 port-active 模式 | 部分交换机 |
| 交换机内置相干光模块 | 站点之间的 400G 和 800G ZR 与 OpenZR+ 链路 | 部分交换机 |
| 管理 VRF 与 ZTP | 带外管理与零接触配置 | 所有 OcNOS-DC |
支持情况因交换机型号和许可证而异。 请查阅 OcNOS 功能矩阵。
按网络划分的交换机
每张网络使用适合其流量的交换机,全部运行 OcNOS-DC。
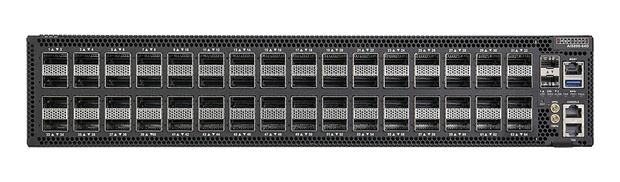
GPU fabric spine 与 leaf
Edgecore AIS800-64D
Tomahawk 5 · 51.2 Tbps
64 × 800G
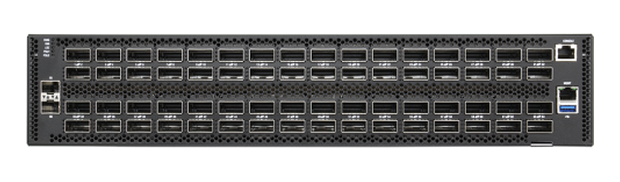
400G GPU rail leaf
Edgecore AS9736-64D
Tomahawk 4 · 25.6 Tbps
64 × 400G
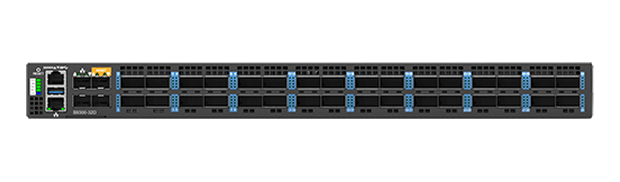
前端与存储 leaf
UfiSpace S9300-32D
Trident 4 · 12.8 Tbps
32 × 400G
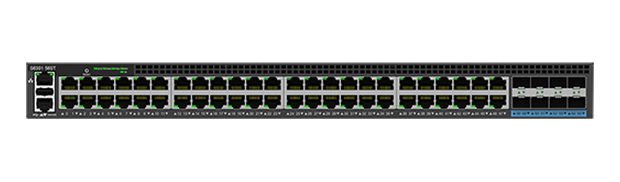
带外管理
UfiSpace S6301-56ST
Trident 3 · 120 Gbps
48 × 1G、8 × 10G
OcNOS on open switches carries the AI fabric at 40 to 60% lower hardware cost ,在相当的端口速率和 radix 下低于专有平台。 了解无损 AI fabric 的工作原理。 在 OcNOS 硬件兼容性列表中查看经过认证的交换机完整列表。
在数据中心运行 OcNOS 的运营商
IzarLink
EVPN-VXLAN 核心将 25G 接入汇聚到冗余的 100G 核心,并互联其数据中心与对等互联站点。
阅读案例 →Nextlink Internet
在横跨 11 个州的 Edgecore 硬件上,以 OcNOS-DC 支撑核心数据中心运营,以 OcNOS-SP 承载中程传输。
阅读案例 →Scott Data
OcNOS 运行在 UfiSpace、Edgecore 和 Celestica 硬件上,覆盖一个提供托管服务、通过 Tier III 认证的数据中心园区。
阅读案例 →“IP Infusion OcNOS 提供了技术深度和更优的网络经济性,使我们能够及时升级数据中心核心网络,获得面向未来的规模、安全性和韧性。”
Alexis Guirlé,IzarLink CEO
关于 neocloud 网络的问题。
neocloud 和 GPU 云服务商的 AI 需要什么样的网络?
一个平台能否同时支持 AI 训练和推理?
GPU 云如何隔离不同客户?
当链路或交换机发生故障时,fabric 如何保持推理可用?
如何评估用于 AI 训练和推理的网络厂商?
neocloud 如何连接各个站点?
数据手册与解决方案简介。
OcNOS-DC 数据手册和两份解决方案简介,便于与您的团队分享。表单简短,PDF 立即下载。
OcNOS 800G 无损 AI Fabric
基于 Tomahawk 5 spine 的无损 RoCEv2 fabric:SKU 等级、经过认证的平台和部署架构。
获取简报EVPN-VXLAN 数据中心网络
基于 EVPN-VXLAN 的 leaf-spine 数据中心 fabric:每租户一个 VRF 和多个 VNI、EVPN 多归属、BGP unnumbered 和 route-target 过滤。
获取简报OcNOS-DC 数据手册
完整的 OcNOS-DC 规格:EVPN-VXLAN 与 Ethernet for AI 功能集、软件 SKU、支持的硬件平台,以及解决方案订购指南。
获取数据手册OcNOS 800G 无损 AI Fabric
表单简短。提交后您的 PDF 将立即在新标签页中打开。
✓ 正在新标签页中打开您的 PDF……
如果未能自动打开,请使用下方链接。
EVPN-VXLAN 数据中心网络
表单简短。提交后您的 PDF 将立即在新标签页中打开。
✓ 正在新标签页中打开您的 PDF……
如果未能自动打开,请使用下方链接。
OcNOS-DC 数据手册
表单简短。提交后您的 PDF 将立即在新标签页中打开。
✓ 正在新标签页中打开您的 PDF……
如果未能自动打开,请使用下方链接。
需要我们联系您吗?
留下您的信息,IP Infusion 工程师将帮助您设计一张用于 AI 训练与推理的开放 fabric。仅在您希望时我们才会与您联系。