BCM56990 · 25.6 Tbps · 64×400G

Broadcom Tomahawk 4 Commutateur Tomahawk 4 25.6 Tbps · 64 × 400G · la génération 400G rentable.

Une plateforme ouverte qualifiée sur OcNOS-DC : Edgecore AS9736-64D. Le Tomahawk 4 est le palier 400G rentable : 25.6 Tbps sur des ports 64×400G, sous le spine TH5 800G, avec l'économie du 400G.

25.6Tbps
Capacité du switch
64×400G
Radix de ports natif
~114MB
Buffer partagé
2RU
Format
50GPAM4
SerDes par voie
01
Le switch

Une plateforme. Un objectif : du 400G rentable.

Edgecore AS9736-64D: a 2RU 64×400G QSFP56-DD switch on the BCM56990 Tomahawk 4. It ships with ONIE pre-loaded and runs the same OcNOS-DC software as the TH5 spines and TD4 leaves. One qualified platform: the 64×400G tier of the OcNOS-DC portfolio, below the TH5 800G spine.

Edgecore· famille de plateformes DCS520
AI fabric 400G · DCI

AS9736-64D

Qualifié sur OcNOS-DC · ONIE préchargé
Ports
64 × QSFP56-DD (400G)Breakout : 2×200 / 4×100 / 2×50 (jusqu'à 256 ports logiques)
Format
2RU · 21.5 kg
Alimentation
2100 W max · alimentations AC/HVDC 2400 W redondantes hot-swap24 W par transceiver sur 16 ports, 13 W sur les 48 autres
CPU
Intel Xeon classe C · 32 GB RAM
▌ À choisir lorsque

AI fabric 400G pour clusters GPU single-pod sur NICs 400G, et rôles d'agrégation / DCI 400G, où 25.6T de 64×400G au coût du merchant-silicon fait le travail sans payer pour des ports 800G.
Tomahawk 4 : 64 × 400G

À choisir lorsque des NIC 400G structurent le cluster et que le coût par port compte : 25.6 Tbps en 64×400G, sous le prix du silicon 800G.

Vous êtes ici · 25,6 Tbps

Tomahawk 5 : 64 × 800G

À choisir lorsque le cluster a besoin de ports 800G nativement, ou lorsque le 800G par port à la même densité de 64 ports justifie le surcoût par port. Page Tomahawk 5 →

Passez à la vitesse supérieure · 51.2 Tbps

Trident 4 : DC leaf

À choisir lorsque le rôle est un leaf DC en 100G/400G avec une enveloppe de capacité plus réduite. Famille de puces différente, même logiciel OcNOS-DC, coût par port inférieur. (Page Trident 4 à venir.)

Boîtier plus compact · 12,8 Tbps
02
Au cœur du silicium

Tomahawk 4 : le switch chip 25.6T rentable.

Tomahawk 4 (BCM56990) est un switch 25.6 Tbps avec un radix natif de 64×400G. Il intègre un buffer partagé d'environ 114 MB, optimisé pour le RoCEv2 lossless. Cette puce de switch à faible latence n'est pas une puce de routeur deep-buffer : utilisez un composant StrataDNX Jericho ou Qumran pour un buffering à l'échelle du GB. Pour une fabric IA ou DC 400G, le shared buffer et le DLB conviennent.

Pourquoi c'est important : le RoCEv2 lossless repose sur PFC et le marquage ECN pour garder des files peu profondes, sur le contrôle de débit DCQCN sur les NIC, et sur le DLB pour répartir les elephant flows afin qu'aucune file ne s'accumule. Le TH4 exécute PFC, le marquage ECN et le DLB dans l'ASIC à 400G.

SérieStrataXGS BufferPartagé on-die Équilibrage de chargeDLB
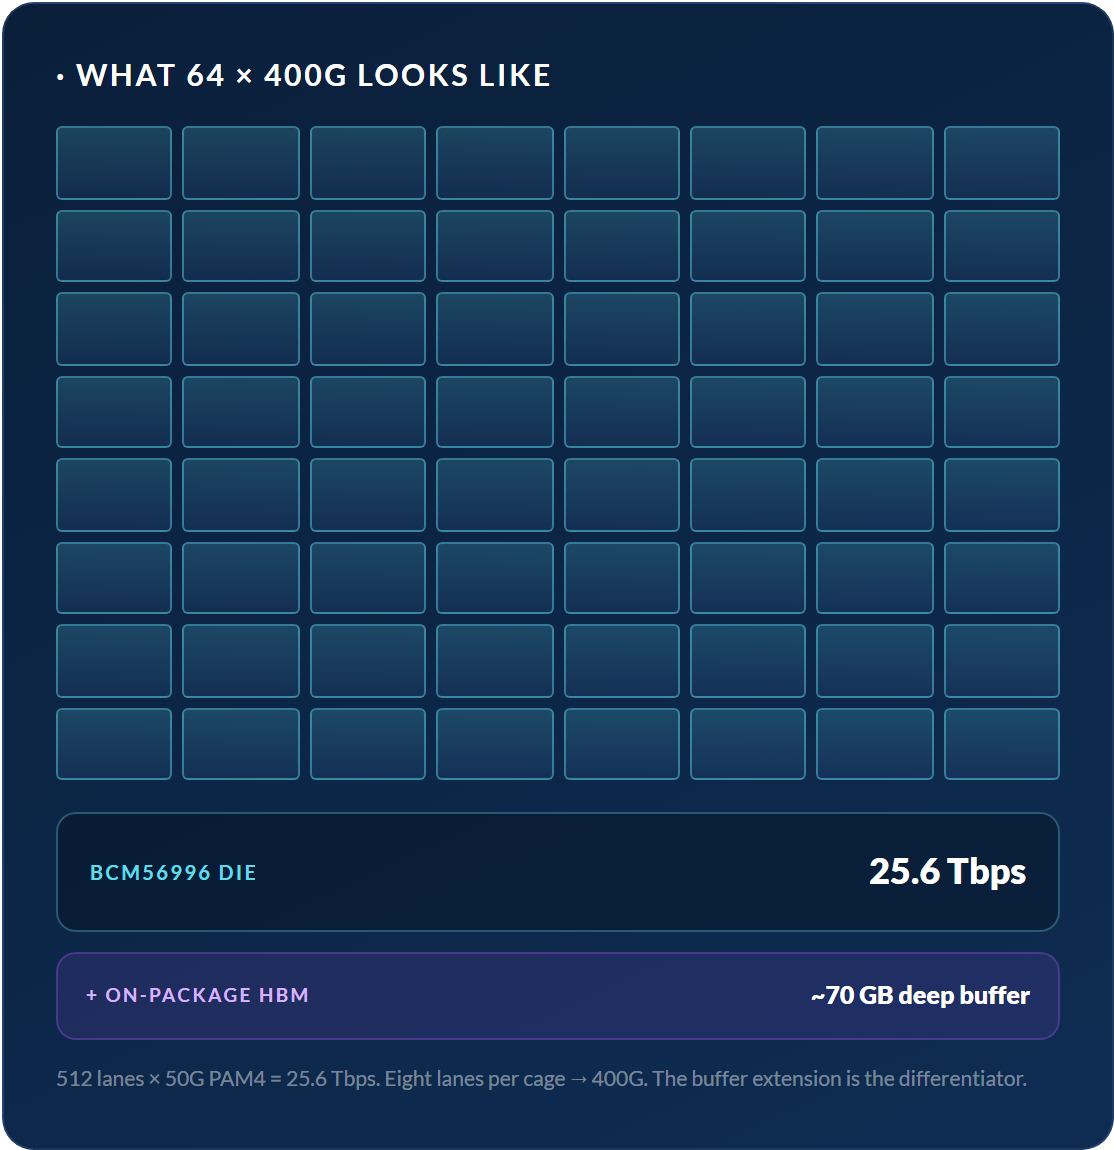
Radix de ports Broadcom Tomahawk 4 (BCM56990) représenté comme une grille de 64 ports, chacun 400G, totalisant 25.6 Tbps
À quoi ressemble le 64 x 400G : 512 lanes de 50G PAM4 totalisant 25.6 Tbps sur le die BCM56990.

Pourquoi le TH4 reste pertinent dans la conversation fabric IA même après l'arrivée du TH5.

Le 400G à l'économie du silicon marchand, sur le même logiciel OcNOS-DC que le TH5 800G.

PRINCIPE 02

SerDes 50G PAM4 : 512 voies.

Le TH4 exploite 512 lanes en 50G PAM4 pour 25.6T. Huit lanes par port QSFP56-DD donnent du 400G natif ; le breakout s'étend au 200G/100G/50G pour les déploiements à vitesses mixtes.

512 lanes · 50G PAM4
PRINCIPE 03

Équilibrage de charge dynamique matériel.

Load balancing tenant compte des flowlets dans l'ASIC, sans aller-retour vers un contrôleur. OcNOS-DC l'active sous le nom de Dynamic Load Balancing (DLB), qui répartit les elephant flows sur la fabric afin qu'aucune file ne s'accumule sous le trafic collectif RoCEv2.

DLB · réaffectation des flowlets
PRINCIPE 04

Silicon mature.

Un comportement prévisible et une enveloppe thermique connue en font un choix naturel pour le renouvellement d'une fabric TH3 brownfield.

Même OcNOS-DC que le TH3
03
Saut de génération

Deux fois la capacité et le radix, sur le même logiciel OcNOS-DC.

Le TH3 (12.8 Tbps · 32×400G) est la génération 400G précédente. Le TH4 a doublé la capacité et le radix de ports, à l'économie du 400G.

Capacité de commutation
12,8 Tbps → 25,6 Tbps

Une capacité doublée dans un boîtier 2RU.

Radix de ports natif
32 × 400G → 64 × 400G

Deux fois plus de ports à la même vitesse : s'intègre aux conceptions Clos sans niveau supplémentaire.

Ports breakout 100G
128 × 100G → 256 × 100G

Chaque port 400G se divise en 4 × 100G sur les deux plateformes.

NOS
OcNOS-DC → OcNOS-DC

Les deux plateformes exécutent OcNOS-DC : un renouvellement conserve le même modèle d'exploitation.

Le prochain saut : Le TH5 double à nouveau pour atteindre 51.2 Tbps et 64 × 800G. Le TH4 reste le palier 400G rentable pour les clusters qui n'ont pas encore besoin de ports 800G. Page Tomahawk 5 →
04
Ce que livre OcNOS-DC

Même logiciel que le spine TH5.

Le même logiciel OcNOS-DC s'exécute sur les plateformes TH3, TH4 et TH5, avec RoCEv2 lossless (PFC + ECN) et télémétrie en streaming sur chacune.

PFC + ECN, et le shared buffer absorbe le reste.

PFC, ETS et ECN standard. Le DLB répartit les elephant flows pour garder des files peu profondes, tandis que la détection et la récupération des deadlocks PFC éliminent les blocages de pause.

Le DLB réassocie les flowlets dans l'ASIC.

Le Dynamic Load Balancing (DLB) d'OcNOS-DC sur TH4 utilise le rebinding de flowlets pour résoudre les collisions de hash ECMP dans l'ASIC, sans aller-retour vers un contrôleur.

Par port, par priorité. Purge automatique.

Détecte les cycles de files en pause avant qu'ils ne bloquent les jobs d'entraînement, et les draine automatiquement pour qu'une pause storm PFC ne puisse pas stopper une collective.

Récupération des deadlocks PFC

La télémétrie sur le fil.

Télémétrie en streaming gNMI, en dial-in et dial-out, avec un mode de flux « on-change », pour que la congestion soit visible et non une boîte noire.

BGP · OSPF · IS-IS, plus EVPN-VXLAN là où c'est pris en charge.

Le routage Layer 3 avec BGP, OSPF et IS-IS fonctionne sur le même silicon. Le spine TH4 prend aussi en charge le routage : vous pouvez l'exploiter comme le reste de votre réseau.

Le même logiciel OcNOS-DC que le TH5 : chaque fonctionnalité s'active là où le silicon le permet.

Routage Layer 3 · L1/L2 · primitives AI fabric · Multicast · QoS · Sécurité · Hardware · Management. Qualification par plateforme visible sur la matrice publique.

RoCEv2 / PFC ECN DLB BGP / OSPF / IS-IS gNMI / NETCONF ZTP réglage des buffers
Day-0 à Day-2

ZTP. gNMI on-change. NETCONF + YANG. DCBX.

Mettez en service l'AS9736-64D dans le rack grâce au provisionnement zero-touch. Diffusez la télémétrie gNMI en dial-in ou dial-out vers votre stack d'observabilité, et ajustez les seuils via une configuration modélisée en YANG.

ZTP IPv4/IPv6 gNMI NETCONF OpenConfig YANG DCBX LLDP Ansible

Trois profils opérateurs. Un seul silicon pour les trois.

Le radix 64×400G à l'économie du 400G place l'AS9736-64D dans trois conversations différentes : AI fabric, DCI et modernisation brownfield. Même switch, formulation différente de la même question architecturale.

Fabric de NIC 400G sans payer pour du silicon 800G.

"Notre cluster est sur des NICs 400G. Nous n'avons pas encore besoin de ports 800G, et nous ne payons pas le premium 800G pour des ports que nous ne pouvons pas utiliser."

Spines TH4 sur AS9736-64D avec RoCEv2 lossless et rebinding DLB. Utilisez un Clos à trois niveaux pour le scale-out multi-pod, avec le même logiciel OcNOS-DC que le déploiement TH5 adjacent.

DC · Spine 400G

Transport DCI 400G sans la facture d'un routeur châssis.

« Nos liens inter-DC ont besoin d'agrégation 400G et de transport EVPN à un prix raisonnable. Les routeurs châssis coûtent bien plus que ce que nous comptons payer. »

Du 64×400G au coût du silicon marchand, une pile L3 complète, la télémétrie gNMI et l'EVPN-VXLAN inter-DC là où la plateforme le prend en charge. Du matériel ouvert pour le transport DCI 400G sans le prix du 800G. Pour les conceptions qui doivent absorber une congestion soutenue exigeant des deep buffers, utilisez une plateforme StrataDNX Jericho plutôt que le TH4.

DC · DCI · Agrégation

Capacité doublée, même modèle opérationnel.

« Nous avons une fabric TH3 en production. Il nous faut davantage de capacité, mais nous ne voulons pas reconcevoir la couche NOS ni reformer l'équipe réseau. »

Le même logiciel OcNOS-DC fonctionne sur TH3 et TH4. Un renouvellement brownfield conserve intacts les configurations, l'automatisation et les pipelines gNMI. La capacité double et le modèle d'exploitation reste le même.

DC · Renouvellement

Questions posées par les architectes

Une seule plateforme : la Edgecore AS9736-64D, un switch 2RU 64×400G QSFP56-DD construit sur le Broadcom BCM56990 (Tomahawk 4, 25.6 Tbps). Livré avec ONIE préchargé, il exécute le même logiciel OcNOS-DC que les spines TH5 et les leaves TD4. C'est la plateforme 64×400G du portfolio OcNOS-DC.
Coût : à l'échelle d'un seul pod avec des NIC GPU 400G, une fabric TH4 coûte moins cher par port qu'une fabric TH5. Elle fournit 25.6 Tbps sur des ports 64×400G avec une puce de switch shared-buffer à faible latence. Un Clos à trois niveaux reste adapté. Passez au TH5 (800G) uniquement lorsque des ports 800G figurent dans la BoM ou lorsque vous voulez diviser par deux le câblage spine-leaf pour la même bande passante agrégée.
Tomahawk 4 is a shared-buffer, faible latence puce de switch, pas une puce de routeur deep-buffer. Son buffer de paquets intégré est d'environ 114 MB, dimensionné pour le RoCEv2 lossless avec PFC et ECN. Pour un deep buffering à l'échelle du GB (rétention DCI longue distance ou fort fan-in N:1), utilisez une puce de routeur StrataDNX Jericho ou Qumran. Pour une fabric IA ou DC 400G à faible latence, le shared buffer et le DLB du TH4 conviennent.
Choisissez le TH5 (AIS800-64D) lorsque des ports 800G figurent dans la BoM ou lorsque vous voulez 800G par port au même radix de 64 ports, ce qui divise par deux le câblage spine-leaf pour la même bande passante agrégée. Choisissez le TH4 (AS9736-64D) lorsque des NIC 400G structurent le cluster et que le budget par port exclut le silicon 800G. Les deux exécutent le même logiciel OcNOS-DC.
Yes. TH4 supports flowlet-aware load-balancing in the ASIC, with no controller round-trip. OcNOS-DC turns this on as Dynamic Load Balancing (DLB), so a TH4 fabric resolves elephant-flow hash collisions in hardware. PFC deadlock detection & recovery and ETS are also available.
Capacité doublée deux fois (12.8 → 25.6 → 51.2 Tbps). Le radix natif est passé de 32 × 400G (TH3) à 64 × 400G (TH4) puis à 64 × 800G (TH5). OcNOS-DC prend en charge les trois avec le même logiciel : un renouvellement brownfield conserve intacts les configurations et les pipelines gNMI.
Le radix 64×400G dépasse les besoins d'un edge SP sous 1 Tbps ou d'une passerelle de site cellulaire ; choisissez Qumran (Q2A/Q2U/Q2C) pour ces rôles. Pour un leaf DC en 100G/400G avec une enveloppe de capacité plus réduite, choisissez Trident 4 (TD4) à 12.8 Tbps. Si le cluster a besoin de ports 800G dès aujourd'hui, le TH4 impose un niveau Clos supplémentaire : choisissez le TH5. Le TH4 est adapté lorsque le 400G suffit et que le coût par port compte.

Vous concevez une fabric 400G ? Dimensionnons-la ensemble.

Session d'architecture de 30 minutes avec un architecte réseau OcNOS. Apportez votre nombre de GPU, la vitesse de vos NIC et vos attentes en matière de patterns de rafales, et repartez avec une BoM dimensionnée autour de l'AS9736-64D et un plan de placement face aux alternatives TH5 / TD4.