AI fabric 設計工具
端到端、廠商中立地設計無阻塞的 RoCEv2 GPU fabric。對 leaf 與 spine 交換器進行選型,規劃光收發模組與纜線數量,針對您的叢集比較 InfiniBand 與 Ethernet,並取得 lossless 壅塞設定檔。本工具僅進行網路設計,不提供成本估算或物料清單。
為 GPU fabric 進行規模估算
選擇一個起始規模,或輸入您自己的GPU數量、連接埠速率與交換晶片。該工具可對折疊式兩層leaf-spine pod進行規模估算,並在叢集跨入三層規模時予以提示。
…
上述數量假設採用折疊式 leaf-spine (Clos) fabric,每個 GPU 配備一張 fabric NIC,每個 leaf 將其連接埠在 GPU 與 spine 上行鏈路之間分配。rail-optimized 佈線(每個 GPU 多張 NIC)改變的是流量的區域性,而非這些交換器數量。請參見 AI fabric拓撲參考設計 適用於 rail-optimized 與三層佈局。
元件摘要
針對已定量設計的 fabric 鏈路、收發器與線纜數量。這些僅為規劃資料,並非物料清單、報價或定價。
| Component | Basis | Quantity |
|---|---|---|
| GPU 側的鏈路 | GPUs × 1 NIC | … |
| leaf到spine的fabric鏈路 | leaves × uplinks | … |
| fabric 光收發器 | links × 2 ends | … |
| fabric纜線 | 每條鏈路 1 個 | … |
按傳輸距離選擇的介質,視佈線情況而定:最長 3 m 採用 DAC 或 AEC,最長 50 至 100 m 採用 AOC 或 SR,最長 500 m 採用 DR(主力選擇),最長 2 km 採用 FR。僅列出傳輸距離等級。不含價格、SKU 或廠商料號。在三層設計中,請在上述數量之外,額外加入 spine 至 super-spine 的鏈路。
InfiniBand 與乙太網對比
這是一份涵蓋六個因素的廠商中立計分卡。它會根據您的輸入顯示每個因素傾向於哪一方及其原因。此處依設計並無唯一贏家。請將其用作設計審查的輸入依據,而非最終建議。
| Factor | InfiniBand | Ethernet / RoCEv2 | Ultra Ethernet (trajectory) |
|---|---|---|---|
| 尖峰效能傾向 InfiniBand | 以較低的調校投入即可獲得百分之十五左右的原始吞吐量優勢,另外還有 SHARP 網路內縮減,可將集合運算從 GPU 卸載。 | Matches InfiniBand with proper tuning. Meta has described training its largest models on a 24,000-GPU RoCEv2 Ethernet cluster in production. The gap is tuning effort, not the ceiling. | 增加 packet spray 與 NIC 側重新排序,以降低尾端延遲並減少對 PFC 的依賴,從而縮小開箱即用的差距。 |
| Cost偏向 Ethernet | 在 fabric 規模下會帶來明顯的溢價,相較於同等 Ethernet 通常處於 30 至 60 個百分點的區間。 | merchant-silicon交換器加上廣泛的光學元件供應鏈,通常使其成為每連接埠成本更低的fabric。 | 與Ethernet相同的開放merchant silicon經濟性。 |
| 開放性偏向 Ethernet | 從交換器、NIC到管理器端到端均為單一廠商堆疊,因此多廠商採購受到限制。 | 開放且多供應商:來自眾多供應商的基於標準的交換器、NIC與NOS,保留供應鏈選擇的彈性。 | 強化開放方向的產業聯盟標準(UEC 1.0,2025 年)。 |
| 維運的簡潔性neutral | UFM提供單一的專用fabric管理器,對於不具備深厚RDMA人才的團隊而言是一套開箱即用的方案。 | 可借助龐大的Ethernet人才儲備與標準工具,但lossless RoCEv2需要審慎的端到端調校。 | 旨在減輕調校負擔,使 Ethernet 趨向類似 IB 的開箱即用表現。 |
| 多租戶與融合偏向 Ethernet | 通常是一個專用的後端孤島,不具備原生多租戶隔離或儲存融合能力。 | 單一收斂的 Ethernet fabric 即可在標準租戶隔離下承載後端、儲存與前端流量。 | 在單一開放fabric上延展converged-Ethernet的方向。 |
| Trajectory偏向 Ethernet | 成熟穩定,在低度調校下即具備領先效能,但受制於單一廠商的路線圖。 | 至 2025 年年中,Ethernet 已轉而主導 AI back-end 部署,並獲得廣泛的生態系統動能。 | UEC 1.0 (2025) 是一項明確針對 AI 與 HPC back-end fabric 的多廠商規範。 |
假設條件:效能是在完成調校的前提下進行比較(未調校的 Ethernet 表現落後,充分調校的 Ethernet 可達到同等水準);成本以區間形式呈現,而非具體金額;開放性指多廠商採購,而非品質評斷;Ultra Ethernet 反映的是 2025 年及之後的方向,而非已出貨產品。集合運算調校泛指 xCCL 函式庫。以上內容用於輔助決策;fabric 選擇請與 IP Infusion 工程師共同驗證。
RoCEv2 lossless 設定檔
RoCEv2 並非單一的交換器特性。它是由 PFC、ECN 與 ETS 組成的設定組合,其中 DCQCN 承擔穩態工作,PFC 作為最後防線。本工具會針對您的設計推薦相應機制及其套用順序。它不會給出門檻數值,也不會對任何設備進行操作。
| 機制 | 在 lossless 設定檔中的作用 | OcNOS 可用性 |
|---|---|---|
| PFC | 為 RoCE 類別提供無丟棄保證。這是最後的兜底機制,而非主要的控制手段。 | 全部 4 個 AI 平台 |
| ECN | 提前標記壅塞,使發送方在佇列溢出前降低速率。將其標記點調至 PFC 觸發點以下。 | 全部 4 個 AI 平台 |
| DCQCN (ECN + PFC) | 穩態下的主要控制手段。ECN 標記驅動 NIC 側的 DCQCN 反應,PFC 予以兜底。它是複合機制,而非獨立功能。 | 全部 4 個 AI 平台 |
| ETS | 提供頻寬保證與類別隔離,使 lossless 類別不會因 best-effort 流量而資源匱乏。 | 全部 4 個 AI 平台 |
| PFC 死結看門狗 | 偵測並解除PFC pause死結或風暴狀況,是PFC後備機制的安全網。 | 全部 4 個,OcNOS 7.0 |
| DLB (動態負載平衡) | Spreads elephant RoCE flows that collide under static ECMP, targeting utilization above 90 percent on the same switches. | 全部 4 個 AI 平台 |
| 動態 ECN | 根據即時佇列狀況調整 ECN 標記,隨著負載變化減少人工重新調校。 | 僅限TH5,OcNOS 7.0 |
| DLB 反應式 / 隨機 | 用於實現更緊密流量分散的進階 DLB 放置模式。在 TH4 上,請使用標準 DLB。 | 僅限TH5,OcNOS 7.0 |
| GLB (Global Load Balancing) | 超越本地 DLB 決策的 fabric 全域負載平衡。 | OcNOS 7.1 |
| Ultra Ethernet | 採用 NIC 側重新排序並降低 PFC 依賴的 packet spray,這是通往 lossless AI Ethernet 的發展路徑。 | 執行於支援 UEC 的 NIC |
僅供參考。這些建議不會下發至任何裝置,此處也不會產生任何門檻值。可用性以 OcNOS-DC 為準。 功能矩陣 與 硬體相容性清單。請在部署前針對您所選的平台與 OcNOS 版本進行驗證。
fabric 功耗
經過規模測算的設計中,fabric 交換器的典型功率範圍。僅為範圍值,且為滿載光模組的情形。網路交換器僅佔叢集總功耗的一小部分,功耗主要由 GPU 主導。
散熱:後門散熱或直接液冷通常在每機櫃約 30 至 40 kW 以上時才會考量,這取決於 GPU 伺服器密度,而非網路。此為參考指引,並非計算得出的熱負載。交換器功耗範圍為已裝配光模組的 51.2T (Tomahawk 5) 與 25.6T (Tomahawk 4) 等級設備的典型值;請以各平台資料表中的確切數值為準。
相符的 OcNOS-DC 平台
該 fabric 在開放的 Broadcom Tomahawk 硬體上運行單一 OcNOS-DC 映像。以下是其設計所針對的受支援 800G 與 400G 平台。
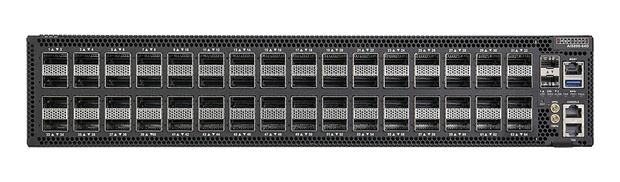
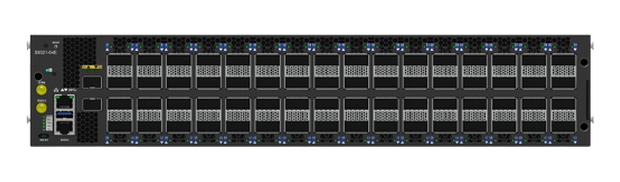
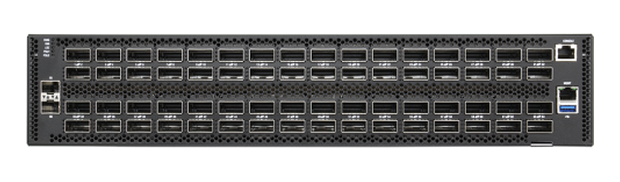
本工具僅提供供規劃用途的結構性網路設計估算。它不構成效能保證、物料清單或成本估算。實際設計取決於 rail 最佳化、每 GPU 的 NIC 數量、佈線以及故障網域的選擇。GPU 數量為依 Clos radix 計算得出的參考設計上限值,而非實測值。Broadcom 與 Tomahawk 為 Broadcom Inc. 的商標;其他名稱為其各自所有者的商標。
AI Fabric參考設計
取得參考設計 PDF:包含拓撲、交換器數量、元件彙總,以及一份 RoCEv2 lossless 初始設定檔。
AI Fabric參考設計
簡短表單:提交後 PDF 將立即開始下載。
✓ 正在新標籤頁中打開您的 PDF……
如果未能自動打開,請使用下方連結。
常見問題
如何為 GPU 叢集規劃 leaf-spine fabric 的規模?
什麼是rail-optimized拓撲?
一個 AI fabric 需要多少個光收發器?
對於 AI 而言,RoCEv2 與 InfiniBand 何者更優?
如何為 RoCEv2 打造 lossless 的 AI fabric?
同一套 OcNOS 映像是否可在 fabric 中的每台交換器上執行?
以 OcNOS 設計整套 AI 網狀架構
從商業論證到埠數計算,無論您的建置進行到哪個階段,都能從此接續。