Che cos'è uno switch per AI networking?
Uno switch per AI networking è uno switch Ethernet per data center ad alto radix, di solito a 400G o 800G per porta, che collega i server GPU nella fabric AI di back-end e mantiene lossless il traffico RDMA con PFC, ECN e load balancing dinamico, perché è il flusso più lento a determinare la durata di un job di training. IP Infusion sviluppa OcNOS-DC, il sistema operativo di rete che fa funzionare questi switch, e lo fornisce come sistemi completi e validati su piattaforme Broadcom Tomahawk 5 da 51,2 Tbps e su piattaforme da 25,6 e 12,8 Tbps.
Cosa rende uno switch per data center uno switch AI
Uno switch merita l'etichetta AI quando trasporta il traffico GPU alla velocità, alla scala e con il tasso di perdita richiesti da un cluster di training. Cinque proprietà lo distinguono. La rete formata da questi switch è trattata in Cos'è una fabric AI; questa pagina riguarda lo switch in sé.
- Velocità delle porte e capacità. Le NIC GPU si collegano a 400G e 800G, e la porta dello switch deve corrispondere. Uno switch da 51,2 Tbps offre 64 porte a 800G; uno switch da 25,6 Tbps offre 64 porte a 400G.
- Radix. Il numero di porte per switch determina quante GPU può servire un leaf e quanti leaf può collegare uno spine, e quindi quanti livelli richiede la fabric. Meno livelli significano meno hop, meno ottiche e meno energia.
- Trasporto lossless. Le GPU scambiano dati con RDMA over Converged Ethernet (RoCEv2), che rallenta bruscamente quando i pacchetti vengono persi. Lo switch necessita di Priority Flow Control (PFC) per mettere in pausa una coda prima che trabocchi e di Explicit Congestion Notification (ECN) per avvisare in anticipo i mittenti, in combinazione con il controllo della congestione DCQCN sulla NIC.
- Carico uniforme. Le operazioni collettive come AllReduce producono pochi flussi molto grandi. L'hashing statico può metterne due sullo stesso link mentre un altro link resta inattivo. Load balancing dinamico sposta il traffico verso percorsi meno carichi.
- Visibilità. Telemetria in streaming segnala la profondità delle code, le pause PFC e le marcature ECN in tempo reale, così gli operatori possono individuare l'unico link che rallenta un job.
Dove si collocano gli switch AI in una fabric di rete AI
Un data center AI gestisce quattro reti affiancate, e ognuna richiede qualcosa di diverso ai propri switch. La fabric GPU di back-end è ciò che la maggior parte delle persone intende per switch AI.
Fabric GPU di back-end
Collega le NIC GPU tra i server per training e inferenza. È costruita con leaf rail-optimized e uno spine Clos a 400G o 800G e funziona lossless end to end. È qui che velocità delle porte e radix contano di più.
Fabric di storage
Fornisce i dati di training ai server GPU e riscrive i checkpoint. Spesso anch'essa RoCEv2 , dimensionata per la banda sostenuta anziché per il numero di GPU.
Rete di front-end
Collega il cluster agli utenti, all'orchestrazione e al resto del data center. Un leaf-spine convenzionale, spesso con EVPN-VXLAN per tenere separati i tenant in un cloud GPU.
Gestione out-of-band
Una rete 1G separata per console, controller di gestione dei server e gestione degli switch, così gli operatori possono raggiungere ogni dispositivo quando i data plane sono occupati o fuori servizio.
All'interno della fabric di back-end, lo stesso modello di switch può fungere da rail leaf, spine o super-spine. Un design rail-optimized collega ogni NIC GPU di un server a un leaf diverso, così il traffico tra GPU dello stesso rank resta a un hop di distanza. È la topologia a definire il ruolo; Topologie di fabric AI e rete rail-optimized trattano questi design.
Gli switch AI sono acquistati da provider neocloud e cloud GPU, grandi data center enterprise e MSP, e service provider che aggiungono capacità GPU nei propri data center.
800G o 400G: dimensionare uno switch AI in base al radix
Il numero di porte dello switch determina fin dove cresce una fabric prima di richiedere un ulteriore livello. In un leaf-spine non bloccante a due livelli, ogni leaf divide equamente le sue porte tra GPU e spine, e ogni porta dello spine collega un leaf. Uno switch con k porte supporta quindi k al quadrato diviso due endpoint su due livelli, e k al cubo diviso quattro su tre livelli.
| Capacità dello switch | Porte a piena velocità | Due livelli, non bloccante | Tre livelli, non bloccante |
|---|---|---|---|
| 51,2 Tbps | 64 a 800G | 2.048 endpoint a 800G | 65.536 endpoint a 800G |
| 25.6 Tbps | 64 a 400G | 2.048 endpoint a 400G | 65.536 endpoint a 400G |
| 12.8 Tbps | 32 a 400G | 512 endpoint a 400G | 8.192 endpoint a 400G |
- Questi sono limiti aritmetici, non valori di scala dei prodotti. I design reali li modificano con l'oversubscription, i rail per server, la portata delle ottiche e la potenza del rack.
- 800G a parità di radix raddoppia la banda per GPU senza aggiungere un livello. Per questo le fabric di back-end costruite attorno a NIC 800G usano switch da 51,2 Tbps.
- I design di riferimento di IP Infusion per fabric rail-optimized a due e tre livelli, dimensionati in numeri reali di porte, si trovano su Topologie di fabric AI. La scelta tra i design è illustrata in come scegliere una fabric per AI networking.
Switch per data center AI qualificati per OcNOS-DC
OcNOS-DC è il sistema operativo di rete di IP Infusion per le fabric data center e AI. Gira su switch aperti basati su silicio Broadcom, e ogni piattaforma seguente è presente nella Elenco di compatibilità hardware OcNOS, che copre in totale oltre 40 piattaforme qualificate.
| Capacità | ASIC Broadcom | Piattaforme qualificate | Posizione tipica in un data center AI |
|---|---|---|---|
| 51,2 Tbps | Tomahawk 5 (BCM78900) | Edgecore AIS800-64D, UfiSpace S9321-64E, UfiSpace S9321-64EO | Leaf e spine di back-end a 800G; lo S9321-64EO trasporta anche DCI coerente tra i siti |
| 25.6 Tbps | Tomahawk 4 (BCM56990) | Edgecore AS9736-64D (DCS520) | Fabric di back-end, storage o front-end a 400G |
| 12.8 Tbps | Trident 4 (BCM56880) | Edgecore AS9726-32DB (DCS240), UfiSpace S9300-32D | Leaf a 400G per front-end e storage; compatibile IPoDWDM |
Cosa aggiunge OcNOS-DC allo switch
- RoCEv2 lossless: PFC, incluso PFC su underlay instradati Layer 3, rilevamento e ripristino dei deadlock PFC, ECN per DCQCN, e DCBX ed ETS per la banda per classe.
- Bilanciamento del carico: Dynamic Load Balancing (DLB) per la selezione del percorso basata sulla congestione, e Bilanciamento globale del carico (GLB) per l'ottimizzazione dei percorsi su tutta la fabric in OcNOS 7.1.
- Cloud GPU multi-tenant: EVPN-VXLAN tiene separati i tenant su una fabric condivisa. Sulle piattaforme Trident 3 X4, X5 e X7 e Trident 4, ECN e PFC over VXLAN segnalano inoltre la congestione attraverso l'overlay.
- Operazioni: telemetria in streaming su gNMI e OpenConfig, più NETCONF, YANG e zero-touch provisioning.
- Licenze e supporto delle piattaforme: DLB, rilevamento e ripristino dei deadlock PFC ed ECN over VXLAN sono funzionalità del livello OcNOS-DC PLUS, e il supporto varia a seconda della piattaforma. La Matrice delle funzionalità OcNOS elenca ogni funzionalità per piattaforma e livello.
- Rete di gestione: Le piattaforme 1G Trident 3 X2 (Edgecore AS4625-54T, Celestica DS1000 e UfiSpace S6301-56ST, 120 Gbps ciascuna) gestiscono la rete out-of-band con lo stesso NOS.
Cosa offrono gli switch AI aperti e cosa richiedono
Gli switch aperti con un sistema operativo di rete separato cambiano dove si collocano le scelte e dove si colloca il lavoro.
Cosa si ottiene
- Scelta dell'hardware. OcNOS-DC gira su switch di più produttori di hardware, quindi ogni piano può essere scelto in base a capacità, ottiche e tempi di consegna.
- Un unico NOS su tutti i piani. Le reti di back-end, storage, front-end e gestione usano un unico sistema operativo, un'unica CLI e un unico modello di automazione.
- Ethernet standard. Una fabric RoCEv2 usa le stesse ottiche, gli stessi cablaggi e gli stessi strumenti del resto del data center, e la NIC GPU viene scelta separatamente dallo switch.
- Un percorso verso nuovo silicio. Passare da 25,6 a 51,2 Tbps cambia lo switch, non il modello operativo.
Cosa richiede
- Integrazione. L'Ethernet lossless funziona solo quando i buffer dello switch, PFC, ECN e il controllo della congestione della NIC sono regolati insieme. Qualcuno deve eseguire questa regolazione e risponderne.
- Modello di supporto. Con hardware e software di aziende diverse, l'operatore ha bisogno di un unico responsabile chiaro quando un guasto attraversa il confine tra i due.
- Onere di validazione. Ottiche, cavi, firmware delle NIC e release del NOS cambiano ciascuno nel tempo, e ogni combinazione va testata prima della produzione.
OcNOS Systems risolvono questi tre punti fornendo lo switch e OcNOS-DC come un unico sistema completo e validato, pronto al deployment, con le combinazioni supportate di piattaforme e funzionalità pubblicate nella Hardware Compatibility List e nella Feature Matrix.
Tre modi per acquistare switch per data center AI
Il silicio dello switch è spesso lo stesso tra le opzioni. Cambia chi sceglie il software, chi integra i componenti e chi si fa carico dei test.
| Domanda | Switch e NOS integrati di un unico produttore | Switch aperto auto-integrato | Sistema aperto validato |
|---|---|---|---|
| Scelta dell'hardware | I modelli proprietari del produttore | Qualsiasi switch aperto scelto dall'acquirente | Switch aperti presenti nell'HCL di OcNOS |
| Sistema operativo di rete | Vincolato all'hardware | Scelto e installato dall'acquirente | OcNOS-DC, qualificato su quella piattaforma |
| Chi integra e testa | Il produttore | L'acquirente | IP Infusion qualifica la combinazione di piattaforma e NOS |
| Scelta della NIC GPU | Varia a seconda del produttore | Qualsiasi NIC che supporti RoCEv2 | Qualsiasi NIC che supporti RoCEv2 |
| Dove si concentra l'impegno | Basso impegno di integrazione, scelta più limitata | Massimo impegno di integrazione, scelta più ampia | Integrazione svolta in anticipo, scelta all'interno dell'HCL |
| Passaggio a nuovo silicio | Quando il produttore lo rilascia | Quando l'acquirente lo ha validato | Quando la piattaforma viene aggiunta all'HCL |
FAQ sugli switch per AI networking
Che cos'è uno switch AI?
Qual è lo switch migliore per l'AI?
Servono switch 800G per l'AI, o bastano 400G?
Che cos'è uno switch per fabric GPU?
Gli switch AI hanno bisogno di deep buffer?
Una fabric di rete AI può usare Ethernet invece di InfiniBand?
Quali switch supporta OcNOS per le fabric AI?
Approfondimenti sulle fabric AI e open networking
Architettura della fabric AI
Ogni piano di un data center AI e il relativo hardware.
Che cos'è uno switch whitebox?
Il modello di hardware aperto alla base degli switch AI.
Che cos'è un sistema operativo di rete?
Il software che trasforma il silicio in una fabric.
Che cos'è la disaggregazione di rete?
Acquistare separatamente lo switch e il suo software.
Approfondite. Portatelo con voi.
Due download brevi e tecnici che vanno oltre questa pagina: il datasheet completo di OcNOS-DC e l'architettura della fabric AI lossless a 800G.
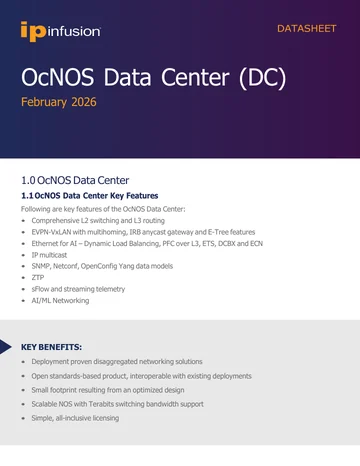
Datasheet OcNOS-DC
Specifica completa di OcNOS-DC: il set di funzionalità EVPN-VXLAN e Ethernet for AI, gli SKU software, le piattaforme hardware supportate e la guida all'ordine della soluzione.
Ottieni il datasheet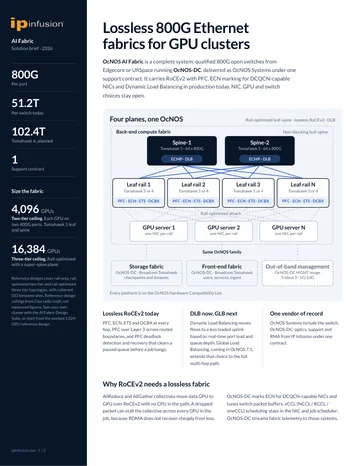
Fabric AI senza perdite OcNOS 800G
Fabric RoCEv2 lossless su spine Tomahawk 5: livelli di SKU, piattaforme qualificate e architettura di deployment.
Scarica il briefDatasheet OcNOS-DC
Modulo rapido. Il vostro PDF si apre in una nuova scheda subito dopo l'invio.
✓ Apertura del vostro PDF in una nuova scheda…
Se non si è aperto, usate il link qui sotto.
Fabric AI senza perdite OcNOS 800G
Modulo rapido. Il vostro PDF si apre in una nuova scheda subito dopo l'invio.
✓ Apertura del vostro PDF in una nuova scheda…
Se non si è aperto, usate il link qui sotto.
State scegliendo switch per un cluster GPU? Partite dal numero di GPU.
Indicateci il numero di GPU, la velocità delle NIC e l'oversubscription accettabile. Un ingegnere di IP Infusion dimensionerà gli stadi leaf, spine e super-spine su switch qualificati con OcNOS-DC.